
 语音小管家
NeurIPS(Neural Information Processing Systems)是每年十二月举行的机器学习与计算神经科学国际会议。会议汇集了来自学术界和工业界的顶尖研究人员,领域涵盖机器学习、神经网络、认知科学、计算机视觉,统计语言学,信息论等多个方向,在人工智能和计算机科学领域与ICLR 和 ICML并列三大最具影响力的学术会议之一。今年NeurIPS 2025共接受了21575篇投稿,录取率24.52%。听觉认知与计算声学听觉认知与计算声学实验室共有3篇论文被录用,我们将在本期为大家介绍在语音翻译实时同传的相关工作。
同步语音翻译(Simultaneous Speech Translation, SimulST)通过在严格的延迟约束下联合优化语音识别与机器翻译,实现跨语言的实时通信。现有系统在翻译质量、延迟和语义连贯性之间难以取得良好平衡,尤其在多语种、多方向(many-to-many)场景中,不同语言对所需的读/写策略差异阻碍了统一策略的学习。本文提出 SimulMEGA(Simultaneous Generation by Mixture-of-Experts Gating),一种无监督策略学习框架,通过结合基于前缀(prefix-based)的训练与混合专家(Mixture-of-Experts, MoE)精炼模块,以隐式方式学习高效的读/写决策,且在推理阶段不引入任何额外开销。该方法仅需对标准 Transformer 架构进行极小改动,即可通用于语音到文本(S2TT)和文本到语音(TTS)两类流式生成任务。在涵盖六种语言的全面评估中,我们 5 亿参数的语音到文本模型显著优于 Seamless 基线:在平均延迟 1.5 秒时 BLEU 退化小于 7%,在 3 秒延迟时退化小于 3%。我们进一步将该方法扩展至流式 TTS 任务,基于单向骨干网络实现更优的延迟–质量权衡。
SimulMEGA: MoE Routers are Advanced Policy Makers for Simultaneous Speech Translation
作者列表:Chenyang Le, Bing Han, Jinshun Li, Songyong Chen, Yanmin Qian
合作单位:上海交通大学
论文原文:https://arxiv.org/abs/2509.01200
在跨国会议、直播同传、智能耳机等真实场景中,实时语音翻译(Simultaneous Speech Translation, SimulST)需要在翻译质量、延迟控制与语义连贯性之间取得精细平衡——尤其在多语种、多方向的复杂场景下,这一挑战更为严峻。
现有方法往往依赖人工设计的读写策略(如 wait-k、单调注意力等),难以泛化到多样化的语言对,且常以牺牲质量换取低延迟。针对这一瓶颈,本文提出 SimulMEGA(Simultaneous Generation by Mixture-of-Experts Gating)——一种无需推理开销的无监督策略学习框架。
SimulMEGA 的核心思想是:利用 Mixture-of-Experts(MoE)。训练时,模型同时看到完整语音和随机截断的前缀语音,并通过一个“全局专家”与“前缀专家”的对比,隐式学习何时应继续等待输入、何时可以安全输出。推理时,全局专家被移除,仅保留前缀路径,实现零额外计算开销的流式翻译。
SimulMEGA 不仅推动了多语种实时翻译的实用化,更为流式生成任务提供了一种通用、轻量、可迁移的新范式。
无监督策略学习:无需人工策略或对齐监督,让模型自己摸索最优读写节奏;
零推理开销:MoE 模块仅用于训练,部署时完全移除;
架构通用:可适配任何 Transformer-based 的 S2T 或 TTS 模型;
多语种强泛化:一套系统覆盖 6 语种 30 方向,实用性强;
工程友好:训练分两阶段,支持 LoRA 微调,资源消耗可控。
SimulMEGA 的最大亮点在于:既不是固定性策略(如wait-k),也不依赖人工设计的策略(比如用大模型做语义切割大标签),而是通过一种无监督的 MoE 路由机制隐式学习“读/写”决策。
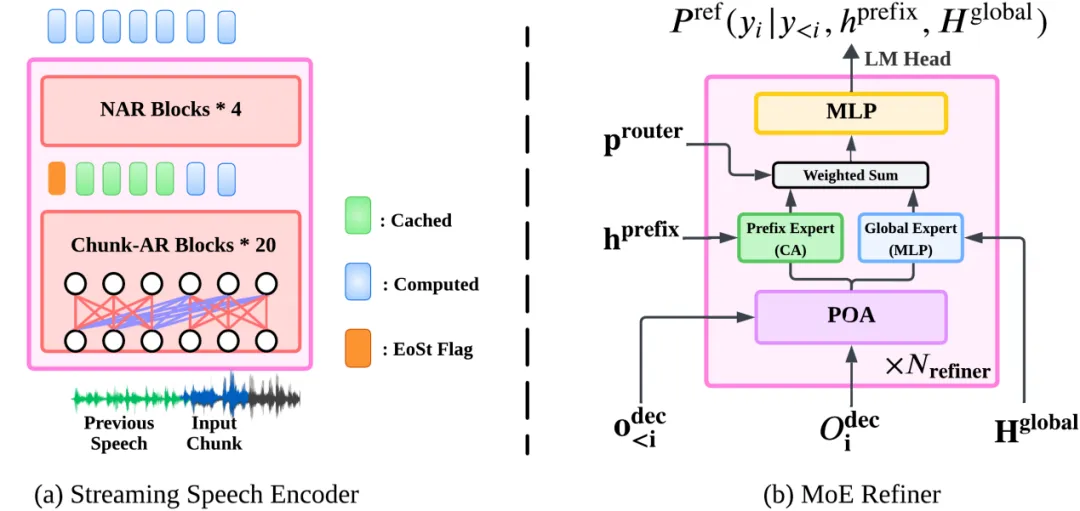
(a) SimulMEGA 流式语音编码器的结构和推理示例。(b) MoE Refiner的结构,其中自注意力模块被先前输出注意力 (POA) 模块取代,以防止全局信息泄露。
SimulMEGA 仅需对标准 Transformer 做极小改动:
在解码器后接一个路由器模块以及MoE Refiner 模块(仅训练时启用);
编码器采用 Chunk-AR + NAR 混合结构,兼顾效率与上下文。
这意味着:你可以用任何现成的离线语音翻译模型(如 Whisper或Seamless离线模型)作为基座,轻松升级为 SimulST 系统。
SimulMEGA 的关键在于“MoE Refiner”模块。这一模块包含两个“专家”:
Prefix Expert:只看到前缀,擅长处理局部信息;
Global Expert:看到完整句子(经压缩),提供全局语义。
路由器(Router)会根据当前解码位置,动态决定信任哪个专家。如果它更倾向 Global Expert,说明当前前缀信息不足——这时就不该输出,而应继续等待输入。因此,路由器对 Global Expert 的偏好程度,天然反映了“是否该继续等待”的决策。
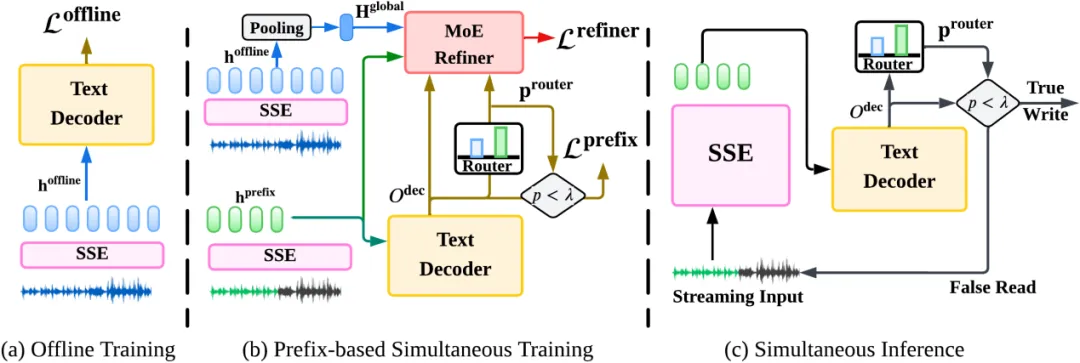
SimulMEGA 的训练和推理概述
在流式训练时,Text Decoder 接受前缀语音输入,而MoE Refiner同时接受前缀语音输入和压缩后的全局语音输入。MoE Refiner将会混合两种输入,预测完整的翻译标签,并帮助路由器学习读写策略。
而到了推理阶段,MoE Refiner 直接被移除(因为路由器做出判断并不依赖于MoE Refiner。)这也模型相比离线模型几乎没有额外的推理开销。然后,在每一步的推理时,只要路由器试图“调用”Global Expert的倾向高,系统就知道:输入还不够,别急着说!
SimulMEGA 的通用性不止于此。作者将其扩展到 流式文本到语音(Streaming TTS)任务,基于 CosyVoice 2 构建了 SimulMEGA-TTS。流式TTS的训练策略与之前的语音翻译任务完全相同,这展现出了SimulMEGA 对于不同架构以及任务极强的兼容性。
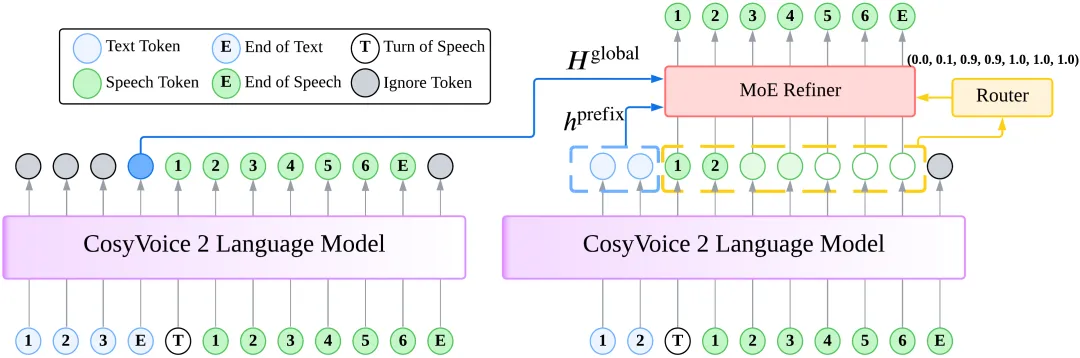
SimulMEGA-TTS训练图示
6 种语言,30 个方向,全面领先
⏩流式语音到文本翻译
作者在CoVoST2和FLEURS两大基准上,评估了 EN、ZH、DE、ES、FR、IT 六语种间的 30 个翻译方向。
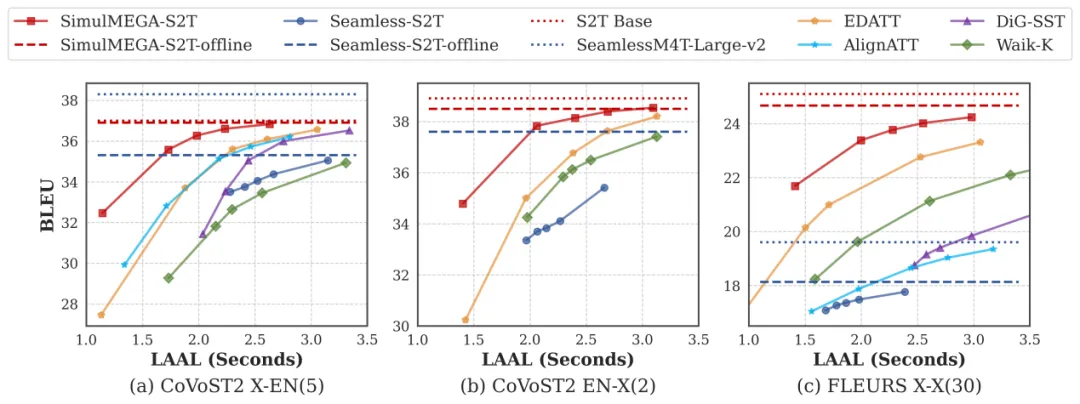
多语言流式语音到文本翻译质量(BLEU)与延迟指标(LAAL)在不同测试集上的表现
结果惊人:
在 1.5 秒平均延迟(AL)下,相比离线模型BLEU 仅下降 <7%;
在 3 秒延迟下,BLEU 退化 <3%,几乎逼近离线模型;
全面超越 Meta 的 SeamlessM4T(参数量却是其 1/3!)。
更令人惊喜的是,同一套超参、同一阈值,即可通用于所有语言对,无需为每种语言单独调参。
⏩流式语音合成与流式语音到语音翻译(级联系统)
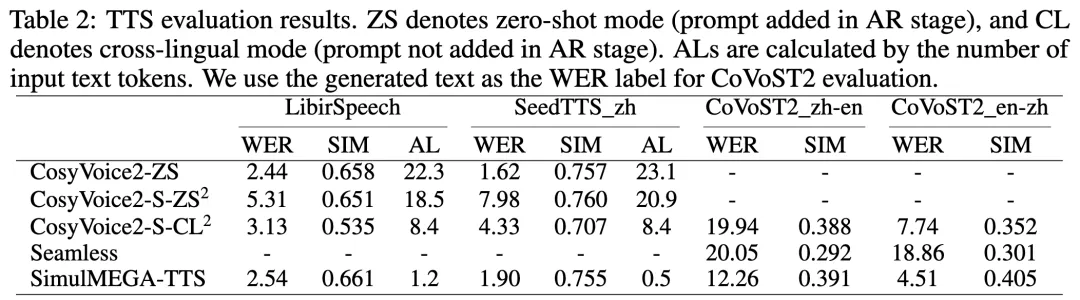
流式语音合成结果:
流式语音合成TTS评估结果。ZS表示零样本模式,CL表示跨语言模式(在AR阶段不添加提示)。AL值根据输入文本标记的数量计算。
流式语音到语音翻译结果:
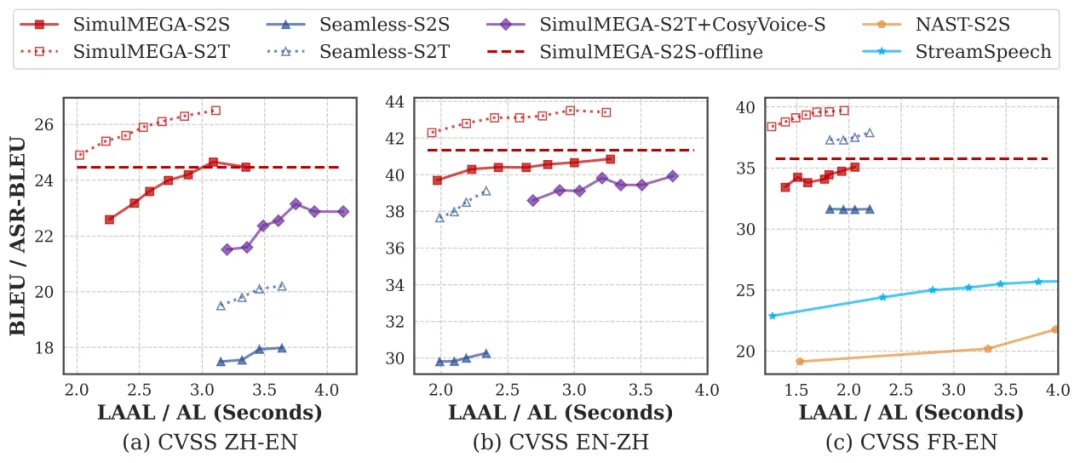
流式语音到语音翻译质量(BLEU)与延迟指标(AL)在CVSS测试集上的表现
SimulMEGA-TTS比起CosyVoice 2 交替生成的流式方法,延迟显著下降,错误率(WER)降低;
与 SimulMEGA-S2T 串联,构建出完整的 “实时语音到语音翻译系统”(S2ST),端到端延迟仅增加约 200ms。
SimulMEGA 用一个看似简单的 idea —— “让 MoE 路由器在 prefix 与 global 之间抉择” —— 巧妙地将策略学习问题转化为专家选择问题,实现了高质量、低延迟、多语种兼容的同步语音翻译。正如作者所说:“MoE 路由器不仅是模型的开关,更是高级策略制定者。”这项工作不仅推动了 SimulST 的实用化,也为“流式生成任务”(如流式 TTS、实时对话)提供了新范式。
[1] Barrault L, Chung Y A, Meglioli M C, et al. Seamless: Multilingual Expressive and Streaming Speech Translation[J]. arXiv preprint arXiv:2312.05187, 2023.
[2] Du Z, Wang Y, Chen Q, et al. Cosyvoice 2: Scalable streaming speech synthesis with large language models[J]. arXiv preprint arXiv:2412.10117, 2024.
[3] Radford A, Kim J W, Xu T, et al. Robust speech recognition via large-scale weak supervision[C]//International conference on machine learning. PMLR, 2023: 28492-28518.
[4] Papi S, Negri M, Turchi M. Attention as a guide for simultaneous speech translation[C]//Proceedings of the 61st Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers). 2023: 13340-13356.
[5] Papi S, Turchi M, Negri M. Alignatt: Using attention-based audio-translation alignments as a guide for simultaneous speech translation[J]. arXiv preprint arXiv:2305.11408, 2023.
供稿:乐辰阳,编辑:方楠,审核:钱彦旻
