
 语音小管家
语音匿名化(Voice Anonymization)旨在在保留语义和情感信息的同时去除说话人的身份特征。现有基于深度学习的主流方法通常依赖显式说话人嵌入模型(Speaker Embedding Model)来提取和替换说话人特征,但这类方法存在外部依赖强、容易引入偏差与隐私泄露风险,以及特征耦合严重、难以在保持语音内容与情感特征的同时彻底去除说话人特征等问题。
近年来,“去说话人嵌入”(Speaker-Embedding-Free)的方法逐渐受到关注,该类方法不依赖外部说话人嵌入模型,而是利用自监督语音模型(SSL)提取待匿名语音的内部特征,并通过目标特征替换实现语音匿名化。主流方法多采用kNN[1][2] 算法进行特征替换,但由于SSL特征中仍包含音素和韵律等与身份相关的信息,匿名效果有限。
针对这一问题,昆山杜克大学联合日本国立情报研究所提出了基于多K-Means量化的去说话人嵌入语音匿名化系统(SEF-MK)。该方法在不同说话人子集上分别训练多个K-Means模型,并在匿名化阶段随机选择其中一个模型对自监督特征进行量化替换,从而增加特征空间的不确定性与多样性,有效降低说话人信息泄露的风险。实验结果表明,与单一K-Means方法相比,SEF-MK在保持语音语义与情感特征的同时实现了更高水平的隐私保护,展现出语音匿名化的新方向。
论文:SEF-MK: Speaker-Embedding-Free Voice Anonymization through Multi-k-means Quantization
作者:唐贝隆,苗晓晓,王鑫,李明
论文:
Demo和代码:
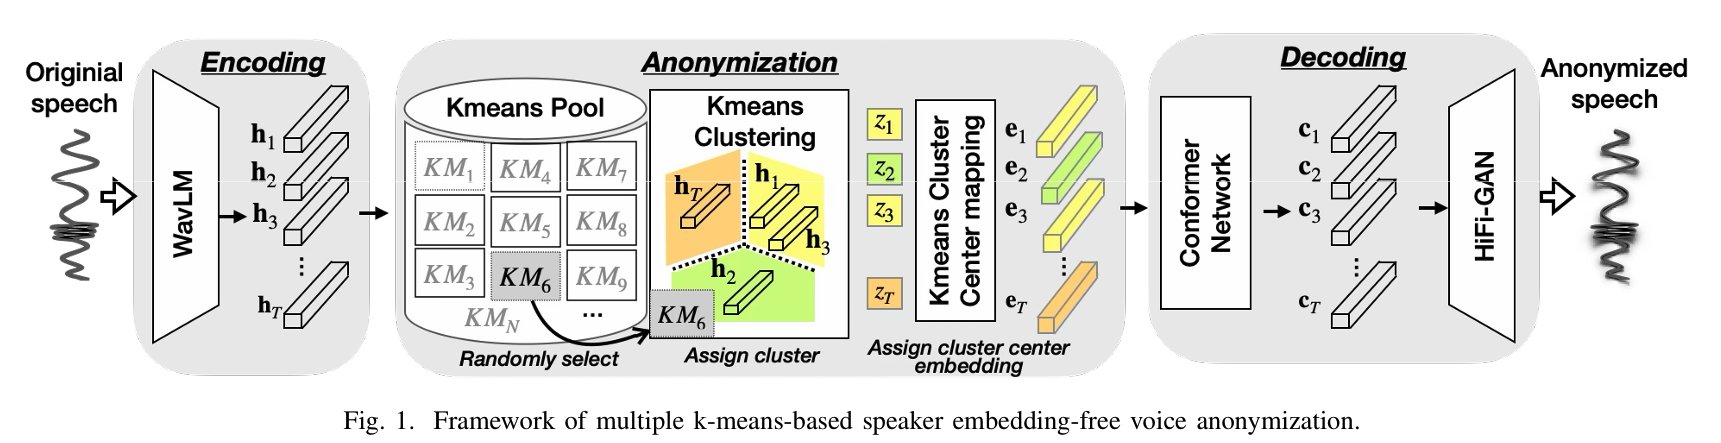
SEF-MK提出一种不依赖说话人嵌入的语音匿名化方案:
特征编码阶段(Encoding):采用自监督模型WavLM 提取帧级语音表示,捕获语音中的完整声学与语义信息;
匿名化阶段(Anonymiation):旨在保留内容信息的同时隐式去除说话人特征。已有研究表明[3],将连续型SSL 特征通过单一 k-means 模型离散化,可以有效削弱说话人信息,但也会在一定程度上损害语音内容的完整性。为在内容与匿名性间取得平衡,本文提出多k-means(Multi-KMeans)策略:
训练多个K-Means量化器,每个量化器在不同说话人子集上独立学习,即“多K-Means”思想;
在推理阶段随机选择一个量化器,将语音特征映射到对应质心序列。
这种做法的动机在于不同子集训练得到的K-Means 模型倾向于捕获不同的说话人集合的特征分布,从而能将原始说话人映射为多个潜在的“匿名说话人”,实现更加多样化和难以追踪的匿名化效果。
匿名语音生成(decoding)阶段:最后通过Conformer解码器+HiFi-GAN声码器重构匿名语音。
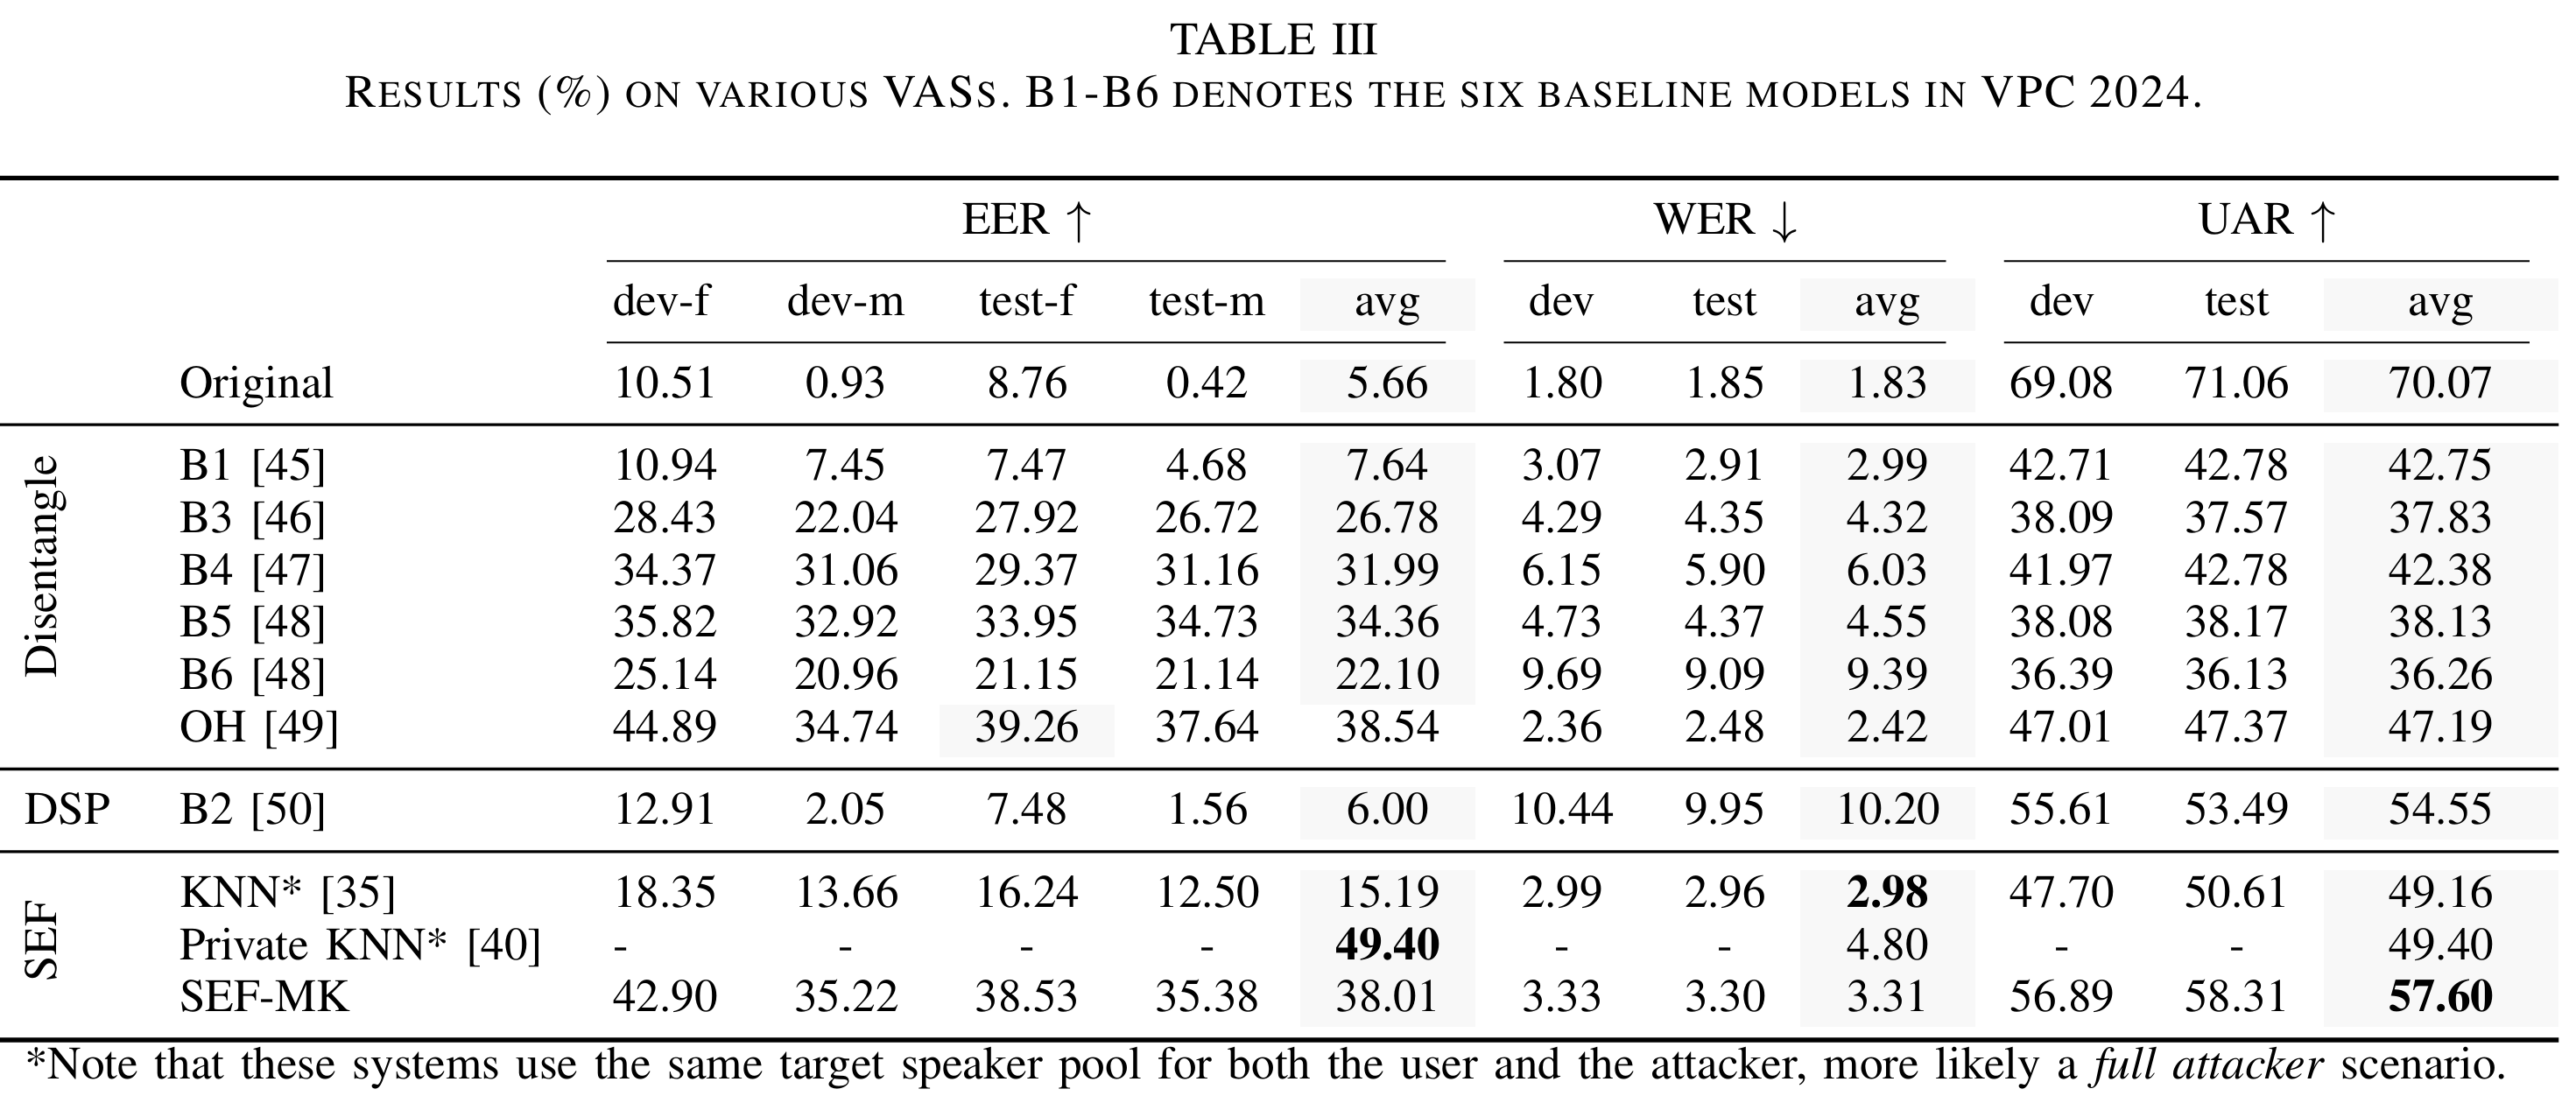
团队在VoicePrivacy Challenge 2024 [4]的评测框架下进行了系统对比:
隐私性(EER↑):相比单一K-Means或基线系统,SEF-MK显著提高匿名强度;
语音可懂度(WER↓)与情感保持(UAR↑):多K-Means设计能在隐私与可用性之间取得良好平衡;
组规模影响:K-Means若基于中等规模(如20个说话人)的数据训练,能获得最优隐私。
[1] M. Baas, B. van Niekerk, and H. Kamper, “Voice conversion with just nearest neighbors,” in Proc. Interspeech, 2023, pp. 2053–2057
[2] C. Franzreb, A. Das, T. Polzehl, and S. M¨oller, “Private knn-vc: Interpretable anonymization of converted speech,” in Proc. Interspeech, 2025
[3] X. Miao, X. Wang, E. Cooper, J. Yamagishi, and N. Tomashenko, “Language-independent speaker anonymization approach using self-supervised pre-trained models,” in Proc. The Speaker and Language Recognition Workshop (Odyssey 2022), 2022, pp. 279–286.
[4] N. Tomashenko, X. Miao, P. Champion, S. Meyer, X. Wang, E. Vincent, M. Panariello, N. Evans, J. Yamagishi, and M. Todisco, “The VoicePrivacy 2024 challenge evaluation plan,” arXiv preprint arXiv:2404.02677, 2024
