
 语音小管家
为了更好地推动语音对话与听觉处理领域的深入交流与前沿研究,由中国计算机学会(CCF)语音对话与听觉专委会发起的第二届语音对话与听觉处理前沿进展研讨会(RASDAP2025,Recent Advances on Speech Dialogue and Auditory Processing)于2025年6月14日在武汉大学计算机学院顺利举办。
本次研讨会在上海交通大学俞凯教授、中国科学技术大学凌震华教授、武汉大学涂卫平教授、语音之家CEO卜辉等的共同组织下,邀请了西北工业大学谢磊教授、上海交通大学钱彦旻教授、武汉大学黄公平教授、香港中文大学(深圳)武执正副教授、南京大学卢晶教授、中科院声学所李军锋研究员、张鹏远研究员、中国科学技术大学张结副教授、北京科技大学钱馨园副教授、南京大学王帅副教授等国内语音技术领域专家,通过12场技术引导报告与2场分组(7个小组)讨论,系统性梳理了生成式与鉴别式语音增强的技术路径、目标说话人提取的挑战及工业落地瓶颈。同时还针对NCMMSC 2025特殊议题、未来赛事、CCF进展报告以及未来基金项目指南进行了广泛且深刻的探讨。
研讨会延续“小规模、精品化、深度聚焦”的特色,为学术界与产业界搭建了高效对话平台。RASDAP这种小规模、精品化、主题高度聚焦形式的研讨会对团结和组织我国语音、对话与听觉相关领域的专业人士开展学术交流活动,强化各研究方向的融合,促进学术界与工业界的合作,提升我国语音、对话与听觉领域的科研、教学、应用水平以及国内国际影响力具有重要意义。
1. 引导发言/Introductory Talks
1)谢磊: 生成式语音增强技术
西北工业大学谢磊老师在引导发言中讲述了近期四个在生成式语音增强领域的突破性成果。主要包括四个关键技术创新:1) SELM框架首次将语言模型引入语音增强,通过离散标记化处理实现噪声到干净语音的转换,在DNS Challenge测试集上获得了优异表现;2) GenSE采用分层建模策略,通过N2S和S2S双阶段生成过程结合Token Chain Prompting机制,显著提升了语义保持能力;3) LLaSE-G1基于LLaMA架构构建通用增强框架,其双通道设计巧妙解决了多任务中参考信号的角色冲突问题,在噪声抑制、丢包补偿等五项任务上均达SOTA水平;4) FlowSE创新性地采用流匹配技术,通过ODE求解实现高效生成,推理速度较传统扩散模型提升10倍。这些工作共同推动了语音增强技术向更智能、更通用、更高效的方向发展,为实时通信、智能设备等应用场景提供了创新解决方案。
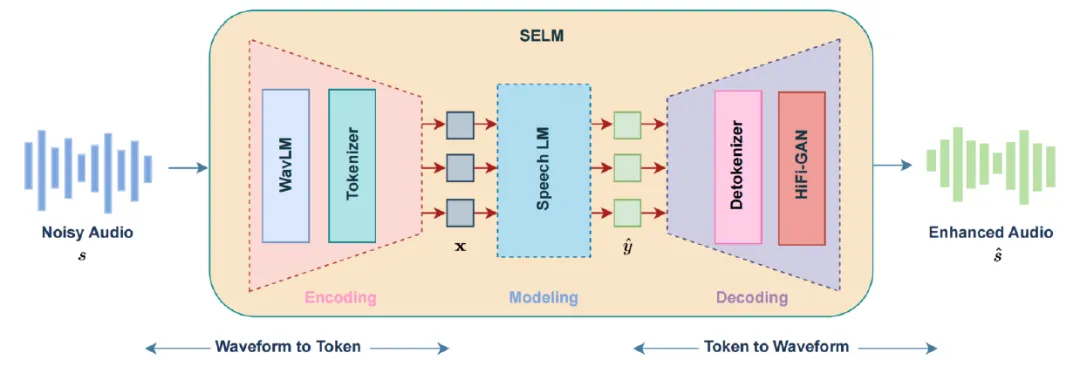
图1 谢磊老师团队提出的SELM框架
谢老师指出,当前生成式语音增强技术面临的核心挑战包括:1)推理效率低(如Diffusion模型需数百步迭代,难以实时,现有加速方法存在精度与效率权衡)、2)语音保真度与说话人一致性不足(LM+Codec方法因量化误差导致音质失真和说话人特征丢失,Diffusion模型在极端噪声下易生成失败或伪音)、建模框架碎片化(依赖堆叠模块如编码器-生成器-声码器分离,缺乏端到端统一优化目标)、3)文本信息利用不充分(语音-文本对齐能力弱,语义引导未充分发挥,低信噪比下效果有限)以及4)模型训练代价高且泛化能力弱(复杂模型训练资源消耗大,对噪声分布、语种变化等分布漂移敏感)。针对这些挑战,未来技术发展可以聚焦于:革新高效生成范式(探索单步/少步推理模型以实现实时增强)、强化保真度与说话人保持能力(引入多模态监督、感知损失函数增强音色/韵律细节,结合说话人嵌入与一致性约束提升个性还原)、深化语言-文本联合建模(充分利用文本信息进行条件生成或Prompt引导,加强低信噪比下的鲁棒对齐)、构建端到端统一框架(开发无编码器的一体化模型,同步优化增强/识别/合成等多任务目标,减少对专用组件如手工声码器、对齐器的依赖)以及提升通用性与自适应能力(支持多语种/多说话人/远场等复杂场景,融合自监督表示、增量学习等策略增强跨场景鲁棒性和泛化能力)。
最后,谢老师指出生成式语音增强需着力突破效率-精度瓶颈,通过推动端到端统一建模、深度整合文本条件信息、优化说话人感知能力三大路径,最终实现高质量实时增强,并显著提升在多样化实际场景中的适应性和实用性。
2)武执政:生成式多任务统一语音增强与目标说话人提取
香港中文大学(深圳)武执政老师在引导发言中讲述团队在生成式多任务统一语音增强与目标说话人提取领域取得的重要突破,其核心创新AnyEnhance模型通过prompt-guidance机制和self-critic架构,实现了去噪、去混响、削波修复、超分辨率和目标说话人提取五大任务的统一建模。
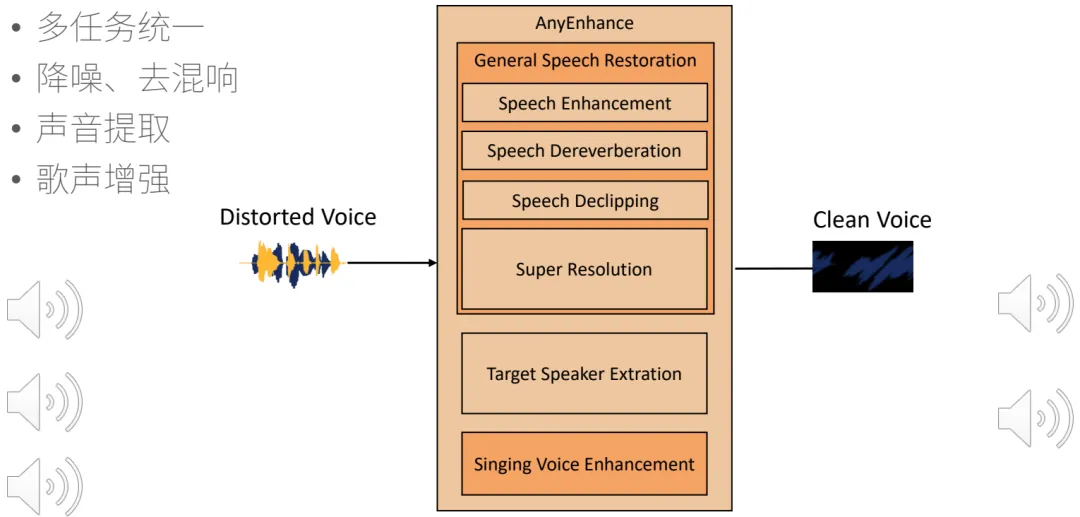
图2 武执政老师团队提出的AnyEnhance模型框架
该模型在44.1kHz采样率下支持说话人prompt输入且无需微调,显著优于Voicefixer、MaskSR等现有多任务模型。团队进一步提出的Metis基座模型则更进一步,基于掩码生成式Transformer(Masked Generative Transformer) 实现跨模态统一建模,可同时处理语音合成(TTS)、语音转换(VC)、目标说话人提取(TSE)、语音增强(SE)、唇语转语音(Lip2Speech)等任务,支持文本、波形、视频等多模态条件输入。这种统一架构显著降低了系统复杂性,减少传统方案中专用组件(如独立声码器或对齐器)的依赖,同时通过预训练-微调范式提升跨任务泛化能力。
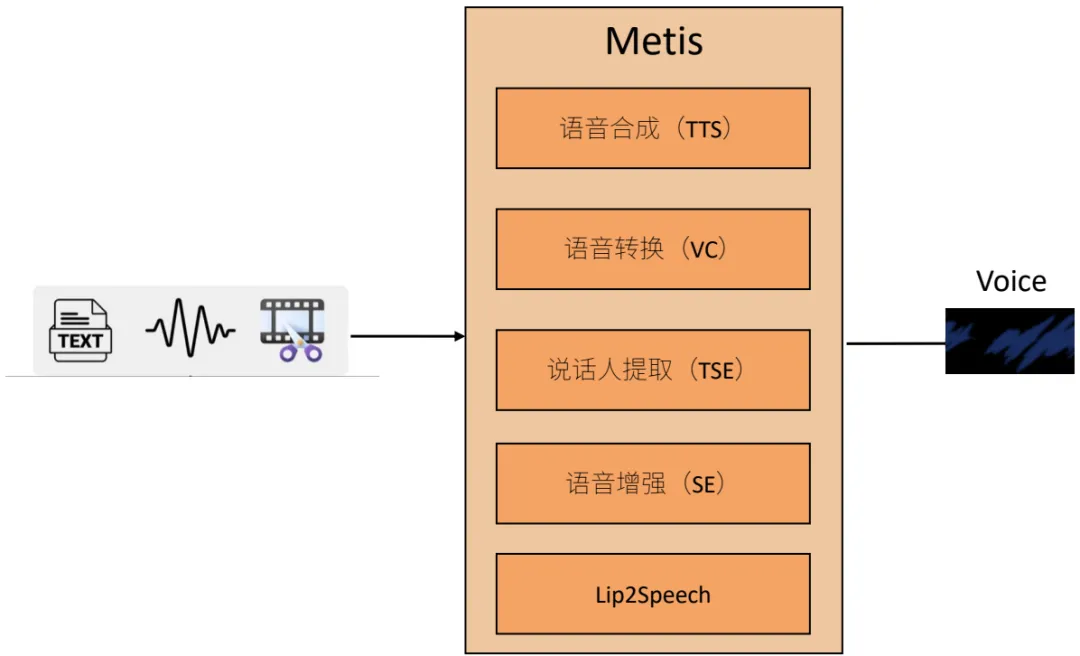
图3 武执政老师团队提出的Metis基座模型框架
武老师特别强调了Zero-Shot能力对说话人提取/增强的突破性价值:利用提示工程实现无需目标说话人样本的自适应处理,并指出当前面临的关键挑战包括:生成式语音质量的评价指标需革新以超越传统信噪比标准、统一模型在端侧部署需平衡参数量与效率(大模型与小模型协同)、以及通过噪声规模化(Scaling noises)技术增强复杂场景鲁棒性。该方向标志着语音处理从“专用模块堆叠”向“生成式统一智能体”的范式转变。另外,武老师指出,他们近期研究发现歌曲的增强比语音增强更难,失真更严重。
3)李明:融合生成式语言模型的广义目标人语音提取
武汉大学李明老师在报告中介绍了团队在融合生成式语言模型的广义目标人语音提取领域取得的重要突破,其研究涵盖了鉴别式和生成式两种技术路线。在鉴别式方法方面,李老师团队提出的USEF-TSE框架实现了无需说话人嵌入的目标语音提取,并在第三届国际视听语音增强挑战赛(AVSEC-3)中获得Track 1冠军。在生成式方法方面,李老师团队开发的LauraTSE模型通过结合自回归解码器(AR Decoder-only)和编码器(Encoder-only)的双路径架构,在Libri2Mix测试集上取得了优异效果,同时支持流式推理。研究深入探讨了目标人语音提取任务的核心问题,包括如何有效利用上下文语义信息、设计适合生成式方法的评价指标,以及处理多模态注册信息(声纹、人脸、唇动等)的技术挑战,为构建更鲁棒、更通用的语音提取系统提供了重要理论基础和技术方案。
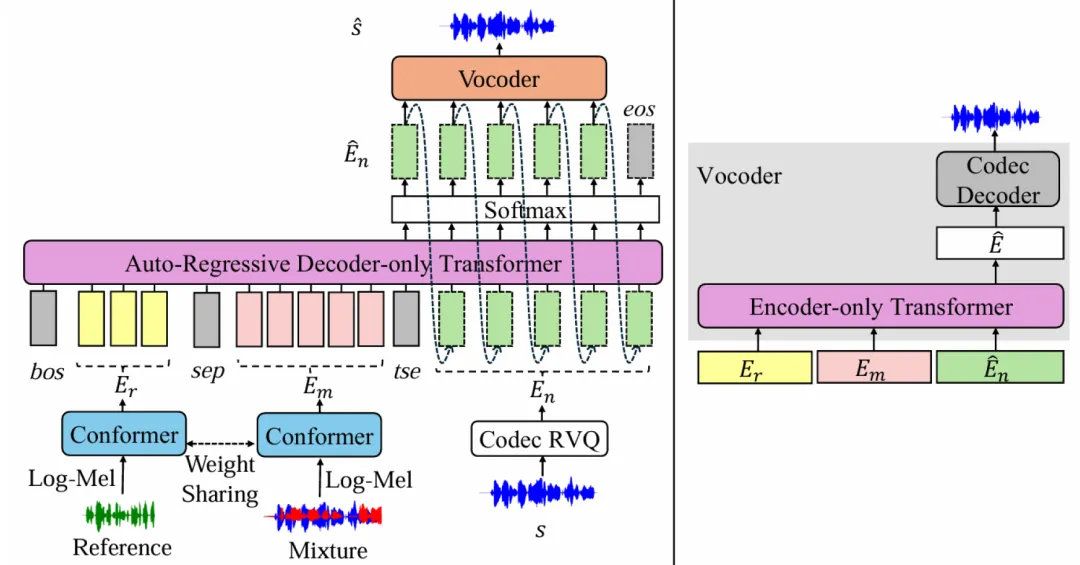
图4 李明老师团队开发的LauraTSE模型
李老师在报告中提出以下核心观点:传统鉴别式方法虽具实时性与轻量化优势(如基于声学层建模的直接语音分离),但其依赖大量标注数据、未知场景鲁棒性差,且忽视语义信息的致命缺陷难以满足实际需求;相比之下,生成式方法通过建模语音数据分布直接生成目标语音,在复杂场景保真度、多模态融合潜力(如接入文本上下文语义)及广义信息兼容性上展现突破性价值,但面临计算成本高、生成不稳定及评价体系缺失等挑战。
针对目标语音提取“为人耳服务”的本质,李老师强调需重构评价体系:客观指标需突破传统信噪比局限(因生成语音具有不可复制的独特性),主观评测应专门设计以反映听觉感知质量,同时需解决多模态注册信息动态漂移(如声纹时变、人脸间歇缺失)对系统的影响。在技术路径上,他提出生成式语言模型的三重优化方向:1. 架构选择:优先采用Decoder-only LM架构支持端侧实时处理,以连续语音表征为输入提升语义融合能力,以离散表征为输出提升效率;2. 副语言信息处理:构建高效流式属性识别模块,在离散表征基础上解析情感/语调等隐含特征,并通过训练损失函数约束属性一致性;3. 鲁棒性提升:双轨并行——大语言模型+海量数据训练实现多任务通用分离,小模型+场景定制化数据专攻因果实时性能。
最后,李老师指出广义目标提取需向多模态协同范式演进:整合声纹、人脸、唇动、方位、文本描述及关键词等跨模态线索,推动语音处理从“声学分离”迈向“语义驱动的智能听觉重建”。
4)王帅:目标语音提取中上下文信息的重要性思考
南京大学王帅老师在报告中介绍了他团队在目标语音提取中的上下文信息建模方面取得的重要突破,其研究聚焦于超越传统说话人嵌入(Speaker Embedding)的细粒度表征方法。团队提出的多级说话人表征框架通过显式考虑上下文信息,实现了对语音时频域特征的细粒度挖掘,有效解决了传统说话人嵌入面向说话人绝对区分能力过度优化,导致在目标语音提取任务中存在的“次优”问题。研究创新性地从模型设计和训练准则两个维度加强上下文建模能力:在模型层面,采用细粒度表征(STFT、帧级别特征等)实现说话人特性与内容动态的结合;在训练层面,引入句级别监督信号和上下文感知的知识引导机制。团队开发的WeSpeaker和WeSep工具包为相关研究提供了灵活、可扩展的技术支持,其最新工作Real-T数据集进一步推动了面向真实对话场景的目标语音提取研究。这些成果为目标语音提取任务中的上下文信息利用提供了新的理论框架和技术资源。
王老师在报告中系统性地指出:当前目标语音提取(TSE)任务的核心瓶颈在于传统说话人嵌入对细粒度特征的过度压缩,导致时/频域动态信息(如语调起伏、情感变化、内容关联性)大量丢失,严重制约复杂场景下的提取精度。为此,团队提出三重革新路径:1)细粒度表征重构:采用帧级STFT谱等底层特征替代压缩嵌入,深度挖掘传统方法忽略的时频细节(如说话人特性与语义内容的动态耦合),并设计多路交互机制实现细粒度信息融合;2)上下文感知架构:增强模型对长时上下文的依赖性,通过跨模态注意力机制整合声学与语义线索;3)分层监督范式:引入句级粗粒度监督信号,利用预训练上下文建模模型(如BERT、WavLM)的输出作为知识引导,约束全局语义一致性。
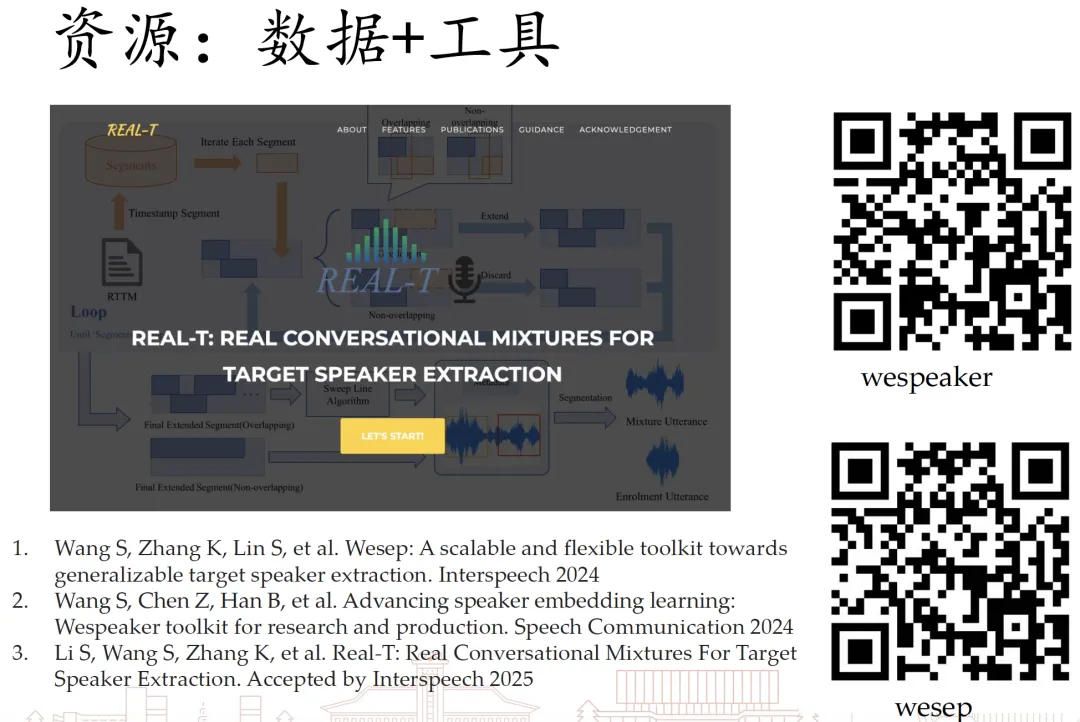
图5 王帅老师团队开发的WeSpeaker工具链
为支撑上述研究,王老师团队联合wenet社区开源了说话人建模工具WeSpeaker,支持数十种主流模型,并在此基础上开发了首个面向目标语音提取的开源工具WeSep,无缝衔接WeSpeaker强大的说话人建模能力。此外,还发布了首个真实对话混合数据集Real-T(含多噪声场景、动态声纹漂移样本),填补了TSE领域真实场景测试数据的空白。报告最后呼吁学界共同探索两大方向:上下文感知说话人编码器(动态适应声纹时变)与跨模态上下文融合(唇动、文本、空间方位等多源信息协同),推动目标语音提取从"孤立声纹匹配"向"情境智能感知"跃迁。
5)张结:判别-生成混合建模式通用语音增强
中国科技大学张结老师在报告中介绍了团队在判别-生成混合建模式通用语音增强取得系列创新成果。他们提出的PGUSE(Predictive-Generative Universal Speech Enhancement)框架,创新性地结合了判别式与生成式方法的优势,突破单一范式局限:1. 架构设计:判别路径(深度神经网络)专注于噪声抑制与精确映射,利用大规模数据实现高效去噪;生成路径(扩散模型)负责语音信息重建与泛化,通过先验分布采样补全严重受损的语音分量(尤其低信噪比场景);双路径协同显著降低纯扩散模型的计算复杂度(减少迭代采样步骤),同时规避纯判别模型的信息过度抑制问题。2. 性能优势:客观指标:在通用语音增强基准测试中,PGUSE超越纯判别模型和纯生成模型;主观听感:生成路径重建的语音自然度显著提升,判别路径则确保音色一致性。3. 关键技术突破:相位优化:在扩散路径中显式融合相位信息,解决高频带"小幅值-相位失配"导致的伪音问题;因果性实现:设计流式处理机制满足实时通信需求;轻量化适配:压缩双路径参数量,支持边缘设备部署。
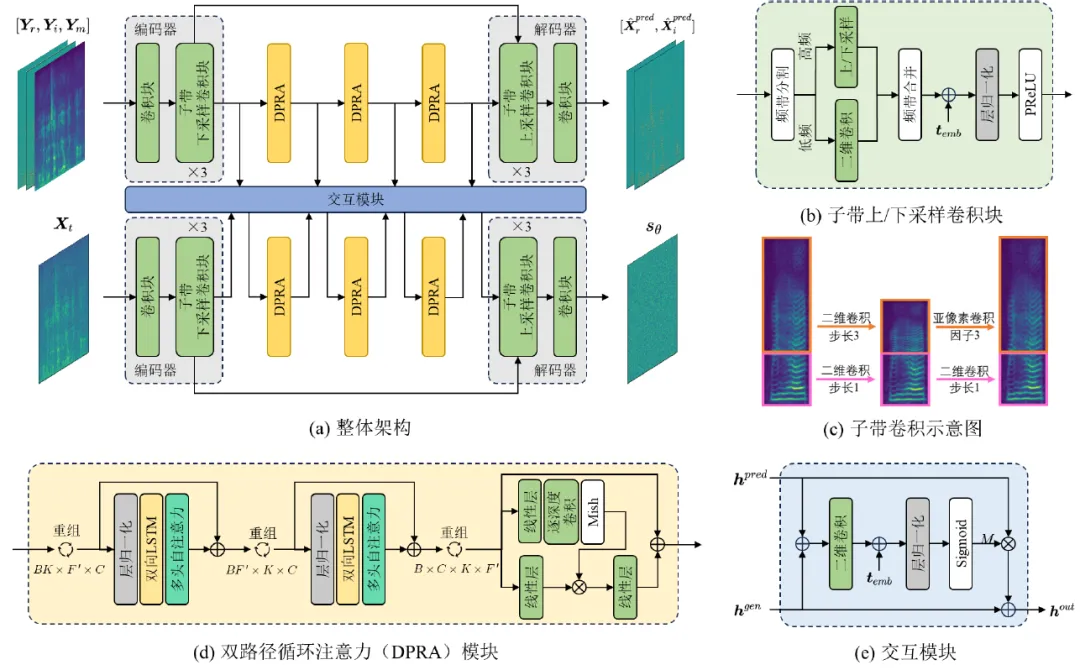
图6 张结老师团队开发的PGUSE框架览图
最后,张老师总结了现存挑战与方向:需进一步抑制高频段偶发伪音(因幅值-相位联合估计偏差);提升极低资源设备(如IoT终端)的推理效率;探索扩散状态的高斯噪声估计简化策略以加速采样。该研究标志语音增强进入“判别-生成协同”新阶段:判别建模锚定确定性降噪,生成建模赋予创造性复原,二者互补释放通用语音增强的全场景潜力。
6)李晓飞:基于空间信息学习的ASR鲁棒语音增强
西湖大学李晓飞老师在报告中介绍了团队在空间信息学习与语音增强领域取得系列创新成果,其核心工作聚焦于多通道和单通道语音增强中的空间信息建模。团队提出的SpatialNet框架通过窄带CTF建模和跨频带声场相关性分析,在SMS-WSJ数据集上取得突破性表现。同时,基于变分贝叶斯推理的VINP框架在Reverb数据集上实现3.80 DNSMOS(P.808)和4.3% WER,展现了神经网络语音先验与盲房间脉冲响应识别的有效结合。这些工作系统探索了从时域卷积模型到频域CTF近似的建模演进,为复杂声学环境下的语音增强提供了完整技术体系。
李老师在本次报告中特别强调了空间信息在语音增强中的关键作用,指出“空间信息学习是提升ASR鲁棒性的核心”。他详细阐述了CTF建模相比传统MTF方法的优势,特别是在长混响环境下的准确性提升。通过SpatialNet和CleanMel等创新模型,李老师团队验证了窄带CTF建模结合跨频带相关分析的优越性,同时揭示了空间信息利用与语音失真度的负相关性。这些观点为面向ASR的语音增强研究提供了重要的理论指导和技术方向。
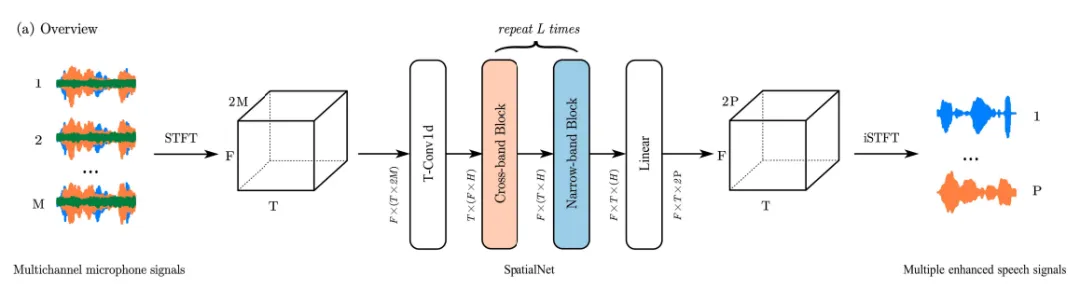
(a)
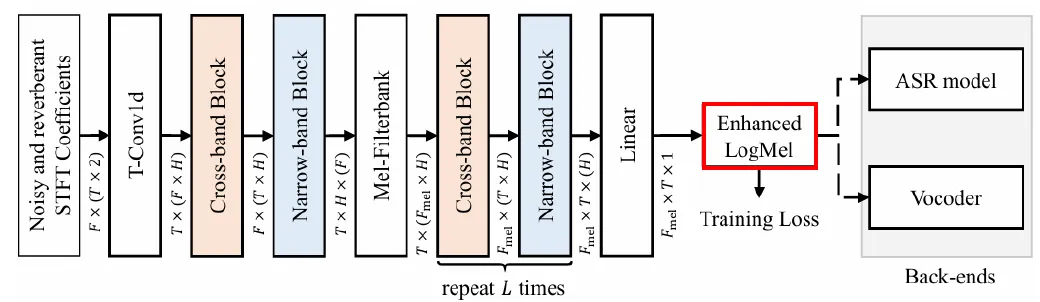
(b)
图7 李晓飞老师团队开发的(a) SpatialNet和(b) CleanMe模型框架览图
7)钱彦旻:通用语音分离
上海交通大学钱彦旻老师在报告中介绍了团队在通用语音分离领域取得系列创新成果,他们提出的USE(Unified Separation and Extraction)模型创新性地实现了声音分离与目标声音提取的统一架构。该模型由声音分离主干网络、编码器-解码器吸引子网络(EDA)和多模态线索处理网络组成,在AudioSet数据集上取得显著性能提升。研究突破了传统方法对声源数量预知和高质量线索的依赖,通过EDA模块实现了动态声源计数(支持最多6声源分离),并通过多模态线索对齐技术实现了文本、视频、声音标签等多种提示的有效融合。这些成果为构建通用音频处理系统提供了重要技术路径,相关工作已应用于URGENT 2024/2025语音增强挑战赛。
钱老师在本次报告中重点强调“统一架构设计是解决声音分离与提取任务碎片化的关键”。他详细阐述了EDA模块的动态声源计数机制,指出该技术突破了传统方法对固定声源数量的限制。通过多模态线索网络的注意力对齐机制,USE模型实现了从单一模态到多模态组合(视频+标签+文本)的灵活目标提取。钱老师特别展示了模型在未知声源数量场景下的优异表现,验证了USE架构的通用性和扩展性。这些创新为构建面向真实复杂场景的智能音频处理系统提供了重要理论基础和实践指导。
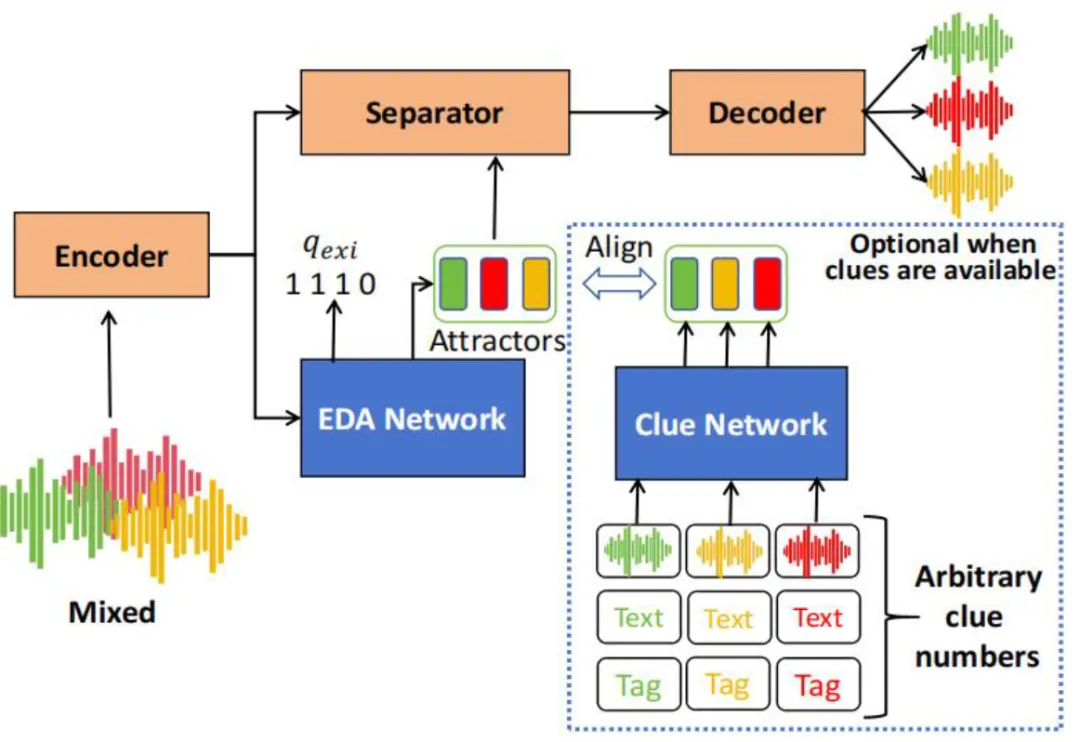
图8 钱彦旻老师团队提出的USE(Unified Separation and Extraction)模型图
8)黄公平:广义目标人语音提取
武汉大学黄公平老师在报告中介绍了团队在广义目标人语音提取取得系列创新成果。他们针对远场语音提取中的关键挑战,系统研究了高保真波束形成技术。团队提出的混合超指向性差分阵列突破了传统波束形成方法的局限,通过创新性地结合全向和双向传感器,实现了宽带语音信号(20-20kHz)的高保真处理。研究解决了小尺寸阵列在复杂声学环境中的噪声抑制难题,提出的频率不变波束形成技术显著改善了低频性能,相关成果已被Matlab收录为库函数(diffbfweights)。在稳健性方面,团队通过白噪声增益(WNG)和指向性因子(DF)的优化设计,有效提升了阵列对传感器噪声和失配的鲁棒性,为远距离交互系统提供了可靠的技术支持。
黄老师在本次报告中重点指出了“物理原理与信号处理的协同设计是解决远场语音提取难题的关键”。他详细分析了传统延时求和波束形成主瓣宽、低频抑制差的缺陷,指出混合差分阵列通过空域滤波器的优化设计,实现了更均匀的频带衰减特性。针对深度学习在阵列处理中的应用,黄老师特别提醒“不能忽视物理原理的基础作用”,强调仿真数据与实际场景的差距可能限制模型性能。这些观点为麦克风阵列技术在智能语音交互、远程会议等场景的应用提供了重要指导。
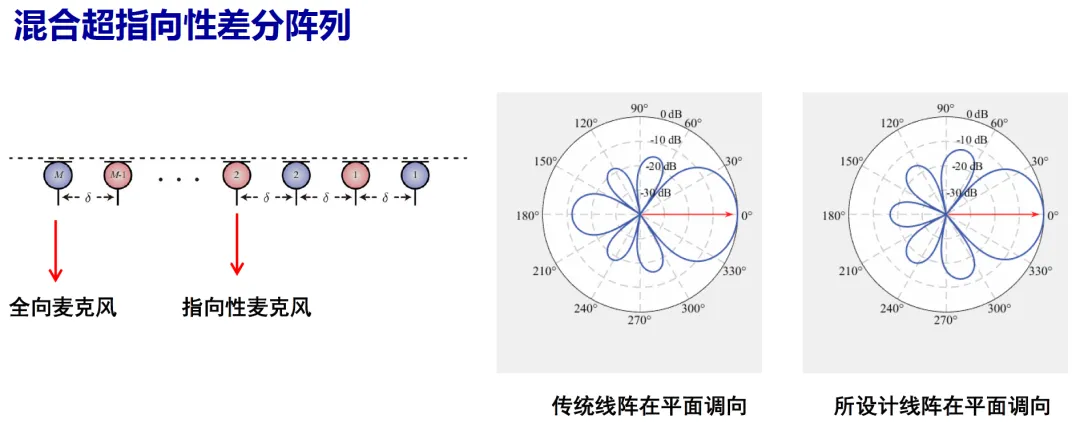
图9 钱黄公平老师团队提出的混合超指向性差分阵列
9)钱馨园:基于多模态提示的说话人提取技术
北京科技大学钱馨园老师在报告中介绍了团队在基于多模态提示的说话人提取技术方面取得系列创新成果。她团队系统探索了视觉、空间和语义等多模态线索的协同利用。在视觉线索方面,团队提出的SEANet框架通过选择性听觉注意力机制和并行语音噪声学习模块,在LRS2数据集上实现了优异表现;针对人体姿态线索开发的SEG网络在YGD-3mix数据集上取得4.95dB SI-SDRi和76.47%准确率。在空间线索方面,团队提出的DualQuery+CFW方法结合语义查询和空间定位,实现突破性性能。这些工作为复杂场景下的说话人提取提供了多模态协同解决方案。
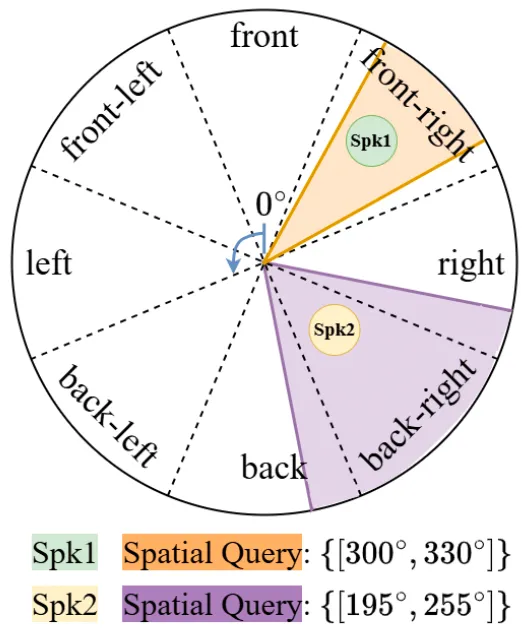
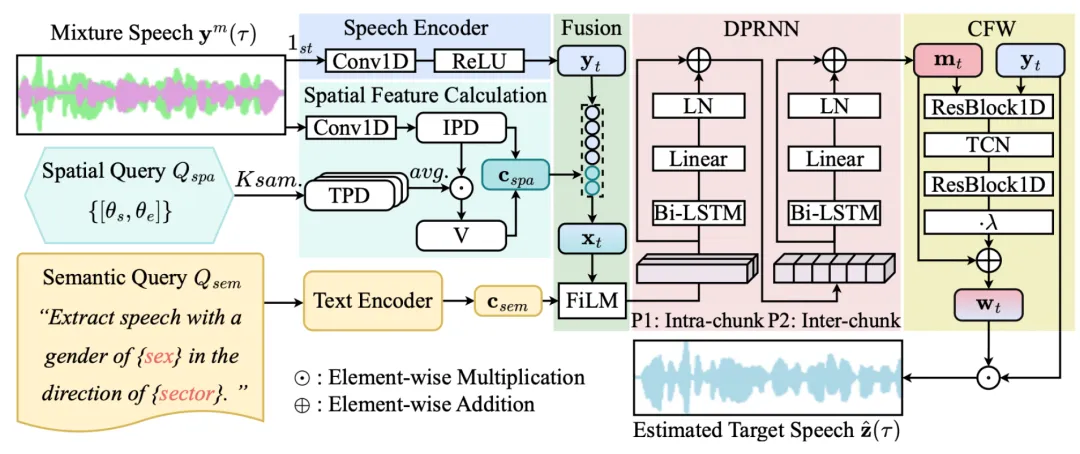
图10 钱馨园老师团队提出的利用空间线索的TSE网络
钱老师在本次报告中指出“多模态线索融合是提升说话人提取鲁棒性和适应性的关键”。她详细分析了传统单模态方法的局限,指出视觉线索(人脸、姿态)、环境信息和空间定位等多源信息的互补价值。针对实际应用场景,钱教授特别展示了基于未对齐文本线索(如演示文稿内容)的TPE方法在MMSpeech数据集上取得了良好的表现,验证了语义信息在会议场景下的独特优势。这些创新为智能交互、远程会议等应用提供了重要技术支撑,展现了多模态融合在语音处理领域的广阔前景。
10)卢晶:复杂场景下语音提取的鲁棒性—引入实采数据的模型训练
南京大学卢晶老师在报告中介绍了团队在复杂场景下语音提取的鲁棒性方面取得系列创新成果。他团队针对远场复杂场景下的语音提取问题,系统研究了基于规则与数据驱动的融合方法。团队在ICASSP2023 Clarity Challenge中提出的方案在模拟测试集(Eval 1)上取得0.693的平均得分(HASPI+HASQI),实采测试数据综合评分排名第一,展现了融合处理策略的有效性。针对实际系统中的挑战,卢老师团队还研发了低功耗模型和软硬件协同优化技术。这些工作为解决高混响、低信噪比等远场语音处理难题提供了系统级解决方案。
卢老师在本次报告中指出“实际场景数据与仿真数据的特性差距是当前研究的重要挑战”。他通过ICASSP2023 Clarity Challenge结果分析指出,所有系统在真实录音测试集上性能显著下降,揭示了仿真数据与实际场景的显著差异。针对这一问题,卢老师提出应加强生成模型的抗幻觉能力、探索更有效的非侵入式评估指标,并通过软硬件协同设计实现低功耗部署。这些观点为提升语音处理技术在车载、智能家居等真实场景中的鲁棒性提供了重要方向。
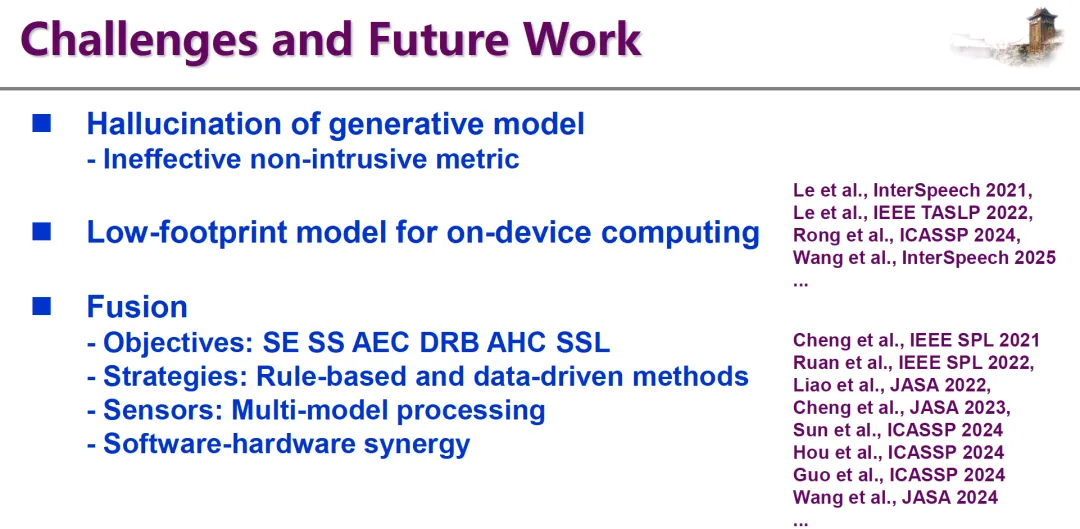
图11 卢晶老师在报告提出未来挑战和方向
11)张鹏远:基频辅助的生成式语音增强
中科院声学所张鹏远老师在报告中介绍了团队在基频辅助的生成式语音增强方面取得系列创新成果。他团队针对传统降噪模型导致的语音质量下降问题,创新性地提出了基频辅助的生成式语音增强框架。团队开发的DMHRN模型采用降噪-修复两阶段策略,通过基频及其置信度作为先验信息,在DNS数据集上实现了优异表现。进一步提出的轻量级PHRSE架构将计算复杂度降至1.14 GFLOPS,仅为TFGridNet的1/13,同时保持高质量输出。这些工作为低资源场景下的实时语音增强提供了有效解决方案,成功平衡了语音质量与计算效率的矛盾。
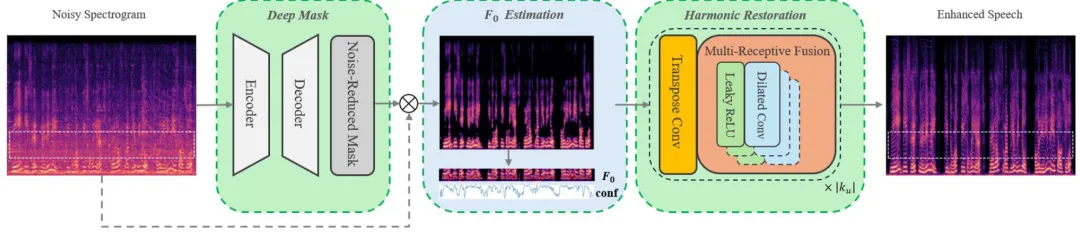
图12 张鹏远老师团队提出的基频辅助的生成式语音增强框架图
张老师在本次报告中强调了“基频先验与轻量化设计的协同优化是提升语音增强实用性的关键”。他详细分析了传统判别式模型在谐波结构修复上的不足,指出两阶段架构中降噪模块与声码器的分工优势。针对实际部署挑战,张老师特别展示了PHRSE模型在保持3.31 SIG分数同时仅需2.58M参数的突破,验证了基频引导对计算效率的显著提升。这些创新为车载通信、移动设备等低功耗场景的语音增强应用提供了重要技术路径。
12)卜辉:目标人语音提取相关数据集进展
语音之家&北京希尔贝壳有限公司CEO卜辉在报告中,系统介绍了希尔贝壳(AISHELL)系列语音数据集的建设成果与应用价值。AISHELL-1作为178小时的中文普通话数据库在2017年开源,覆盖智能家居、无人驾驶等11个领域,包含400名不同口音区域发言人,该数据库的论文引用量达到1100次,成为产学研的标准数据。团队近几年陆续推出了系列开源数据,2024年推出的AISHELL-5数据集是首个开源的真实车载多通道多说话人数据集,包含1000+小时车内语音数据,支持多说话人识别和日志分析任务。今年会推出情感合成数据库SMIIP、耳语语音数据库AISHELL-6-Whisper,这些数据集通过严格的录音标准(如多设备同步采集)和专业的标注流程,为语音识别、声纹验证等研究提供了重要基础资源。
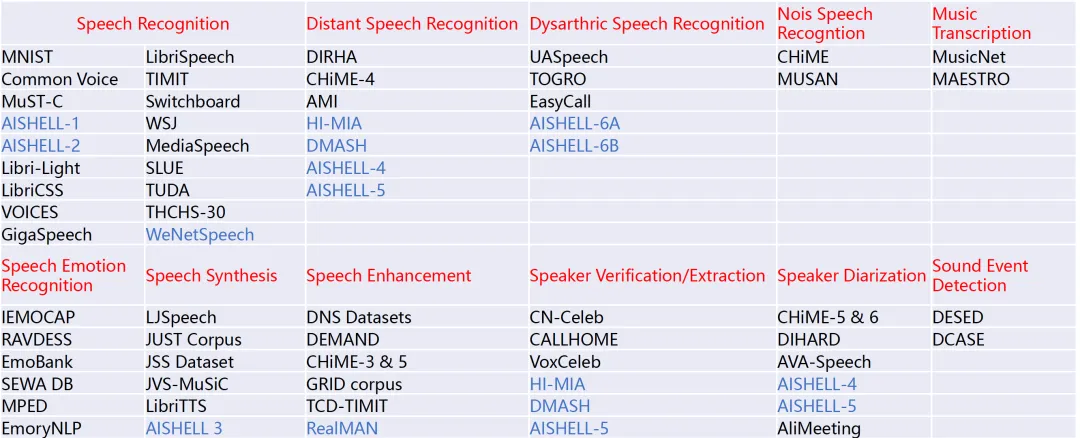
图13 AISHELL系列语音数据集的建设成果展示
卜总在本次报告中重点强调了“高质量数据集的共建共享是推动语音技术发展的关键”。他详细分析了当前中文语音数据集建设的挑战,包括标注质量控制、小规模有价值数据建设等问题。针对生成语音评价指标缺失的现状,卜总呼吁建立更完善的评估体系。他特别提出应通过“产学研”协同模式,推动从英文到中文数据集的转变,提升中文语言数据影响力。这些观点为语音技术的基础数据建设提供了重要指导方向,对促进学术研究和产业应用具有深远意义。
2. 开放讨论/Open discussion
【小组1】 俞凯、谢磊、黄公平、张结、刘李、钱馨园、杨玉红、高丽 (张结老师作为代表,报告小组讨论情况)
1. 问题一:评估体系
大家围绕语音增强的评估体系展开讨论,指出当前指标与数据集的局限性。 谢磊老师强调现有评估指标难以保证公平性,需加强数据集建设。俞凯老师指出人机交互与人人交互场景的评估指标应差异化,需关注质量、可懂度、整体体验等维度,并解决众包数据质量控制问题(如自然句覆盖)。张结老师提出众包训练评估工具的思路,建议结合主客观指标:主观评估(面向人类听众):包括语音质量(如美学、可懂度)、区分专业听众与普通用户的评价标准;客观评估(面向机器):如WER(词错误率),但需考虑不同任务(ASR、说话人识别、情感识别)的模型适配性。刘李老师探讨大模型是否具备人类侧听能力,建议探索强化学习(如DPO)等评估方法。
话题共识:
鉴别式模型更适合机器端任务(如ASR),因其对明确目标的优化更直接;生成式模型更符合人类听觉偏好,因其能生成更自然的语音。关键问题在于任务定义:若目标明确(如降噪),鉴别式更高效;若需主观质量提升(如通讯场景),生成式更具优势。
2. 问题二:鉴别式与生成式模型的优劣对比
大家共同研讨了分析了鉴别式与生成式模型的优劣。俞凯老师对这两种范式的本质差异给出进一步解释:
鉴别式模型:基于有限数据点学习分类边界,擅长区分性任务(如噪声抑制),数据量越大性能越优;
生成式模型:通过参数化建模全数据空间,更擅长重建与泛化。
黄公平老师提出生成式方法可能带来出现一些新问题,例如输出伪造语音失真(幻觉问题)。杨玉红老师提出是否可以引入鉴伪技术,对生成通过分析生成模型的训练目标与输出差异,提升增强结果的真实性?
3. 问题三:离散与连续表征的协同
针对语音表征的编码方式,大家讨论聚焦于:
连续表征(前端)与离散表征(后端)的结合潜力,但当前技术对带噪语音的离散化仍存在挑战(如噪声难以离散化、增强后失真);
非白噪声的离散化可能改善ASR与通讯中的失真问题,类比数字信号与模拟信号的转换;
Codec进展或助力规律性噪声的参数化建模,需进一步探索噪声估计与离散化方法的优化。
【小组2】 凌震华、张鹏远、付强、李晓飞、王帅、肖龙帅、郭海燕、任延珍、朱梦尧 (凌震华老师作为代表,报告小组讨论情况)
1.问题一:生成式方法与判别式方法的适用性
任务适配性 (凌震华老师,肖龙帅老师)
生成式方法和判别式方法在不同任务中各有优势,关键在于明确任务的定义和应用场景。例如,在语音识别和声纹识别等任务中,不同的应用场景对处理结果的敏感性差异较大。因此,首先需要清晰界定任务目标及其适用场景,才能选择最合适的方法。
面向人或机器的差异 (多位老师提到)
当任务面向下游应用时,无论是面向人还是机器,两种方法的表现可能各有优劣。比如,语音识别任务可能更需要判别式方法,而一些直接面向听感的任务可能更适合通过生成式方法实现。
统一模型的必要性(郭海燕老师)
目前大多数都是针对特定任务的专用模型,统一一个架构是否有必要性?甚至将判别式模型和生成式模型也采用同一个前端(如预训练模型)来进行统一多任务的建模。
2.问题二:评价指标的设计与选择
主观指标与客观指标的取舍 (凌震华老师)
在面向人的任务(如语音合成)中,主观评价指标是不可或缺的。然而,主观评测往往耗时费力,且难以完全做到客观公正。因此,在现阶段研究中,通常以客观指标为主,仅在关键阶段(如比赛的复赛环节)引入主观评测。例如,华为的相关比赛中,初赛采用客观指标,复赛才通过主观评测进行深度筛选。
面向机器的评价需求 (王帅老师)
面向机器的任务更倾向于采用端到端的评价指标,而非仅关注信号层面的性能。未来的研究可以探索如何将主观评价指标客观化,同时需要明确人耳听觉和机器听觉的评价是否应该分开设计,应该在领域内达成共识,而不是强制对所有任务都要求提供同样的评价体系。
3. 问题三:研究方法论的完善
任务内在机理的探索 (付强老师、李晓飞老师、朱梦尧老师)
当前智能语音研究多聚焦于数据、模型和评价指标,但对任务背后的科学原理(如人耳听觉机理、物理声学机理等)的关注较少。尽管神经网络学习方法在许多场景下表现出色,但泛化能力仍存在局限性,单靠数据补充来解决问题并非长久之计。深入研究任务的内在机理,有助于从根本上解决问题。
训练数据的模式挖掘(任延珍老师)
大家都希望训练数据越多越好,但是这个需求其实很难被持续满足。比如在安全领域中,大家会先尝试抽取数据分布的本质特征,用来进行模型训练,而不是一味进行数据增强
科研问题的归纳 (张鹏远老师)
在科研项目申报中,如何准确归纳语音研究的科学问题仍具有挑战性。语音研究不应沦为某一工程任务的附属分支。未来可以通过跨学科的研讨会,触碰核心难题,探索未知领域。
4.问题四:机理性方法与信号处理方法的融合
传统方法与现代技术的结合 (付强老师,李晓飞老师)
语音增强领域传统依赖信号处理方法,而当前的研究则更倾向于机理性方法与机器学习的融合。在极端场景下,传统信号处理方法往往表现得更为可靠,这也反映出现有模型在泛化性和可解释性方面的不足。然而,传统方法的一个局限性是传统的基础理论突破非常慢,大家采用深度神经网络的一个出发点也是之前的基础理论无法满足实际需求了。
物理仿真目前的局限性 (朱梦尧老师)
尽管物理场景的仿真对语音增强研究十分关键,但目前相关技术仍未取得突破,这在一定程度上限制了领域的发展。
未来应更多的考虑将信号处理与物理知识融入到现在的建模过程中来,从更fundamental 的角度来看待、思考、解决问题。
会议形式建议:
主题聚焦的同时,人员背景可适当发散,邀请多领域人员围绕主题寻找解决方案,提高语音圈影响力。
【小组3】 李军锋、卢晶、李明、武执政、涂卫平、卜辉、岳祥虎、陈光科(李军锋老师作为代表,报告小组讨论情况)
主要聚焦讨论的问题:语音圈还能干什么?
1. 综合多种病理语音及精神疾病访谈语音的综合建模
2. 生成式方法存在高表现力问题,尤其是面向影视作品.
3. 研究问题要服务于国家一带一路输出,影视,文化输出。
4. 国家层面建数据,尤其是低资源场景,
5. 扩展到多模态或AI for science
总结:与国家重大战略有差距,建议做更多的小而美的东西。目前现状是大同行似懂非懂。
3.RASDAP2025相关链接
【研讨会预讲报告】
6月11日、12日举办两场线上论坛,语音之家现场直播,总计10份报告
- 第一场:https://mp.weixin.qq.com/s/UoCSXKsgd0KLNExdyHgT2A
- 第二场:https://mp.weixin.qq.com/s/cCK5YTpKEbbvLzdZEJ4icA
【研讨会报告分享】
引导发言PPT收录到CCF数字图书馆,总计11份报告
https://dl.ccf.org.cn/albumList/getMeetingDetail7559581811755008
【研讨会后续活动】
以RASDAP研讨会为平台,讨论并落实的相关活动包括:
- 8月30日CCF先进音频赛事成功举办,比赛的详细介绍
https://mp.weixin.qq.com/s/ClS6aZr9BFUg3DhIwubqrQ
- 10月18日NCMMSC特殊议题8《复杂场景下的通用声音增强与分离》共收录7篇高质量论文,并撰写论文导读合集
