
 语音小管家
语音情感识别(Speech Emotion Recognition, SER)旨在从语音信号中自动识别说话人的情感状态,是实现自然人机交互和情感计算的关键技术。随着大型音频语言模型(Audio Language Models, ALMs)的飞速发展,直接利用ALM进行端到端的语音理解和情感分析成为当前的研究热点。主流的ALM方法通常通过对齐音频编码器与大语言模型,利用海量数据激发出强大的泛化能力。然而,这种端到端的方法在SER任务中往往面临着严重的“幻觉(Hallucinations)”问题,即模型倾向于生成看似合理但缺乏声学证据支撑的上下文信息,导致识别结果的不稳定和不可靠。一个理想的SER系统应当具备可解释的推理能力,能够基于客观的声学线索和语义内容进行有理有据的情感判断。
近期,西工大音频语音与语言处理研究组(ASLP@NPU)的论文 “Steering Language Model to Stable Speech Emotion Recognition via Contextual Perception and Chain of Thought” 针对上述问题开展了深入研究。本文提出了一种新颖的名为 C²SER的基于上下文感知与思维链(Chain of Thought, CoT)的语音情感识别框架,旨在消除大模型的幻觉并提升情感识别的稳定性与准确性。相关代码和数据已开源。现对该论文进行简要的解读和分享。
论文题目:Steering Language Model to Stable Speech Emotion Recognition via Contextual Perception and Chain of Thought
作者列表:赵致闲,朱新发,王新升,王水源,耿雪龙,田文杰,谢磊
论文预印版:https://arxiv.org/abs/2502.18186
开源代码和数据集:https://huggingface.co/collections/ASLP-lab/c2ser
音频是一种多层面的交流媒介,通过声学特征传达韵律、语调和副语言线索。大规模音频语言模型(ALMs)如Qwen2-Audio等在理解多样化音频信号方面取得了显著进展。然而,ALMs在语音情感识别(SER)任务中仍面临挑战,主要表现为“幻觉(Hallucinations)”现象。
幻觉是指模型生成了任何在提供的音频信号中缺乏事实依据的信息。这一问题的表现形式多样,从模型编造看似合理但未经证实的上下文细节 —— 例如,在没有任何证据的情况下,推测一个语气欢快的说话者是 “庆祝大学录取的学生”—— 到更严重的失误,即模型从根本上误解情感并编造毫无根据的理由。如图1所示,当处理一段由年轻女性以慢速、正常音调说出的“Dear! dear!”(通常传达快乐语气)时,传统方法可能会错误地将其标记为“悲伤”,并编造出“也许他正在准备考试”这样毫无根据的理由。这种失败不仅导致分类错误,还破坏了模型的可靠性。
此外,现有的情感声学模型(如Emotion2Vec [1])虽然在句子级别表现出色,但缺乏机制来明确区分声学上相似但类别不同的情感(如“恐惧”和“悲伤”),容易导致混淆。
本文旨在通过C²SER框架解决上述挑战。该框架不仅引入了改进的声学感知模块Emotion2Vec-S,还提出了一套从显式到隐式的思维链(CoT)训练策略,强制模型先感知“怎么说(声学风格)”和“说什么(语义内容)”,再进行逻辑推理,最终得出情感结论。
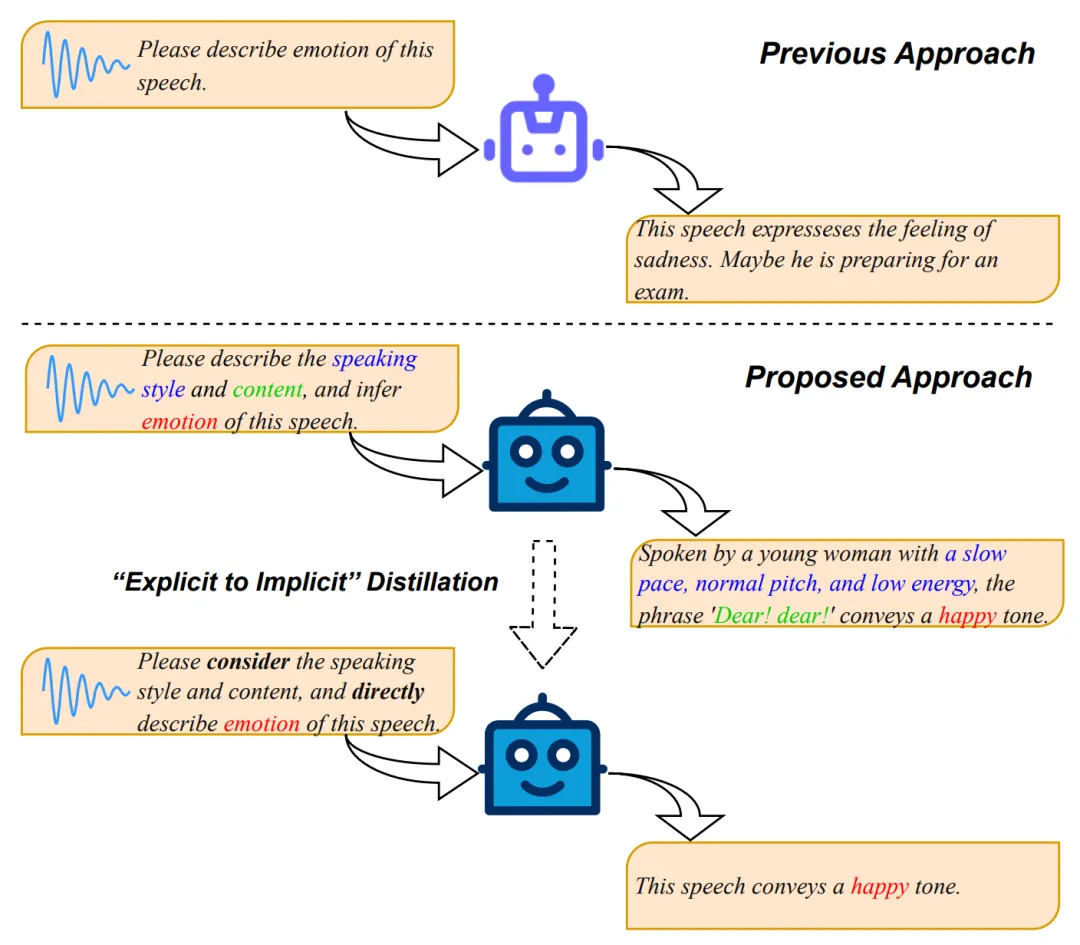
图1 C²SER与传统方法的对比。上方显示传统模型产生幻觉,下方显示本文提出的两阶段思维链(CoT)方法。
我们的方案可以总结为两个核心部分:(1)上下文感知模块(Contextual Perception),用于提取语义和增强的声学特征;(2)思维链推理(Chain of Thought, CoT),通过从显式到隐式的两阶段训练策略引导模型进行有理有据的推断。
上下文感知:Emotion2Vec-S 与 Whisper
C²SER 利用 Whisper [3] 编码器提取丰富的语义信息,利用 Emotion2Vec-S 提取声学信息。
Emotion2Vec-S 的改进:
传统的 Emotion2Vec虽然效果优异,但在处理细微情感差异时存在局限。如图3所示,我们提出的 Emotion2Vec-S 在原有的语句级和帧级损失基础上,新增了类别级对比损失(Category-level Contrastive Loss,LCate)。
这一改进引入了半监督学习信号,强制模型将属于同一情感类别的样本在特征空间中拉近,将不同类别的样本推远。实验证明,这显著提升了模型对相似情感(如Fear vs. Sadness)的区分能力。
思维链推理 (Chain of Thought)
为了抑制幻觉并模拟人类的思考过程,C²SER采用了两阶段的CoT训练:
阶段1:显式CoT(Explicit CoT)
模型被训练为先生成详细的推理路径,再得出情感结论。推理路径包括对声学属性(如语速、音调、能量)的描述以及对内容的分析。例如:“说话者语速较慢,音调低沉……因此推断为悲伤”。这一步强制模型将预测建立在可量化的声学证据上。
阶段2:隐式CoT与自蒸馏(Implicit CoT)
显式CoT虽然准确,但推理过程冗长,增加了推理延迟。为了提高效率并减少错误累积,我们提出了一种自蒸馏(Self-distillation)策略。通过逐渐减少中间推理步骤的监督,将显式CoT的能力“内化”到模型中,使其能够直接输出准确的情感标签,同时保留底层的推理逻辑。
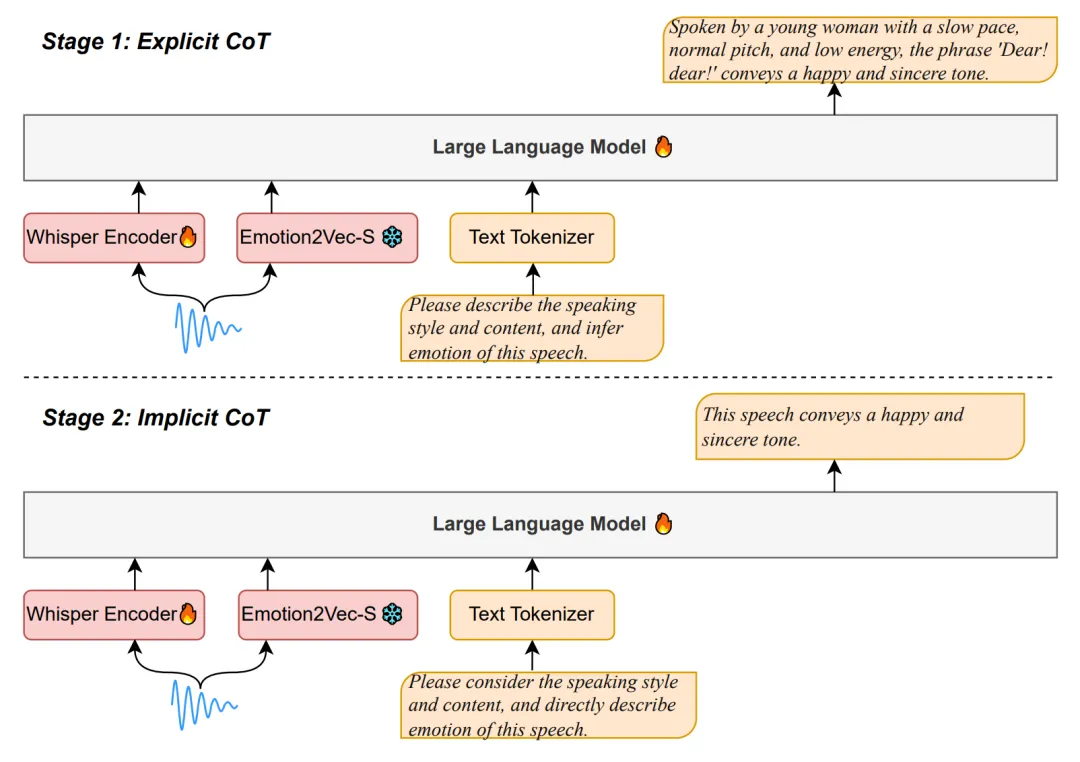
图2 C²SER的详细架构与两阶段训练流程。
数据集构建:Emo-Emilia
为了在更贴近真实世界的场景中评估模型,本研究构建并发布了Emo-Emilia测试集。
该数据集源自大规模多语言数据集 Emilia [4],包含中文和英文数据。我们采用了“自动标注 + 人工校验”的构建流程:
使用 Emotion2Vec 和 GLM-4 [5] 分别对语音和文本进行情感预标注;
筛选两者一致的样本;
由双语专家进行严格的人工复核。
最终得到的 Emo-Emilia 包含 1400 条高质量样本,覆盖 7 种情感类别,具有高度的多样性和真实性。
数据集获取链接:https://huggingface.co/datasets/ASLP-lab/Emo-Emilia
为了全面评估模型性能,我们使用了多个公开数据集(IEMOCAP, MELD, ESD等),并构建了一个全新的、包含中英双语的野外情感测试集Emo-Emilia,以模拟真实世界的复杂场景。
主实验结果
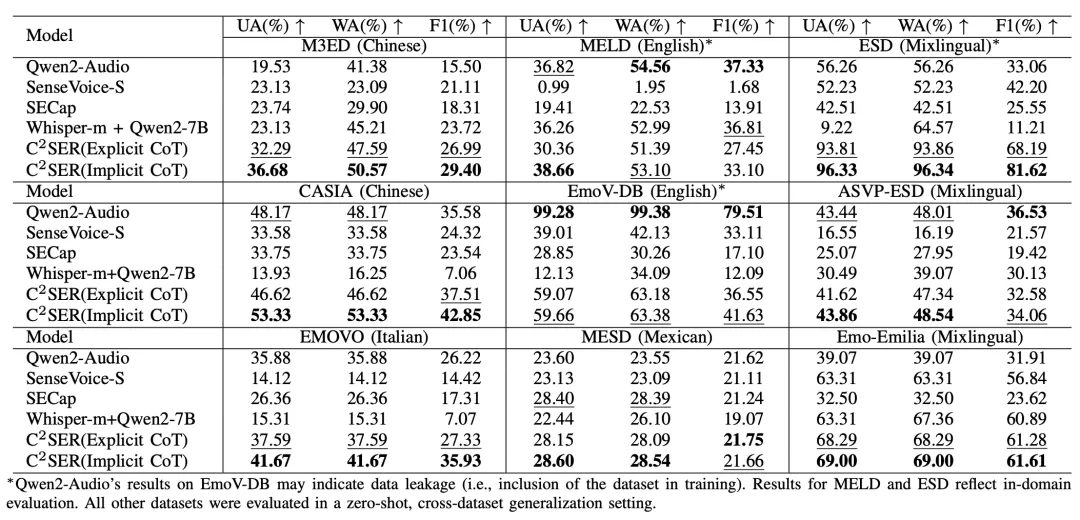
如表1所示,我们对比了C²SER与当前最先进的ALMs(如Qwen2-Audio, SenseVoice-Small)以及级联系统(Whisper + LLM)。实验结果表明,C²SER在加权准确率(WA)、未加权准确率(UA)和F1分数上均优于现有模型。特别是在跨语言和零样本(Zero-shot)场景下,C²SER展现了强大的泛化能力。
相比之下,单纯的级联系统(Whisper-m + Qwen2-7B)在ESD等声学特征主导的数据集上性能严重下降,证明了直接整合声学特征的必要性。
表1 C²SER在中文、英文及混合语言数据集上的性能对比。
幻觉抑制与CoT有效性
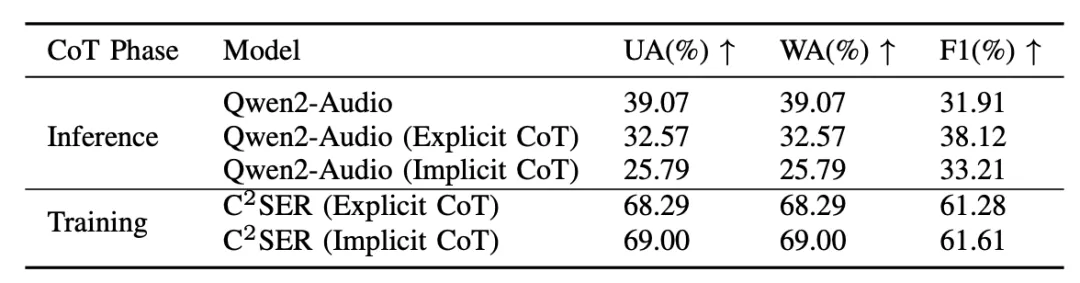
为了验证CoT训练的有效性,我们在Emo-Emilia测试集上进行了对比(见表2)。结果显示,经过隐式CoT训练的C²SER(Implicit CoT)在准确率上显著优于仅进行指令微调的Qwen2-Audio[2]。更重要的是,CoT训练极大地减少了模型生成无关背景信息的情况,有效抑制了幻觉。
表2 思维链训练在 EMO-EMILIA 测试集上的有效性
消融实验
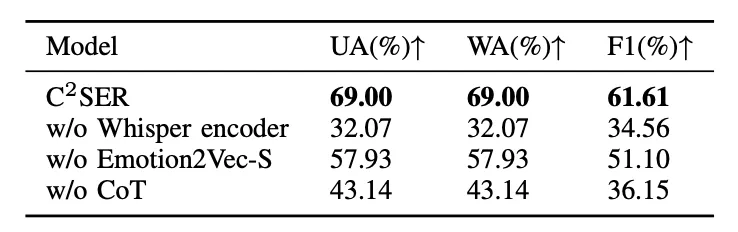
消融实验表明,移除Whisper编码器会导致性能大幅下降,说明语义信息对情感识别至关重要;而移除Emotion2Vec-S或CoT模块同样会导致识别率降低,验证了增强声学感知和推理机制在C²SER框架中的核心作用。
表3 C²SER 在 EMO-EMILIA 测试集上的消融实验
[1] Z. Ma, Z. Zheng, et al., “emotion2vec: Self-supervised pre-training for speech emotion representation,” in ACL, 2024.
[2] Y. Chu, J. Xu, et al., “Qwen2-audio technical report,” arXiv preprint arXiv:2407.10759, 2024.
[3] A. Radford, J. W. Kim, T. Xu, et al., “Robust speech recognition via large-scale weak supervision,” inICML, 2023.
[4] H. He, Z. Shang, et al., “Emilia: An extensive, multilingual, and diverse speech dataset for large-scale speech generation,” in SLT, 2024.
[5] A. Zeng, B. Xu, B. Wang, et al., “ChatGLM: A family of large language models from GLM-130B to GLM-4 all tools,”CoRR, vol. abs/2406.12793, 2024.
