
 语音小管家
先说我的观点
如今市面上有很多类似的产品,大部分通过串联不同 API 来实现与不同形态机器的对话。这是一个已经形成多年共识的方向,也代表了人们对 AI 的终极想象——希望它能真正像人一样与我们对话。
既然如此,为什么不去开发交互能力强、能说会道的智能助手呢?先谈谈我个人的看法:
如今的 AI 时代不同于以往,模型能力的上限仍在持续提升; 必须正视并接受语音在人机交互中的“输入输出”属性; 能说会道的前提在于理解,理解的基础则在于数据; 未来的助手应具备记忆与决策能力,成为真正的 Agent; 单纯依靠指令驱动的助手形态,或许很快便会成为过去。
主要矛盾正在被攻克
深度神经网络在语音识别上的成功,曾推动 Siri、Alexa 等产品迅速走红,掀起了一股语音助手的热潮。在大模型出现之前,构建一个完整的语音助手并非易事,尤其在自然语言理解部分,需要大量规则与技术支持。而大语言模型的出现,极大降低了语音交互类产品的开发门槛与泛化难度——如今想要搭建一个对话系统,毫不夸张地说,具备一些 API 调用基础的人,几个小时内就能完成。什么意图识别、实体抽取、规则匹配,都已不再是必经之路。
再来看语音识别这五年来的发展。以 Librispeech 这个常用的英文数据集为例,其带噪测试集上的词错误率变化如下(数值越低越好):
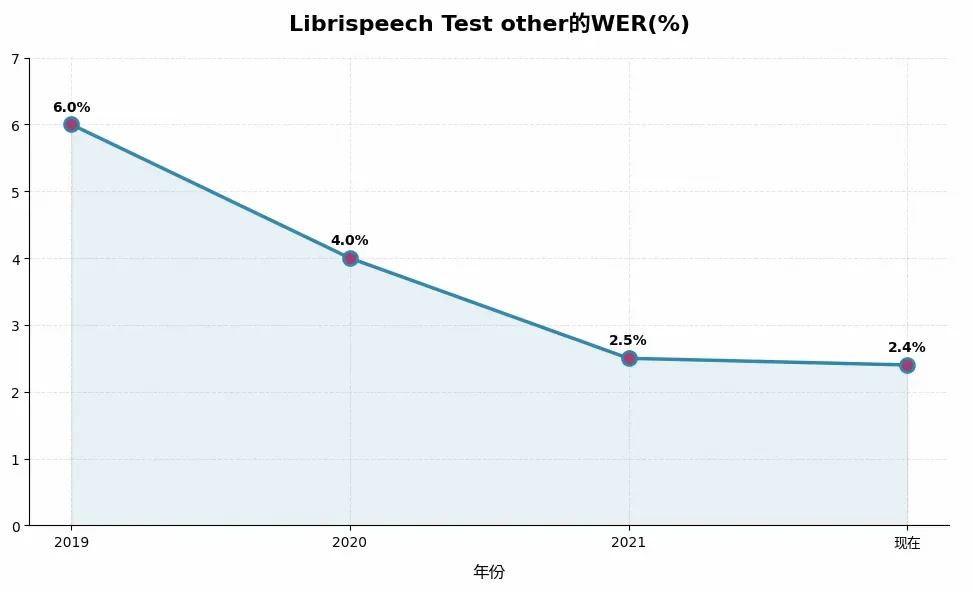
尽管这些结果在学术上未必能完全公平地比较(可能使用了不同的训练数据或解码方式),但趋势是明显的。到 2021 年,该数据集上的语音识别错误率已经降至很低。当然这只是整体趋势,并不意味着技术在其他数据集上没有提升——例如在一些复杂场景中,进步依然显著,这一点我们在实际体验中也能感受到。这背后,是模型参数量从几千万(M)增长到数十亿(Billion)的跨越,也是训练数据从几万小时到数千万甚至上亿小时的积累。
Librispeech 的发音和口音都比较标准,这意味着在普通话日常交流场景中,即便使用五年前的语音识别技术搭配当今的大模型,效果也不会太差。但反过来,如果用最新的语音识别技术却搭配五年前的语言理解技术,那显然是不够的。
语音在人机交互中的 IO 属性
在人机交互中,语音本质上只是替代文字输入的一种方式。目前 99% 以上的应用,仍然先将语音转成文字,再送入理解模型。
语音交互的优点在于某些场景下比文字输入更方便,但其缺点也很明显:
许多场合不适合语音输入,比如办公环境; 语音输入多了一层“语音转文字”的步骤,理论上会产生级联误差。端到端的对话系统在理论上可解决此问题,但也存在自身的局限; 即便标准英语的识别错误率已降至 2.4%,实际应用中,口音、噪音、专有名词、背景干扰、儿童与老人语音等因素,仍会显著影响识别效果。
未来的助手重在记忆与决策,而非“能说会道”
目前的助手大多仍停留在执行用户的单点指令上。我们或许都有体会,最常用的功能无非是:
设定闹钟 播放音乐 调节音量 ……
是不是很熟悉?
随着上下文工程的发展,大模型所能支持的上下文长度越来越长,具备记忆能力的助手将获得更多主动权,也更了解用户。
此外,助手将逐步发展为具有更强决策能力的 Agent。执行单点任务的助手很简单——遵循用户意图,无需决策。但这显然不符合大模型时代个性化、智能化的趋势。
这也是为什么我对所谓“语音进、语音出”的端到端系统持保留态度。除了聊天场景,大多数任务其实不需要语音输出。换句话说,助手不需要那么“能说会道”,它只需根据用户意图或自主理解,完成任务即可。一个会写代码的助手,并不需要真的把每一行代码都读出来。
指令式助手或许即将成为过去
可以说,目前的助手仍以指令驱动为主,被动响应用户的需求。这种形态已延续十几年,用户也习惯了这样的交互。而对于未来的助手,我认为:
懂历史比会“思考”更有价值。我们看到某些推理模型看似严谨地推理,实则可能一本正经地“胡说八道”。在助手场景中,我们或许不必把计算资源过多用于“让模型思考”,而应更关注过去发生了什么,而非让助手凭空猜测将要发生什么。 陪伴但不打扰的助手时代或许即将到来。例如在车内和家庭环境中,无需担心功耗问题,不占用用户使用手机的时间,为用户开辟出额外的“24 小时智能陪伴”。
不过,要实现这样的助手,技术挑战、产品设计、用户习惯培养、底层能力打磨、数据安全与隐私等问题,仍需要一步步攻克。路还很长,但应该不会太远。
