
 语音小管家
AAAI(Association for the Advancement of Artificial Intelligence)是人工智能领域历史最悠久、内容覆盖最广的国际顶级会议之一,也是中国计算机学会(CCF)推荐的 A 类国际学术会议。AAAI 2026 计划于 2026 年 1 月 20 日至 1 月 27 日在新加坡召开。
通用声音分离(USS)和目标声音提取(TSE)是处理复杂声学场景的基础技术。然而,现有的USS方法在确定未知声源数量方面面临挑战,而TSE方法则依赖精确的指定线索才能达到最佳性能。本文提出了一个统一框架USE(Unified Universal Sound Separation and Extraction),通过协同结合USS和TSE来克服它们各自的局限性。通过引入跨任务一致性约束进行联合训练,我们建立了一个连接这两种范式的统一潜在空间。在推理阶段,系统能够自适应地在全自动USS模式或线索驱动的TSE模式下运行。实验结果表明,该框架在两项任务中均表现出色:与基线相比,USS任务的SDRi显著提升了1.4 dB,同时TSE任务的准确率达到了86%。
USE: A Unified Model for Universal Sound Separation and Extraction
作者列表:Hongyu Wang, Chenda Li, Xin Zhou, Shuai Wang, Yanmin Qian
合作单位:上海交通大学,宇生月伴,南京大学,深圳河套学院
背景动机
当前分离与提取网络的局限性
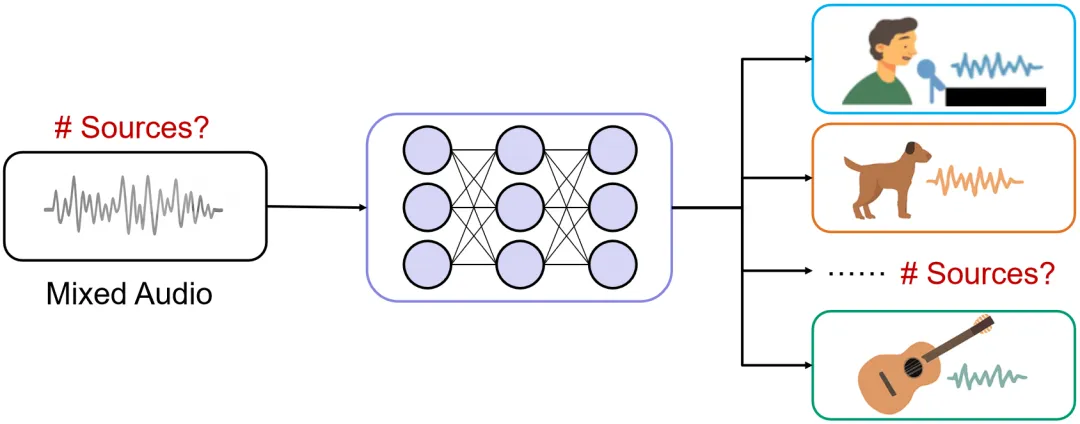
图1.通用声音分离(USS)任务
当前大多的分离模型往往需要提前预知混合音频中声源的数量,因为模型输出头的个数在设计时就需要预定好,但是声源数量在真实场景下我们是无法提前预知的。
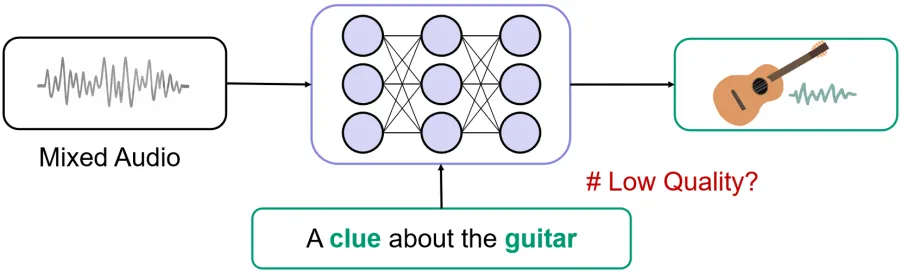
图2.目标声音提取(TSE)任务
为了避免声源数量估计的问题,也有工作提出TSE(target sound extraction)任务,使用与目标声源相关的线索,称为clue,来从混合音频中提取感兴趣的声源。但是当前模型的TSE性能依赖于高质量线索,并且在真实场景下存在线索易缺失的问题。
针对上述USS与TSE难题,我们提出了一种通用声音分离与提取的统一框架USE (Unified Universal Sound Separation and Extraction)。它能够根据线索的有无,在没有线索情况下执行SS任务;有线索情况下执行TSE任务,并且支持单/多模态线索输入,即使在低质量线索条件下也能实现更加鲁棒的提取。
技术方案
USE总体框架设计:USS与TSE的统一
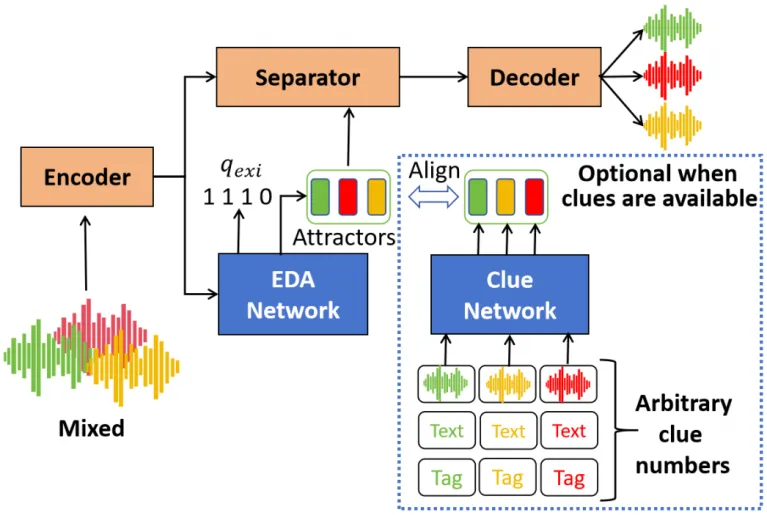
图3.USE模型框架图
通用声音分离与提取的统一框架USE由三大核心模块构成:分离主干网络(Encoder,Separator,Decoder),吸引子(EDA)网络,多模态线索(Clue)网络组成。其中:
分离主干网络:Encoder估计混合音频的高维特征编码,通过Separator估计出每个需要分离的音频的Mask掩码,通过与混合音频特征逐个相乘后,再通过Decoder重建各声源波形。
EDA网络:不需要提前预知混合音频中声源的数量,它能够启发式自回归地估计混合音频中的声源数量及每个声源的表征记作attractor,从而完成声音分离任务。
多模态线索处理网络:对低质量或缺失的线索具有鲁棒性,能够接受任意数量模态的线索输入,并在统一空间中生成更加综合的线索嵌入,完成目标声音提取任务。
USE逐模块拆解:
1.USE作为通用框架,这里的分离主干网络可以是任何基于Encoder-Separator-Decoder的分离模型。
2.EDA网络则由LSTM构成,LSTM Encoder对混合音频特征进行学习,LSTM Decoder对需要分离的声源进行迭代计数与特征估计(也称作attractor),当估计出来的当前attractor的质量不佳时模型会停止迭代。
3.Clue网络首先把多模态线索送入各自模态的预训练编码器,统一映射到相同的特征维度,随后将他们在时间维度上进行concat,完成利用上述线索特征作为key和value、混合音频特征作为query的交叉注意力机制,得到的特征随后在时间维度上进行全局池化,得到最终更加鲁棒与综合的线索特征。
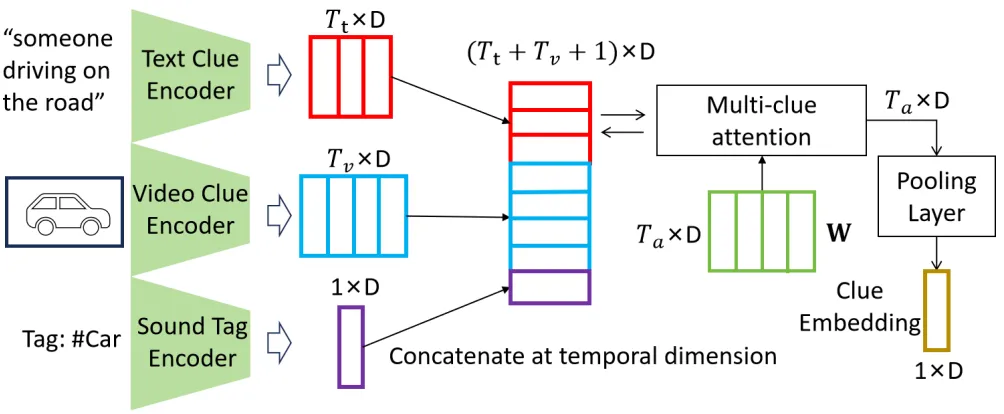
图4.多模态线索网络结构图
两阶段训练策略
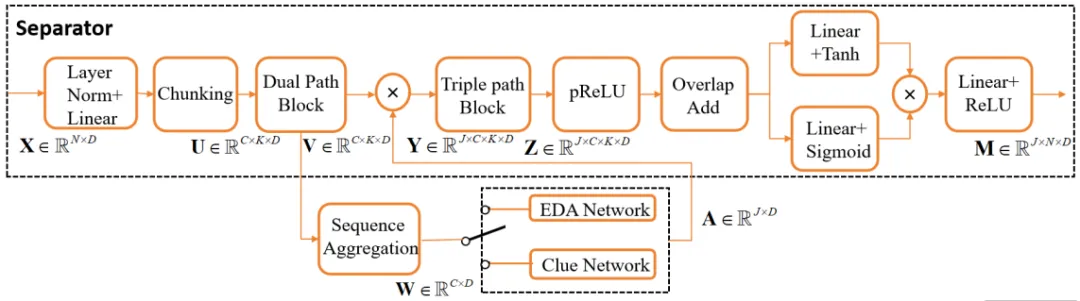
图5. 分离网络的主干架构与两阶段训练流程示意图
在训练过程第一阶段先单独训练分离(USS)任务,来优化分离主干网络和EDA网络,Clue网络在此时没有使用。EDA会迭代估计每个声源的表征和并根据attractor的质量来决定是否停止估计。估计出来的attractor可视作隐式的声学线索送入分离网络主干,执行声音分离任务。其中的声源数量估计的任务由二元交叉熵损失监督,分离任务由PIT(Permutation-Invariant Training)损失监督。
第二阶段,USS和TSE任务会一起联合训练来实现两个任务的统一。EDA模块估计的attractor或者是线索网络得到的clue embedding会各自以一定的概率送入分离器Separator进行后续USS/TSE任务,当执行TSE任务时,不同模态的线索也只会以一定的概率送入网络。除了第一阶段提到的计数损失和分离损失,attractor和clue embedding之间会进行MSE损失和InfoNCE(对比学习)损失来达到对齐的目的。这里是以分离结果中计算PIT损失时计算的最佳排列顺序作为伪标签来对齐同一组内attractors和clue embeddings。
在推理过程中,有1~3任意模态数量的线索的时候我们可以直接用线索执行TSE任务,没有线索的时候直接利用EDA网络估计attractor执行USS任务。
实验结果与分析
为了验证USE框架的有效性,文中的分离网络主干在实验部分分别基于当前领域主流的基于时域分离的Sepformer模型和基于频域分离的BSRNN模型,衍生出的通用模型在下文中被分别记作USE-S和USE-B。
USS任务上的消融实验
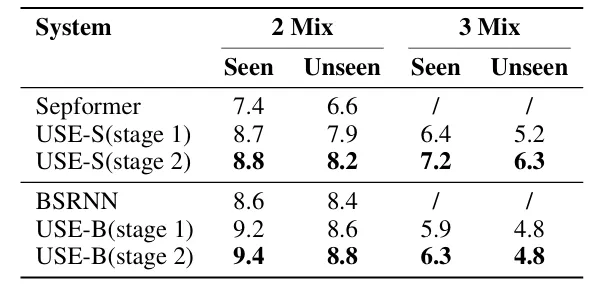
表1. AudioSet通用声音分离任务中,EDA架构(stage 1)与联合训练(stage 2)带来的SDRi提升。
第一阶段通过加入EDA架构,使得模型能够分离不同声源数量的混合音频,并且分离能力上得到了明显的提升。第二阶段通过USS与TSE的联合训练,模型在能够额外收获TSE能力的前提下,分离能力上依旧有了一定的提升。
TSE任务上的消融实验
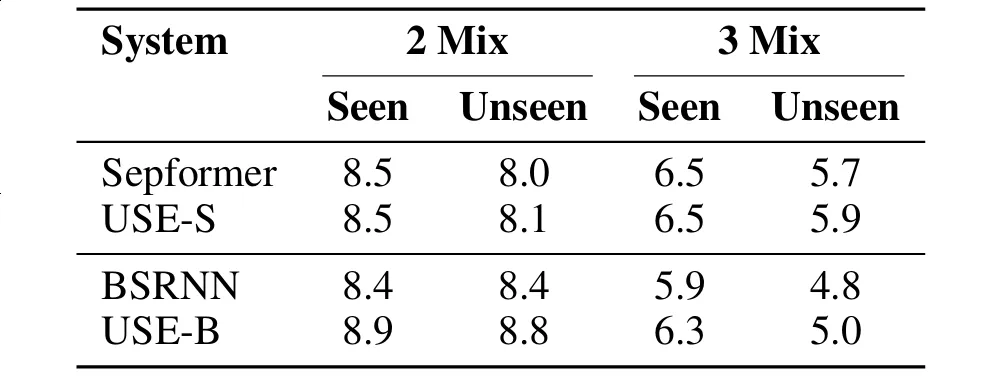
表2.目标声音提取任务中,TSE独立训练与联合训练的SDRi性能对比
在TSE任务上,我们发现USS与TSE多任务的联合训练并没有损害相比于单独训练TSE的性能,反而会在带来TSE性能略微增益的同时,使得模型额外具备SS的能力。
不同模态低质量线索存在情况下的TSE实验
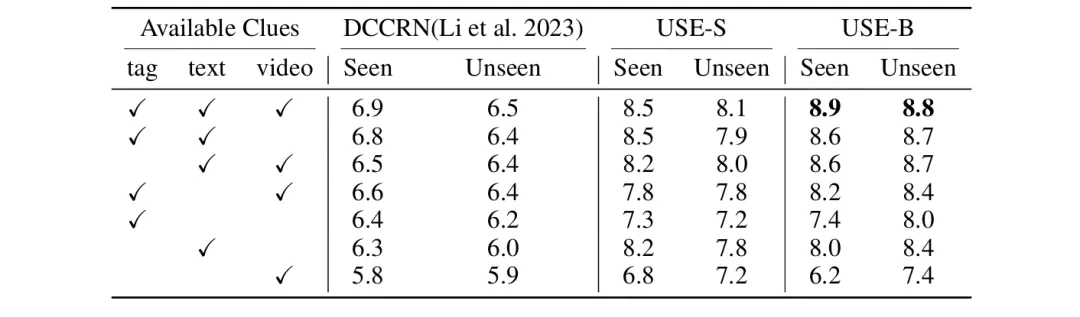
表3.不同低质量线索条件下的目标声音提取SDRi性能对比
针对现实场景下线索质量不高与线索易缺失的问题,我们探索了在不同模态低质量线索存在时TSE的性能。可以发现USE模型在TSE任务上表现优异,并且当三种模态线索都存在时TSE效果最佳,即使只有单模态线索存在时USE的TSE性能依旧可观。
attractor-clue对的t-SNE可视化
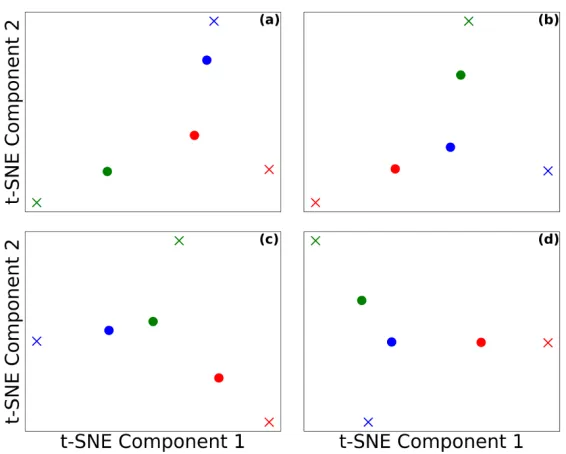
图6.混合音频中不同声源吸引子与线索特征的t-SNE可视化图
我们从测试集中随机t-SNE可视化了四个混合音频中的attractor-clue对,其中不同颜色代表不同的声源,●代表attractor,×代表clue。可以看到每个attractor都能被准确的对应到唯一的clue。通过在测试集中执行InfoNCE的分类功能,即在特征层面把每个attractor对应到唯一的clue中,我们在2mix的音频中实现了86.0%准确率,在3mix的音频中实现了65.3%准确率。
更为通用的场景下的分离任务探究
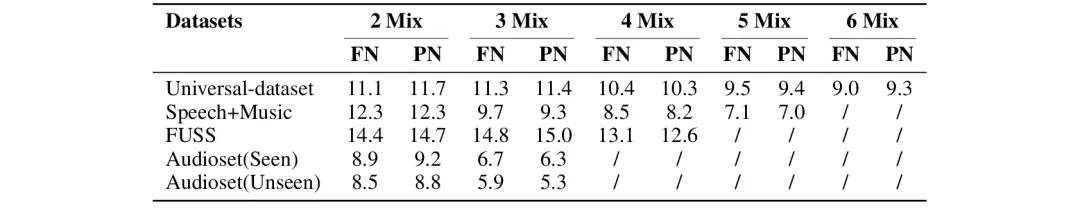
表4.USE-B模型在2~6声源混合情况下的通用声音分离SDRi性能
我们进一步在更为通用的场景下进行了测评,USE模型可以自行估计声源数量并进行分离(PN),也可以指定声源数量并进行分离(FN),我们发现在一些情况下USE估计的声源数量会更合理并且实现了更好的分离性能。同时,我们可以观察到USE模型即使在6源分离下也能够保持优异的分离性能。
总结与展望
在本研究中,我们提出了USE,这是一种统一了通用声音分离与目标声音提取任务的通用方法。这一新颖的方法能够处理多样的声音类型、可变的声源数量,并且能够根据输入中线索的有无,动态选择执行无线索的通用声音分离任务,或是执行单/多模态线索的目标声音提取任务,即使在低质量线索条件下也能实现更鲁棒的提取,为复杂真实场景下的音频处理提供了动态、高效且统一的解决方案。未来,根据具体声学场景和语境需求,实现声源分离粒度的自适应调整(声源间需要分离还是聚合);或者将USE模型与声音事件检测及理解任务相结合,都有望为音频处理提供更全面的解决方案。
参考文献
[1] Li Chenda, et al. "Target sound extraction with variable cross-modality clues." ICASSP 2023-2023 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP). IEEE, 2023.
[2] Chetupalli, Srikanth Raj, and Emanuël AP Habets. "Speech Separation for an Unknown Number of Speakers Using Transformers With Encoder-Decoder Attractors." Interspeech. 2022.
[3] Luo, Yi, and Jianwei Yu. "Music source separation with band-split RNN." IEEE/ACM Transactions on Audio, Speech, and Language Processing 31 (2023): 1893-1901.
