
 语音小管家
标题:FlashLabs Chroma 1.0: A Real-Time End-to-End Spoken Dialogue Model with Personalized Voice Cloning
链接:https://arxiv.org/pdf/2601.11141
作者单位:FlashLabs
发表日期:2026年1月16日
01、引言:现有语音对话系统的“痛点”
延迟高:三步下来,实时对话时会有明显卡顿;
误差传递:前一步错了,后面全歪,比如ASR转错字,LLM理解就错了;
丢“副语言信息”:像说话人的音色、语速、情绪这些关键信息,转文字时就丢了,没法做个性化交互。
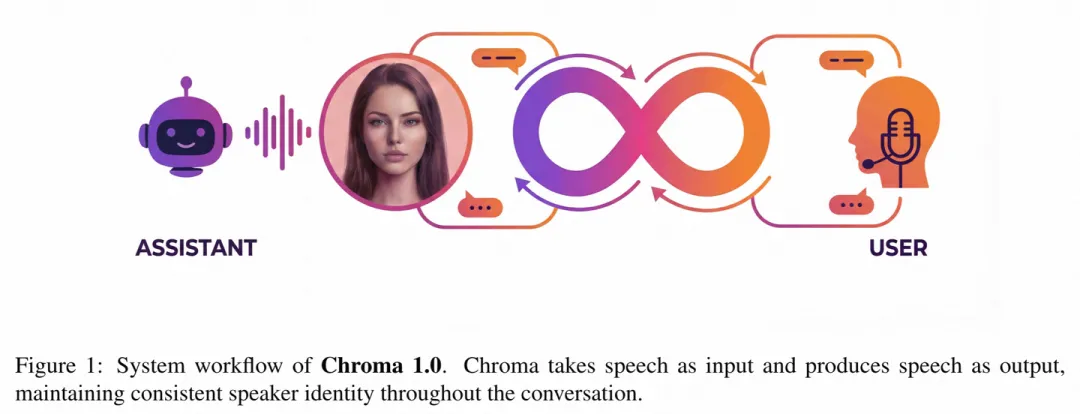
02、模型架构:四个核心组件,还有个“神操作”调度
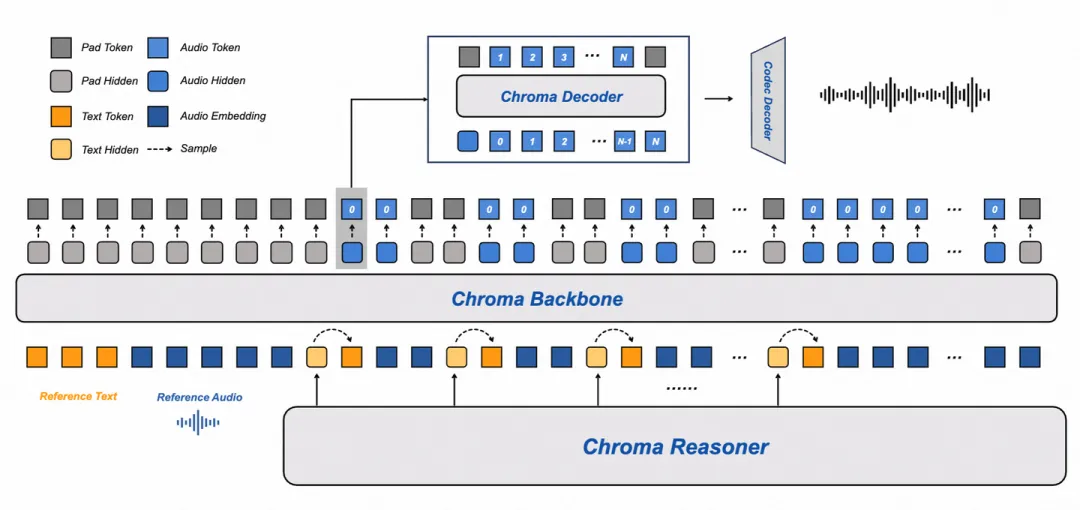
Chroma Reasoner(理解模块):基于Qwen2-Audio的编码 pipeline 改的,负责处理文本和音频输入,输出高层语义表示——不只是文字意思,还包含语音的节奏、语调这些副语言信息。它用了个“跨模态注意力”和“时间对齐的多模态旋转位置编码(TM-RoPE)”,确保文字和语音的时间能对上,为后面生成匹配的语音打基础。训练时这部分是冻住的,只当“特征提取器”。 Chroma Backbone(声学建模模块):用了1B参数的LLaMA架构变体,核心任务是“照着参考语音的音色生成粗粒度音频码本(c⁰)”。怎么保证音色一致?它会把参考音频和对应的文字转成embedding,加在输入序列前面,相当于“告诉模型:就按这个speaker的声音来”。这里有个关键设计:和Reasoner配合时,用“1:2的文本-音频token交错调度”——1个文本token配2个音频码本token。这样不用等Reasoner把所有文字都生成完,Backbone就能同步生成音频,大大降低延迟。 Chroma Decoder(码本细化模块):很轻量,只有100M参数,负责把Backbone生成的粗码本(c⁰)细化成剩下的7个RVQ码本(c¹到c⁷)。它不用看全部历史输入,只需要当前步Backbone的输出,计算量小,进一步降延迟。而且细化过程能补全音色细节,比如说话人的细微语调变化。 Chroma Codec Decoder(波形重建模块):最后一步,把所有8个码本(c⁰到c⁷)拼成完整的离散声学表示,再转成连续的语音波形。用了因果CNN(Causal CNN),保证生成时符合时间顺序,支持流式输出。选8个码本是为了平衡质量和效率——少了质量差,多了延迟高。
先用类似Reasoner的LLM,根据用户问题生成文字回答; 再用TTS把文字回答合成语音,而且让合成语音的音色和参考音频一致; 最后用“文字回答+合成语音”当训练对,让Backbone和Decoder学“怎么克隆音色+生成语音”。
03、核心创新点:这四个点是Chroma的“杀手锏”
Streaming架构,亚秒级延迟:通过语义状态表示把“语音理解”和“生成”紧耦合,不用等全流程跑完,就能流式输出,端到端延迟低于1秒。
高保真语音克隆,几秒钟参考就够:只需要几秒参考音频的embedding,就能让模型学习speaker的音色,最后speaker相似度(SIM)比人类基线还高10.96%。
1:2文本-音频token调度:1个文本token配2个音频码本,让音频和文字同步生成,不用等文字全出来再做TTS,大幅降低“首token时间(TTFT)”。
4B参数兼顾强能力:模型总共才4B参数,却在理解、推理、口语对话任务上表现能打,不像有的模型要么参数大(比如GLM-4-Voice 9B),要么能力弱(比如0.5B的Mini-Omni)。
04、实验部分:从客观到主观,把性能说透了
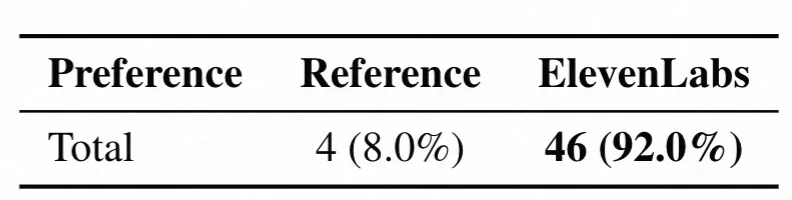
客观指标:speaker相似度(SIM,用WavLM-Large算余弦相似度)、首token时间(TTFT,从输入到出第一个音频token的时间)、实时因子(RTF,生成时间/音频时长,小于1就是比实时快); 主观指标:比较平均意见分(CMOS),分“自然度(NCMOS)”和“speaker相似度(SCMOS)”,让 evaluator 二选一或者说“差不多”。
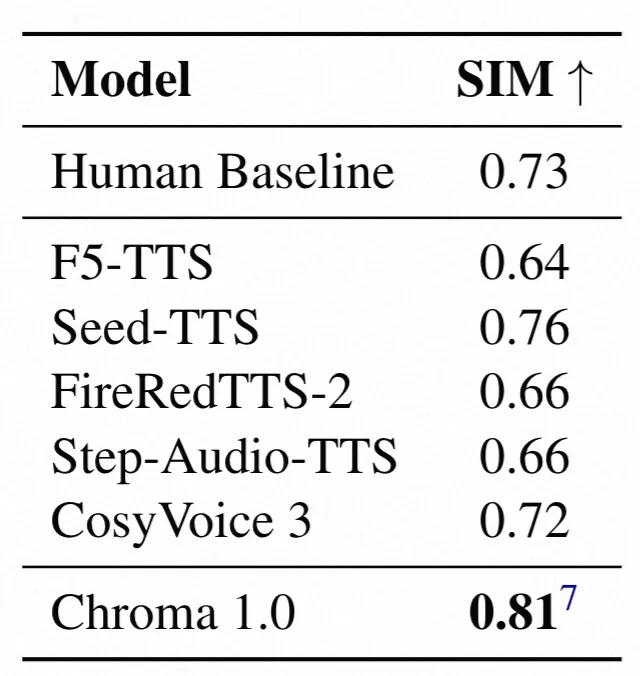
人类基线(真人说话的相似度参考)是0.73; 其他模型比如F5-TTS 0.64、CosyVoice 3 0.72,就算是Seed-TTS也才0.76; 而Chroma直接冲到0.81,相对人类基线提升了10.96%!而且要注意,Chroma用的是24kHz采样率,比其他模型的16kHz更能保音色,这也是它分数高的一个原因。
Table 2:
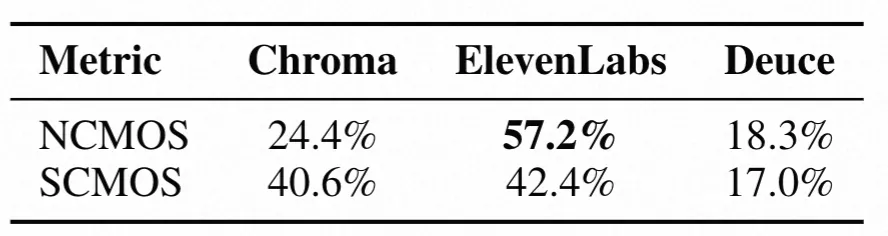
Table 3:
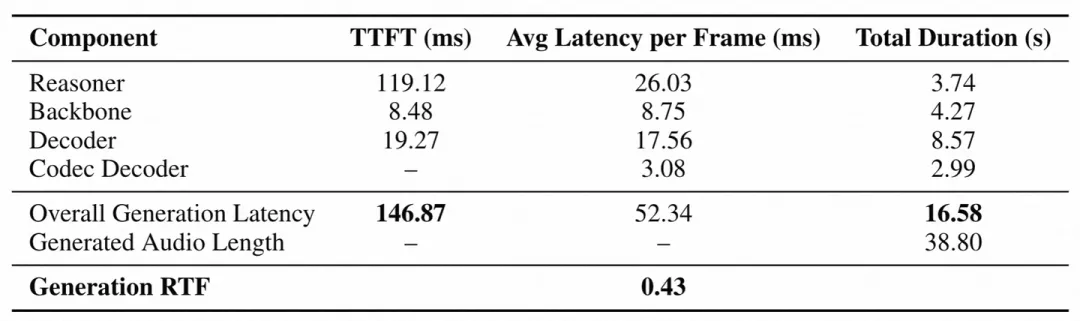
整体TTFT(首token时间)是146.87ms,远低于1秒,对话时几乎感觉不到卡顿; RTF是0.43,也就是生成38.8秒的音频,只需要16.58秒,比实时快2.3倍; 各组件延迟:Reasoner的TTFT最长(119.12ms,毕竟要处理多模态输入),Backbone很快(8.48ms),Decoder每帧平均17.56ms,Codec Decoder每帧3.08ms,整体配合下来延迟控制得很好。
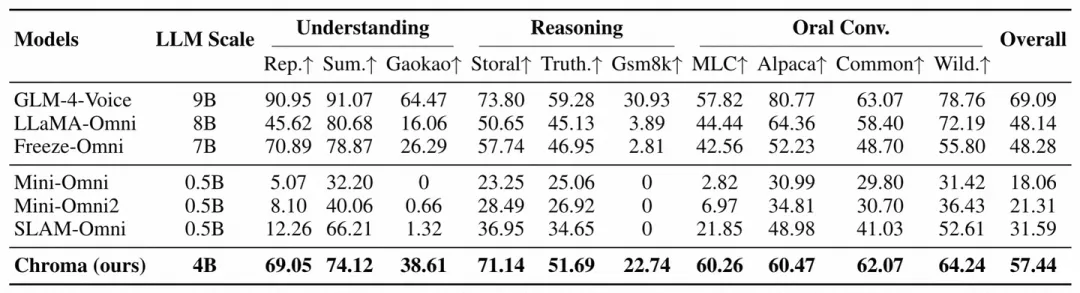
参数只有4B,比GLM-4-Voice(9B)小一半多,但推理能力比如Storal(故事逻辑)71.14%,只比GLM-4-Voice的73.80%低一点;事实判断51.69%,也接近GLM-4-Voice的59.28%; 口语对话里,MLC(日常对话)60.26%、CommonVoice(通用场景)62.07%,都是不错的分数; 最关键的是: 它是这些模型里唯一能做个性化语音克隆的 !其他模型要么只抓对话,要么只抓语音,Chroma是两者都占了,还兼顾了效率(4B参数比7B/9B模型省资源)。
05、结论&未来方向
