
 语音小管家
标题: LEMAS: A 150K-Hour Large-scale Extensible Multilingual Audio Suite with Generative Speech Models 链接: https://arxiv.org/abs/2601.04233 作者单位: International Digital Economy Academy (IDEA) 发表日期: 2026年1月4日 开源地址: https://github.com/LEMAS-Project
随着生成式基础模型的兴起,语音合成(TTS)领域已进入转型期。尽管现有模型在英语和中文等高资源语言上表现出色,但在多语言场景下,尤其是零样本(Zero-shot)生成任务中,仍面临巨大挑战。这一瓶颈的核心已从模型架构设计转移到了数据层面——即缺乏大规模、高质量且具备细粒度对齐的多语言语音语料库。
针对这一问题,IDEA研究院团队提出了LEMAS(Large-scale Extensible Multilingual Audio Suite)。这是一个包含超过15万小时、覆盖10种主要语言的大规模开源多语言语音数据集,并提供了精确的词级时间戳。基于该数据集,论文还发布了两个基准模型:基于流匹配(Flow-matching)的LEMAS-TTS和基于自回归的语音编辑模型LEMAS-Edit。
01 核心贡献:LEMAS数据集
现有的开源多语言数据集(如MLS、Common Voice)往往存在规模有限、领域覆盖窄或缺乏可靠时间对齐的问题;而网络爬取的数据集(如YODAS)虽然规模大,但数据质量参差不齐且缺乏精细标注。
LEMAS数据集通过以下特性填补了这一空白:
规模与覆盖:总时长超过150,000小时,涵盖10种主要语言(中、英、俄、西、印尼、德、葡、越、法、意)。 精细标注:提供严格的词级时间戳(Word-level Timestamps)和置信度评分,这对高精度的语音生成与编辑任务至关重要。 多样性:数据来源广泛,包含有声读物、播客及自然对话场景。
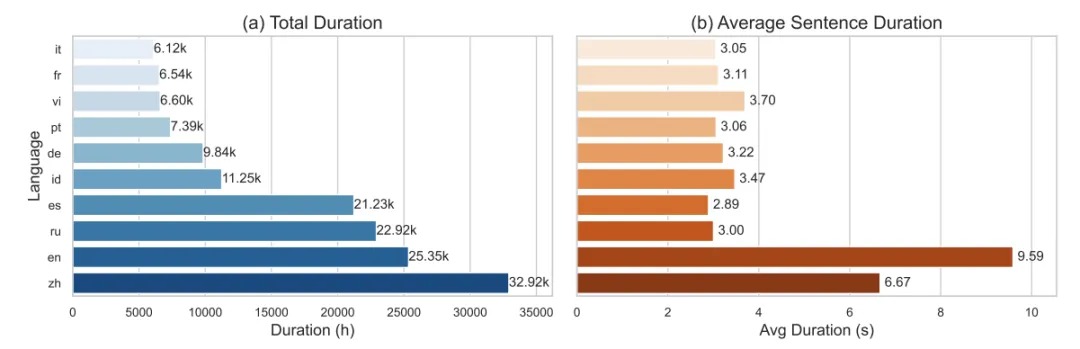
(说明:该图展示了数据集在不同语言上的时长分布及平均句子长度,体现了数据规模的平衡性与多样性。)
数据构建流水线
为了从异构源中构建高质量数据集,作者设计了一套自动化的处理流水线:
数据摄入与统一:整合GigaSpeech、Emilia、MLS等多个公开数据集,统一格式。 多语言MMS对齐:采用基于wav2vec 2.0的MMS强制对齐器(MMS Forced Aligner),将文本转换为统一的罗马化注音或音素,提取词级时间戳和置信度。 基于置信度的质量过滤:剔除对齐置信度低、时长异常或静音过长的样本,确保用于训练的数据具有极高的文本-音频一致性。
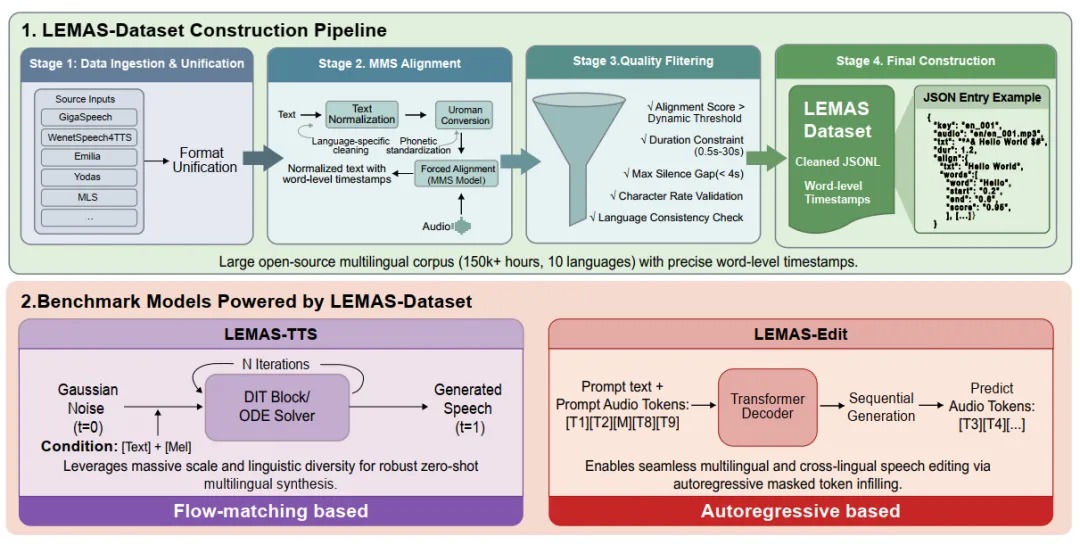
(说明:该图上半部分详细展示了LEMAS数据集的构建流程,包括对齐、过滤和最终的JSON构建;下半部分展示了基于该数据集训练的两个核心模型架构。)
02 模型架构创新
为了验证LEMAS数据集的有效性,作者提出了两个针对不同任务的生成模型。
1. LEMAS-TTS:基于流匹配的多语言合成
该模型基于F5-TTS架构(DiT + Flow Matching),并针对多语言场景进行了关键改进:
统一语音表示:摒弃了传统的混合字符/词级输入,前端采用IPA(国际音标)序列(中文采用带声调拼音),并将所有语言映射到共享的潜在空间,通过显式的语言ID进行区分。 辅助稳定目标:引入了CTC对齐损失(CTC Alignment Loss)以强制声学轨迹与语言内容的单调性,解决长文本生成的稳定性问题;同时引入口音对抗训练(Accent-Adversarial Disentanglement),通过梯度反转层(GRL)解耦说话人音色与口音,防止跨语言合成时的口音泄漏。 跨语言韵律建模:集成了基于ECAPA-TDNN的韵律编码器,提供显式的韵律监督。 动态制导与Sway采样:重新设计了分类器自由引导(CFG)和时间规整策略,采用随时间衰减的引导强度,在生成初期强调结构准确性,后期保留声学自然度。
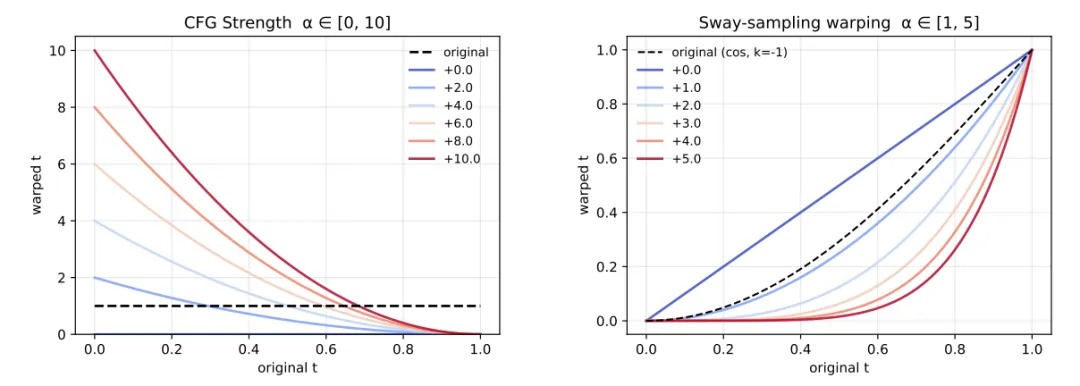
(说明:该图展示了改进后的CFG强度调度和Sway采样时间规整曲线,解释了如何通过动态调整采样策略来提升生成稳定性。)
2. LEMAS-Edit:基于掩码补全的语音编辑
该模型基于VoiceCraft架构,是一个自回归的Decoder-only模型,将语音编辑建模为掩码Token填充任务:
历史感知重复控制(History-Aware Repetition Control):针对自回归模型易出现的重复生成问题,引入了动态惩罚机制,根据Token生成的历史频率动态调整Logits,有效抑制了“结巴”或死循环现象。 自适应重生成(Adaptive Re-Generation):在推理阶段建立反馈回路,根据参考音频的语速动态约束生成长度,若检测到异常(如生成过短或触发异常标志),系统会自动调整参数重试。
03 实验与结果
实验部分将LEMAS-TTS与同期的开源模型OpenAudio-S1-mini进行了对比,评估指标包括字错误率(WER)和说话人相似度(SIM)。
核心结论
性能优势:在多语言测试集中,LEMAS-TTS在绝大多数语言上的WER均显著低于OpenAudio-S1-mini,且说话人相似度更高。特别是引入韵律编码器(w/ prosody)后,WER进一步降低,证明了显式韵律建模对稳定性的贡献。 零样本能力:依托于15万小时的多样化数据,模型展现了强大的Zero-shot跨语言合成能力,能够在保留目标说话人音色的同时,生成流利的外语语音。 编辑自然度:主观A/B测试显示,LEMAS-Edit在语音编辑任务中生成的边界更加平滑,听感自然度优于对比基线。
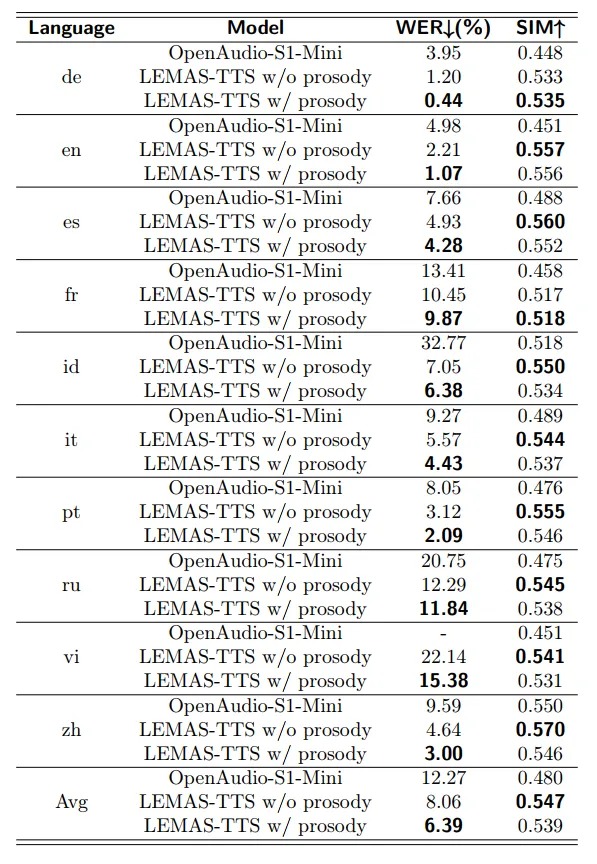
(说明:该表格详细列出了LEMAS-TTS与OpenAudio-S1-mini在10种语言上的WER和SIM对比数据,直观展示了模型的性能优势。)
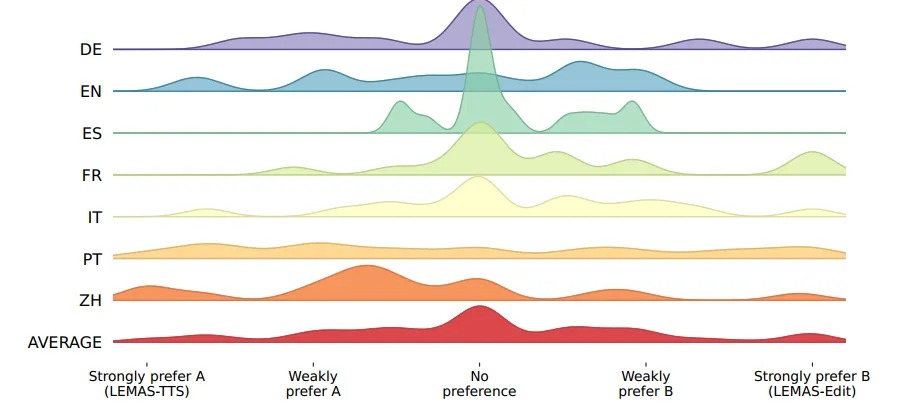
(说明:该图展示了针对不同语言的语音自然度主观偏好测试结果,LEMAS-TTS和LEMAS-Edit在多数语言中获得了更高的用户偏好。)
04 总结
本研究通过发布 LEMAS 数据集,解决了多语言语音生成领域长期存在的高质量数据匮乏问题。其严格的构建流程和精细的词级对齐,为训练下一代高鲁棒性、高自然度的多语言 TTS 及语音编辑模型提供了坚实基础。实验结果表明,基于该数据集训练的模型在跨语言合成与精准编辑任务上均达到了业内领先水平。
