
 语音小管家
基于查询的通用声音分离(USS)技术旨在通过文本、音频等多模态提示从混合信号中分离出目标声音。这项技术能够应用于沉浸式音频渲染、智能音频编辑和辅助听力设备等应用,实现对复杂声学环境中任意声源的精准提取。
尽管近年来方法架构不断演进,现有基于查询USS方法在复杂场景中仍存在残留干扰问题。团队认为这一缺陷源于训练数据的系统性偏差:当前方法依赖AudioSet等野外数据集,这些数据集存在弱标签和事件共现问题。例如,"雨声"片段中经常包含风声,模型因此将背景噪声错误学习为目标特征。
为解决这一数据瓶颈,团队提出了一套自动化数据清洗与合成流程,并构建了Hive数据集——包含约2.4k小时高质量原始音频。实验表明,在Hive上训练的模型仅使用SAM-Audio数据量的约0.2%,即可达到与该百万小时级SOTA模型相当的分离性能。
论文地址:
论文代码:
样例展示:
🎧当前通用声音分离方法存在的问题
弱标签与事件共现:野外数据集标签与实际内容错位,单一标签片段中常包含多个未标注事件。
随机混合策略不合理:现有方法随机混合训练数据,产生语义不合理的组合(如水生动物与城市交通同现)。
暴力扩展范式:当前追求更大规模数据和模型(如SAM-Audio使用约100万小时音频),计算成本极高。
🔊Hive的主要贡献如下
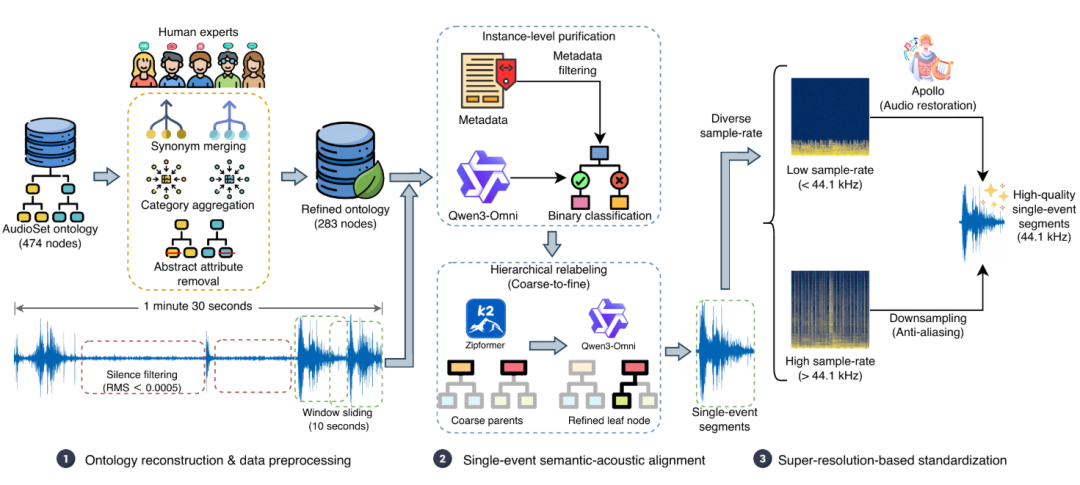
图1. Hive数据构建流程概览
贡献1:自动化单事件数据收集流程(如图1所示),包含三个阶段:
1. 本体重构与预处理:将AudioSet的474个叶节点精简为283个语义清晰的分离导向类别,合并同义标签、聚合细粒度类别、排除抽象属性标签。
2. 单事件语义-声学对齐:通过元数据过滤排除多标签样本;利用Qwen3-Omni零样本分类拒绝多事件片段;采用粗到细策略,先用AudioTag预测粗类别,再用Qwen3-Omni细化到叶节点。
3. 超分辨率标准化:统一采样率到44.1kHz,使用Apollo模型重建低频音频的高频谐波。
贡献2:语义一致的混合策略
为避免语义不合理的混合,通过Qwen3-Omni构建二元共现矩阵,仅允许时空上可能共存的事件组合进行混合(如允许"打字"与"空调"共现,拒绝逻辑矛盾组合)。混合时SNR从[-5,5]dB随机采样以模拟多样声学条件。
贡献3:大规模高质量Hive数据集
从12个公开数据集聚合原始音频,经严格清洗得到约0.9M个独立片段(共计约2,442小时)。最终Hive包含1960万个混合样本(约22.4k小时),划分为训练集(17.5M)、验证集(1.75M)和测试集(350k)。Hive预留292小时独立未混合音源用于验证和测试,显著超过现有基线的评估集规模。数据集采用复杂度偏向分布,5源混合占比约35%。
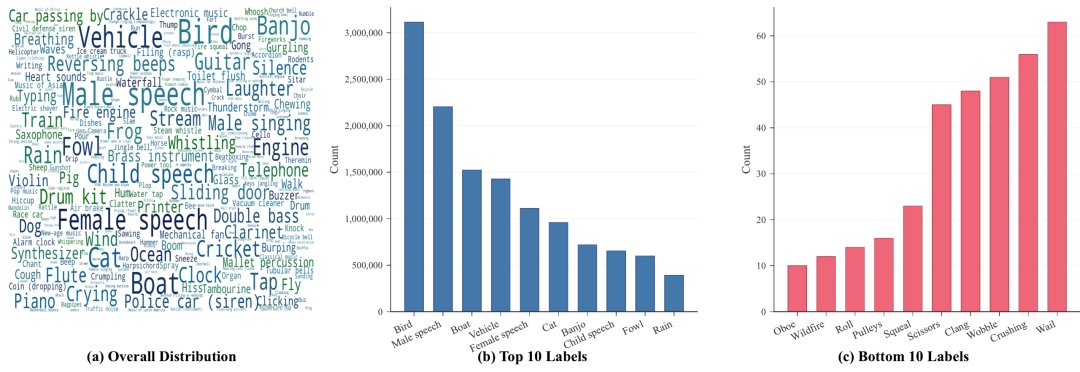
图2. Hive数据集标签频率分布
🎰语义-声学对齐的人类测评验证
为定量验证Hive数据流水线的标注纯度,团队设计了一项四选一强制选择(4-AFC)音频事件识别实验。实验随机抽取20个音频片段,招募38名参与者(均佩戴耳机在线完成),每人独立为每段音频从四个候选标签中选择最匹配的类别。评估者间一致性极高(Fleiss' κ=0.863),以多数投票结果作为真值标准,人类平均准确率为91.89%。
团队将Hive流水线与人类评估者及三个代表性大型音频语言模型(MiDashengLM、MiMo-Audio、Qwen3-Omni)进行对比。结果如表1所示,Hive流水线达到95.00%的准确率,超越人类平均表现(91.89%)和最优音频语言模型Qwen3-Omni(90.00%),配对t检验证实这一提升具有统计显著性(p=0.03<0.05)。这表明Hive的粗到细对齐有效纠正了模型幻觉,所生成的监督信号纯度优于人工标注。
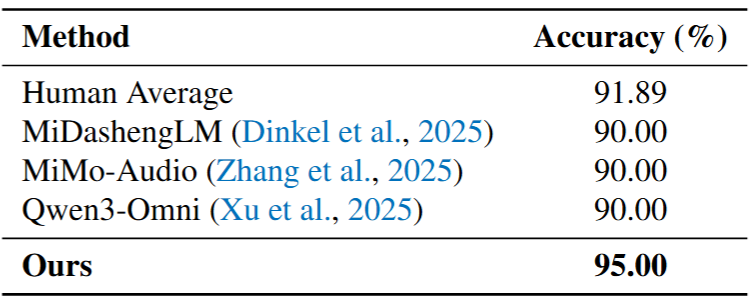
表1.4-AFC音频事件识别任务性能对比(20个片段,随机猜测准确率为25%)
🎰Hive测试集零样本结果
在Hive测试集,团队对比了判别式模型(LASS-Net、CLIPSep、AudioSep、OmniSep)和生成式模型(ZETA、FlowSep、ZeroSep、DGMO、SAM-Audio)。表2展示了各模型在Hive测试集上的零样本性能(2-5源混合平均)。使用Hive训练的AudioSep达到5.67dB SDR,大幅超越原始AudioSep的2.37dB。早期方法如CLIPSep性能急剧下降(SDR<0dB),表明它们严重依赖共现偏差作为"捷径"——Hive的去相关混合通过移除这些上下文"作弊码"暴露了这种脆弱性。生成式模型(如SAM-Audio)在感知指标上表现较好(FAD≈1.0),但在语义保真度上落后(CLAP-T),表明存在条件合成而非真正提取的倾向。
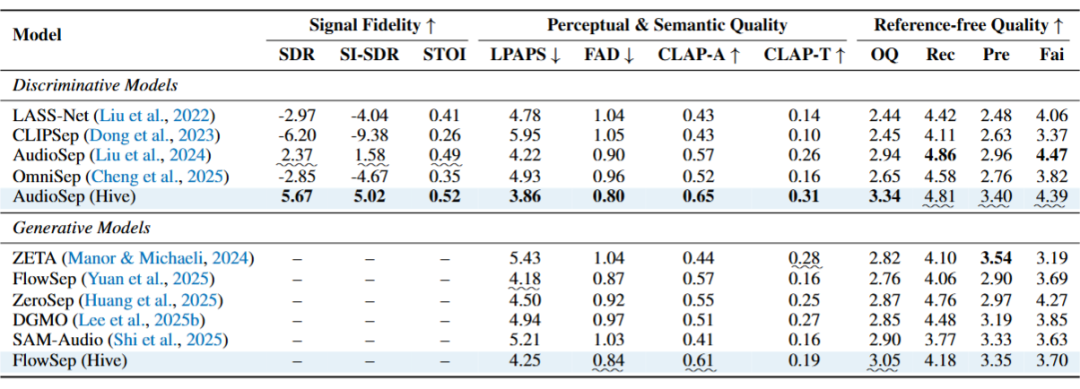
表2. Hive测试集零样本结果(2-5源混合平均)
🎰第三方测试集跨域泛化结果
为评估零样本泛化能力,团队在两个分布外基准上进行测试:MUSDB18-HQ(音乐分离)和USS-Bench。如表3所示,使用Hive训练的AudioSep(2.4k小时)显著优于使用14.1k小时原始数据训练的版本:
USS-Bench:SDR从-1.86dB提升至2.29dB(提升超4dB),无参考OQ从2.97提升至3.56;
MUSDB18-HQ:SDR从-1.01dB提升至1.36dB。
尽管Hive数据量仅为SAM-Audio的约0.2%(2.4k vs. 1M小时),在USS-Bench上AudioSep(Hive)的FAD达0.75(SAM-Audio为0.90),CLAP-Audio达0.69(SAM-Audio为0.57)。在真实世界数据集上的优越表现证实了这些在合成混合上训练的模型能够有效泛化到真实声学环境。
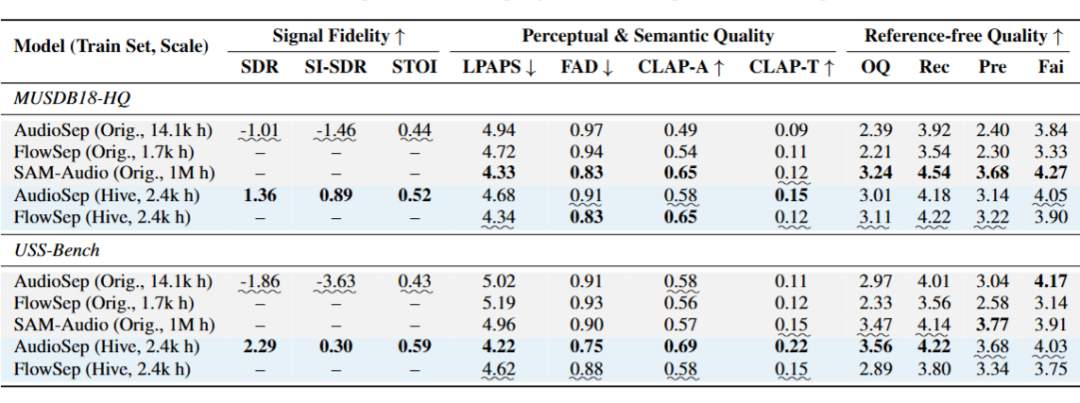
表3. 第三方测试集性能对比
当前通用声音分离领域普遍追求更大规模的数据和模型来提升性能,然而这带来了巨大的计算成本和可复现性障碍。本工作提出了一套自动化数据清洗与合成流程,并构建了Hive数据集。大量实验表明,在Hive上训练的模型达到了与百万小时级SAM-Audio相当的分离精度和感知质量,而所使用的数据量仅为其约0.2%。这些发现验证了团队的核心论点:优先确保监督信号的纯净性为暴力扩展提供了数据高效的替代方案,为开发鲁棒的通用声音分离模型提供了一条可复现的路径。
