
 语音小管家
在大语言模型(LLM)的演进中,文本分词器(Tokenizer)作为离散接口,为模型的压缩、理解、生成与上下文学习奠定了基石。然而,在音频领域,如何构建一个简单、同构且具备强大扩展潜力(Scalable)的离散接口,依然是通往“原生音频大模型(native audio language models)”道路上的核心挑战。
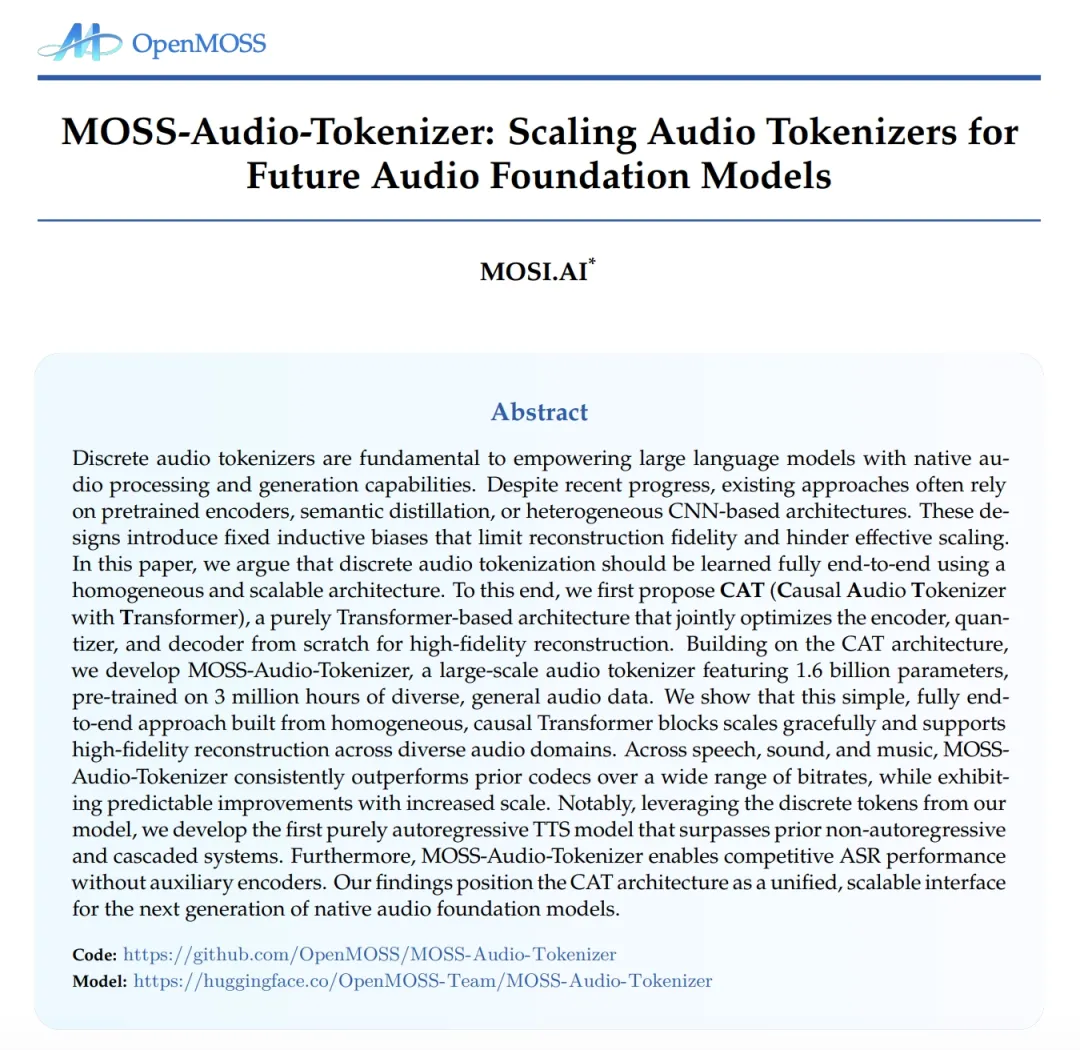
近日,模思智能联合 OpenMOSS 团队和复旦大学发布了技术报告《MOSS-Audio-Tokenizer: Scaling Audio Tokenizers for Future Audio Foundation Models》,并开源了拥有16 亿参数的音频分词器MOSS-Audio-Tokenizer。
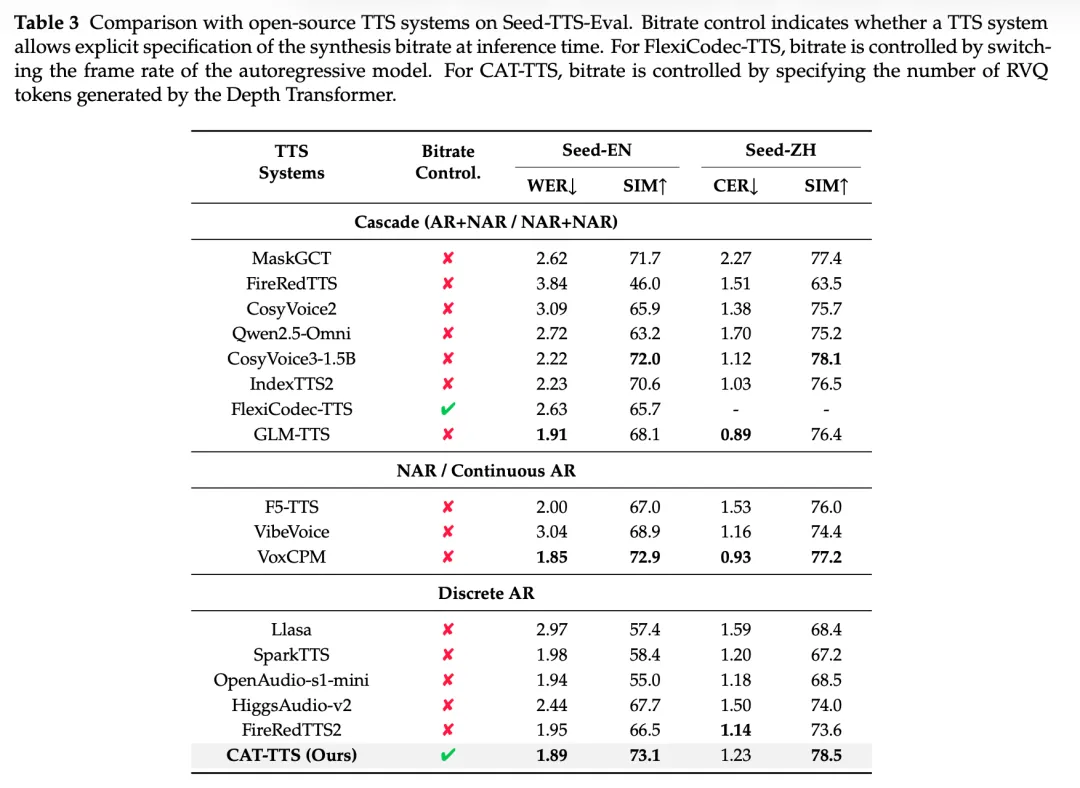
MOSS-Audio-Tokenizer 不仅在音频重建质量上达到 SOTA,更在下游任务中展现了显著潜力:团队首次证明了基于纯离散自回归(AR)架构的 TTS 性能可以全面超越非自回归(NAR)及级联系统。
Technical report:https://arxiv.org/abs/2602.10934
Source code:https://github.com/OpenMOSS/MOSS-Audio-Tokenizer
Hugging Face:OpenMOSS-Team/MOSS-Audio-Tokenizer
Demo page:https://mosi.cn/models/moss-tts
⏩核心洞察:现有架构的局限与理想接口的特征
团队通过对现有音频分词器(Audio Tokenizer)的深入分析发现,现有架构普遍存在以下三个瓶颈(Bottlenecks):
架构异构性与固定的归纳偏置(Inductive Bias):现有模型多依赖 CNN 结构或 CNN-Transformer 混合架构。虽然卷积擅长局部建模,但其固定的归纳偏置限制了模型在参数规模扩展时的灵活性。
对外部先验的过度依赖:许多模型依赖预训练编码器(如 HuBERT,Whisper 编码器)或语义蒸馏。这虽然降低了训练难度,但也引入了外部模型的性能上限(Ceiling),导致系统无法完全从海量原始数据中自主学习最优表征。
非端到端的优化限制:常见的“阶段性优化”(Stage-wise optimization)限制了各组件间的协同进化,导致性能在计算资源增加时过早饱和。
针对这些问题,团队认为,一个适合音频基础模型(Audio Foundation Model)的音频分词器必须满足:纯同构(Homogeneous)、严格因果(Causal)以及易于进行规模化扩展(Easy to scale up)。
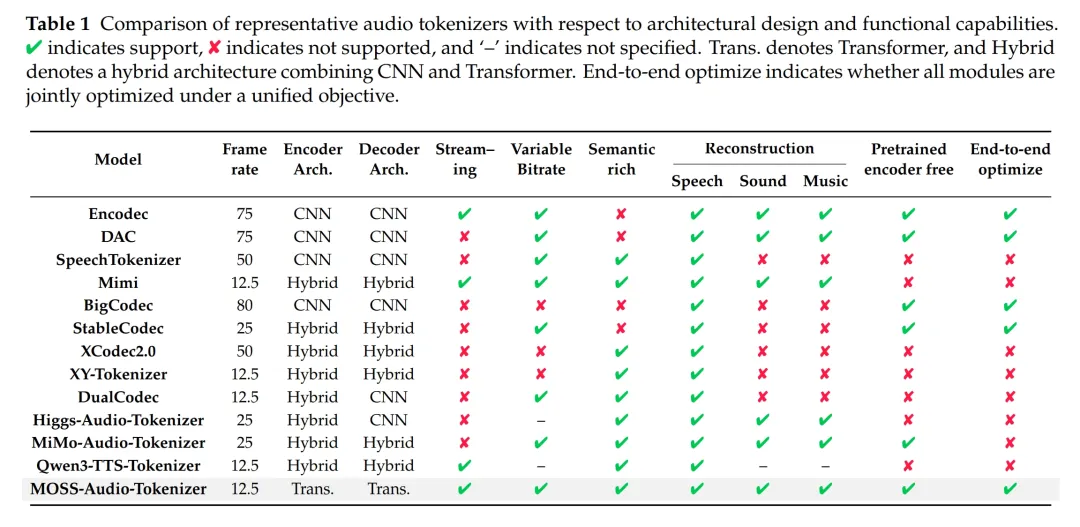
MOSS-Audio-Tokenizer 和开源 Audio Tokenizer 的对比
⏩CAT 架构:同构与极简的扩展范式
基于上述洞察,团队提出了CAT(Causal Audio Tokenizer with Transformer)架构。
核心特性:
高压缩比与变比特率:支持将 24kHz 音频压缩至 12.5 fps。基于 32 层 RVQ 机制,模型可在 0.125-4kbps 范围内实现灵活的码率调节,满足不同场景下的高保真重建需求。
纯 Transformer 同构架构:采用无 CNN 的全因果 Transformer 设计。其 16 亿参数规模确保了强大的模型容量与可扩展性,并且可以支持帧级别的流式编码与解码。
通用音频表征能力:历经 300 万小时超大规模音频数据的预训练,覆盖语音、音效、音乐等全领域,具备极强的泛化能力。
语义-声学统一表征:MOSS Audio Tokenizer 编码得到的离散 Token 在保持 SOTA 级高保真还原音质的前提下,还蕴含了丰富的语义信息,能天然适配自回归生成模型的建模需求。
零预训练依赖:避开了对现有音频预训练模型(如 Whisper、HuBERT)的依赖或蒸馏,完全通过原始数据自主学习音频特征。
端到端联合训练:实现所有模块(编码器、量化器、解码器,判别器及用于语义对齐的 LLM )的全闭环联合优化,确保系统整体性能的协同提升。
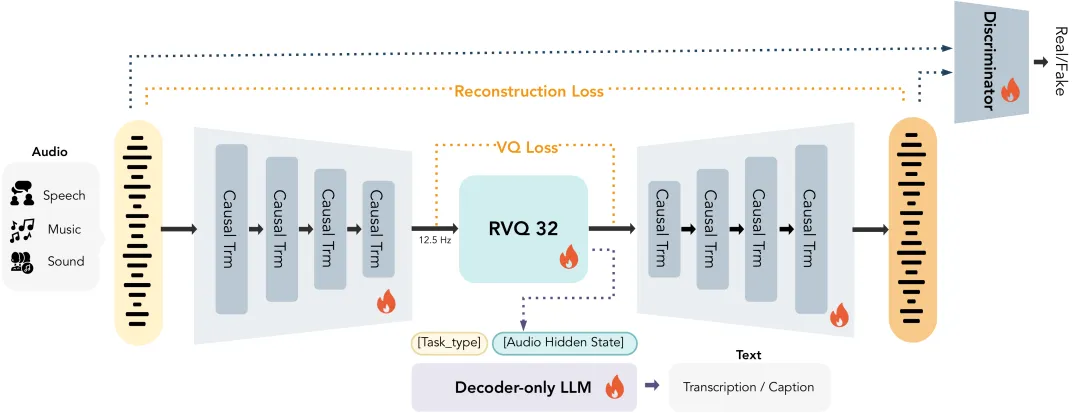
MOSS-Audio-Tokenizer 架构图
⏩规模化行为(Scaling Behavior)研究:如何驱动性能飞越?
为了探索音频分词器的规模化能力,团队进行了系统的实验研究,揭示了驱动性能提升的关键因素:
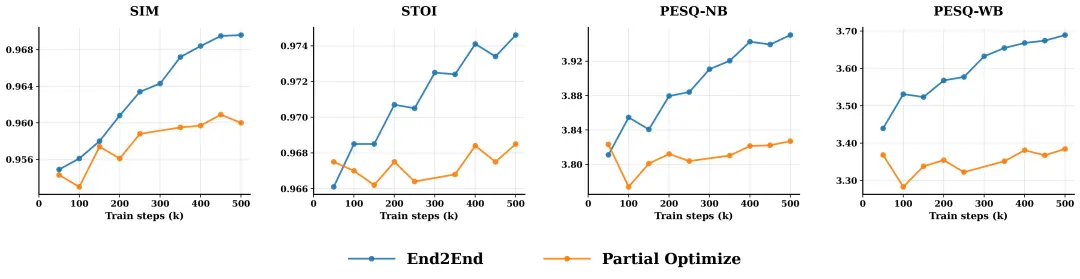
1. 全端到端联合优化(Full End-to-End Joint Optimization)
团队对比了“全端到端联合优化”与“部分 / 阶段性优化”(Partial / Stage-wise optimization)的效果。实验发现,只有实现编码器、量化器、解码器乃至语义模块的全闭环联合优化,模型的性能才能随着计算量的提升而获得更显著的增长。若采用冻结部分模块的策略,模型性能会很快进入平台期。
2. 协同扩展(Co-Scaling)
团队研究发现,在规模化过程中,编码器、量化深度(Quantization depth)与解码器必须同步提升容量。若其中任一模块成为瓶颈(Bottleneck),增加其他模块的参数量将无法带来预期的重建收益。实验证明,只有各模块协同扩展(Co-scaling),才能最大化提升整体性能。
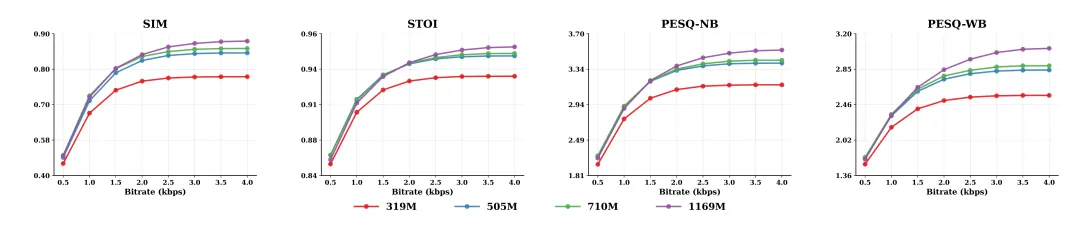
3. 训练计算量(Training Compute)的持续收益
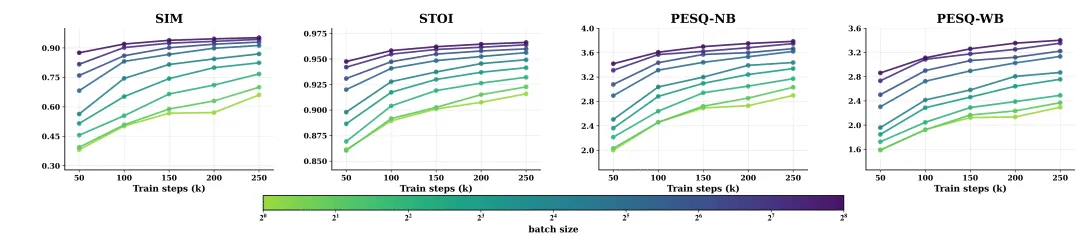
实验证明,CAT 的性能随着训练批次(Batch Size)的增加表现出稳定的提升。在固定训练步数的情况下,增加数据吞吐量能系统性地增强表征的保真度。这种可预测的扩展性(Predictable scaling)验证了 CAT 架构在大规模算力投入下的鲁棒性。
⏩实验结果:全领域、全比特率的 SOTA 重建
在经过 300 万小时海量数据(覆盖语音、环境音、音乐)的预训练后,MOSS-Audio-Tokenizer 展示了卓越的泛化能力:
跨领域高保真:在 0.125kbps 到 4kbps 的变比特率区间内,其重建质量全面超越了 EnCodec, DAC, MiMo-Audio-Tokenizer 以及 Qwen3-TTS-Tokenizer 等主流开源模型。
多维度领先:无论是在 LibriSpeech 语音数据集还是 AudioSet 通用音频集上,MOSS-Audio-Tokenizer 均取得了最优的客观指标。
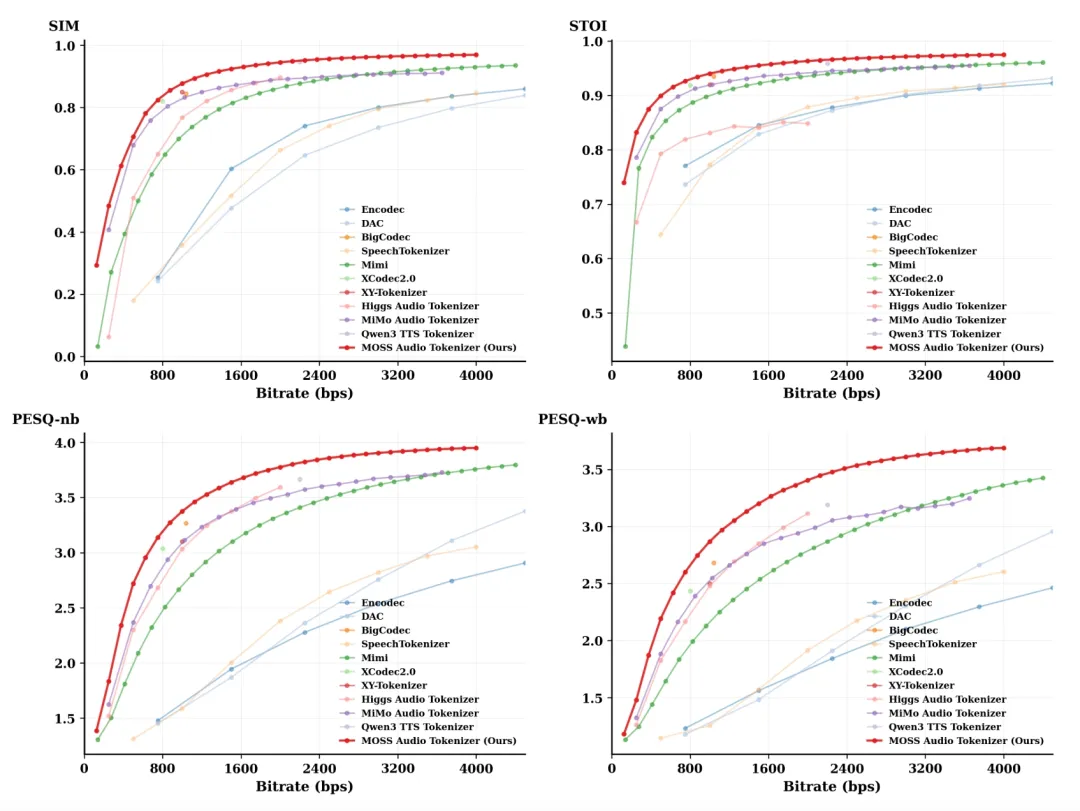
MOSS-Audio-Tokenizer 和开源 Audio Tokenizer 在 LibriSpeech 上客观指标的对比,MOSS-Audio-Tokenizer 在各比特率下均处于领先
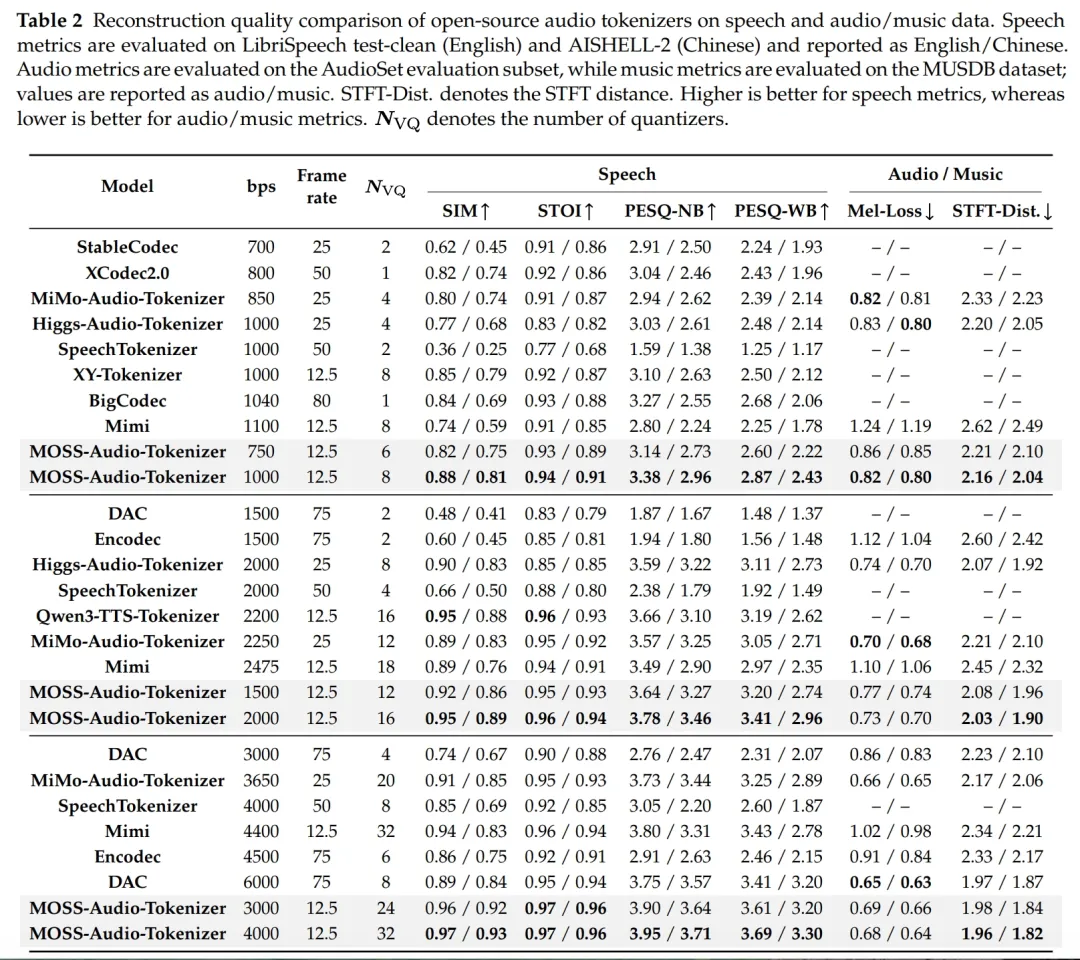
MOSS-Audio-Tokenizer 和开源 Audio Tokenizer 在中 / 英文语音数据集,通用音频数据集,音乐数据集上重建客观指标的对比,MOSS-Audio-Tokenizer 在全比特率,全 domain 上处于领先
⏩下游任务突破:纯 AR TTS 的里程碑
除了作为音频分词器 (Audio Tokenizer),团队进一步验证了 MOSS-Audio-Tokenizer 作为音频大模型的统一接口在生成与理解任务中的卓越表现:
1. 纯自回归(AR)TTS 首次超越级联系统
长期以来,纯自回归的离散 TTS 虽然结构简洁,但其客观指标往往难以抗衡非自回归(NAR)或级联系统(如 AR + NAR 范式)。然而,依托 CAT 提供的高质量 Token,团队构建了CAT-TTS系统。实验结果显示,纯 AR 架构的 TTS 在说话人相似度与自然度上首次超越了 SOTA 级的 NAR 及级联系统。
2. 渐进式序列丢弃(Progressive Sequence Dropout)
为了使单一模型适配不同比特率场景,团队提出了Progressive Sequence Dropout训练策略。该策略使 CAT-TTS 具备了推理时的比特率自适应能力,模型能够在一个框架下支持不同精度的语音生成。
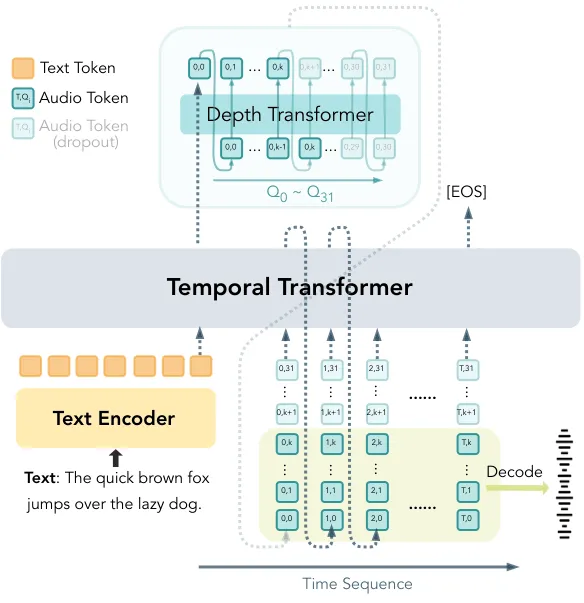
团队在基于 Temporal Transformer + Depth Transformer 的纯 AR TTS 范式上引入了渐进式序列丢弃,使得同一个 TTS 模型能够自适应不同的比特率,以适用于不同的场景。
3. 原生语音理解
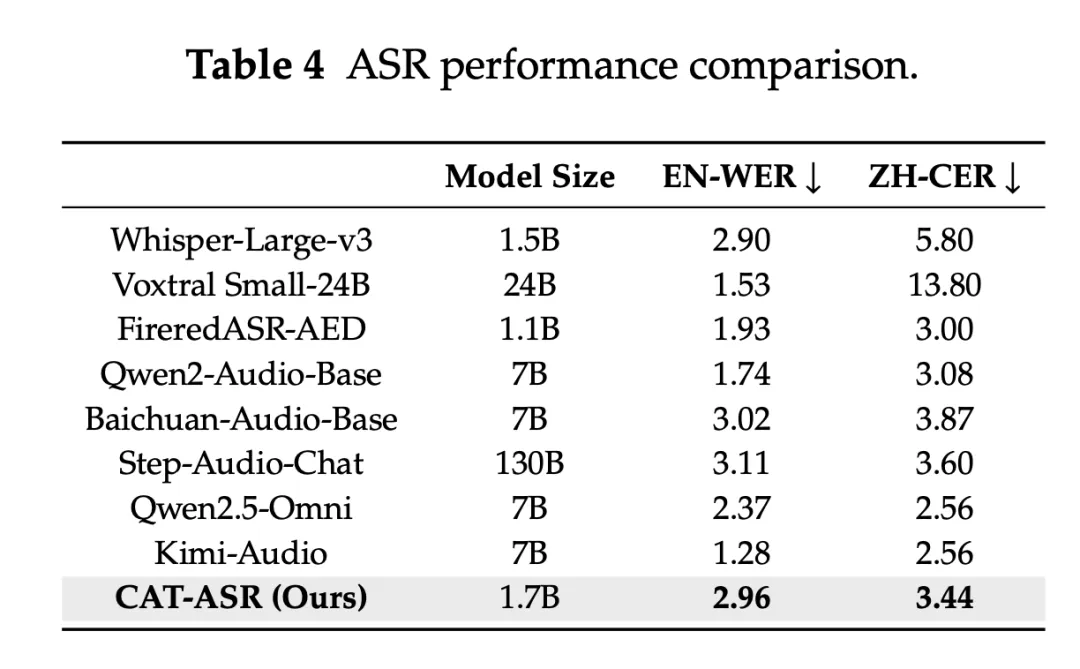
团队发现,无需任何辅助音频编码器,直接将 CAT Token 输入 LLM 即可实现高精度的 ASR 识别。这证明了 CAT 在端到端训练中已经自发学习到了极强的语义对齐能力。
📦 MOSS-TTS Family:全场景音频生成解决方案
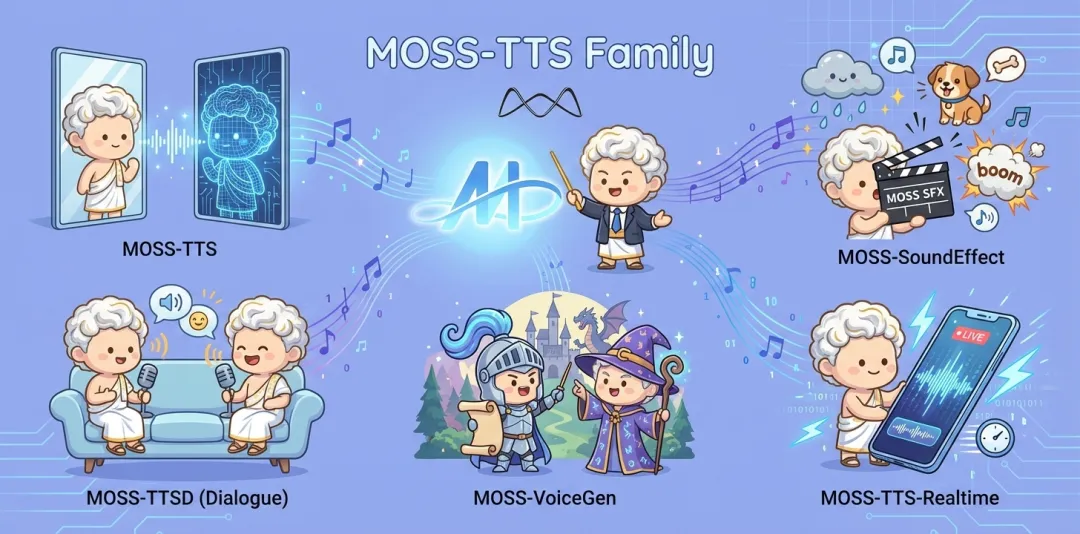
依托 MOSS-Audio-Tokenizer 这一统一接口的底层支撑,团队同步推出了覆盖声音生产全链路的生产级全栈模型矩阵 ——MOSS-TTS Family。
这并不是单一能力的堆叠,而是一整套可以直接接入创作流程、产品系统与交互场景的声音生产工具链。其核心成员包括:
MOSS-TTS:旗舰级语音生成基座,主打高表现力克隆与精确时长控制。
MOSS-TTSD:对话专家,面向播客、解说等真实复杂的多人对话场景。
MOSS-VoiceGenerator:声音设计层,通过指令精准定义角色的性格、情绪与表演状态。
MOSS-TTS-Realtime:实时交互系统,为 Voice Agent 提供极低延迟的流式语音输出。
MOSS-SoundEffect:意境补全,根据文本直接生成身临其境的环境音与音效。
GitHub 仓库:https://github.com/OpenMOSS/MOSS-TTS
Hugging Face:https://huggingface.co/OpenMOSS-Team/MOSS-TTS
⏩结 语
团队认为,通往通用音频智能的道路,必然要求底层接口具备极简的逻辑与强大的扩展潜力。MOSS-Audio-Tokenizer 的开源不仅提供了一个高性能工具,更验证了“纯 Transformer 同构 + 全端到端优化”这一技术路径在音频领域的有效性。
目前,MOSS-Audio-Tokenizer 的论文、代码及模型权重已全部公开,团队希望这一统一接口能成为社区构建下一代原生音频基础模型的坚实基石。
