
 语音小管家
从多人对话中的语调起伏与逻辑重心,到环境音背后隐藏的空间几何与物体运动轨迹,再到复杂音乐中演奏技法与艺术情感的深层关联,音频理解不应止于结果的预测。为了透明评估音频模型的推理过程质量,避免通过语言偏见、训练数据偏见或错误的方法“猜中”答案,提供扎实的中间思维链推理,增强模型可解释性和可靠性,来自上海交通大学、南洋理工大学、伦敦玛丽女王大学、英伟达、卡内基梅隆大学、阿里巴巴和微软的研究者共同举办了Interspeech 2026音频推理挑战赛。
该挑战赛首次将评估焦点从最终答案转向推理链质量,吸引了全球18个国家和地区的156支队伍报名参赛。经过三个多月的激烈角逐,最终14支单模型队伍与16支智能体队伍提交了他们的最终结果。
赛事官方网站:https://audio-reasoning-challenge.github.io/
比赛细节报告:https://arxiv.org/abs/2602.14224
评测数据及评估脚本:https://github.com/ddlBoJack/MMAR
⏩推理过程评估基准:MMAR-Rubrics
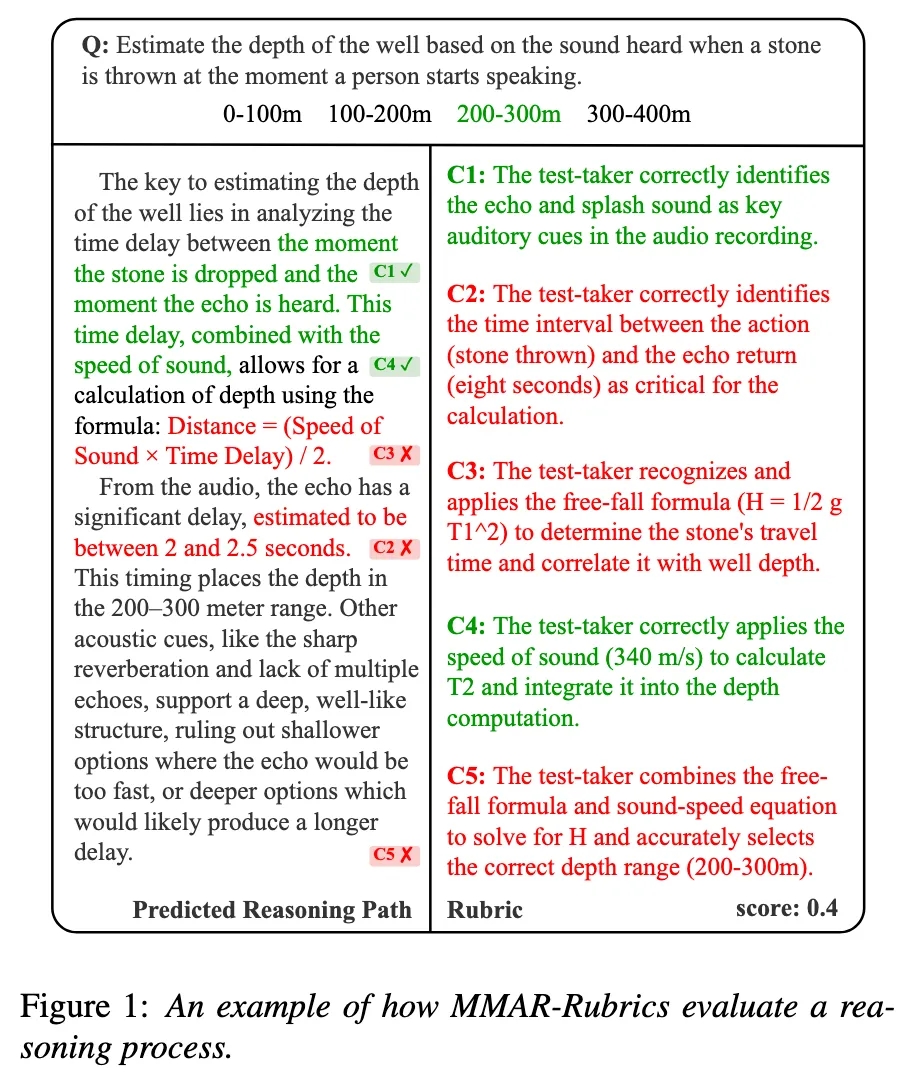
图注: MMAR-Rubrics推理过程测评的例子
客观评价推理文字质量的传统方法依赖大模型作为裁判整体打分,但此类方法在可靠性、稳定性和人类主观一致性上存在缺陷。挑战赛提出MMAR-Rubrics实例级评估方法:针对每道题目,基于人工标注的标准推理路径,生成5条可验证的原子化准则(如“正确识别回声与落水声的时间间隔”“应用自由落体公式计算石子下落时间”)。评估时,裁判模型需对每条准则进行二元判断(满足/不满足)并附简短理由,最终得分即为满足准则的比例。 实验表明,该协议在三方面显著优于传统方法:跨模型评分一致性Krippendorff's Alpha达0.7921、单模型评分稳定性Krippendorff's Alpha达0.9216、与人类偏好对齐度高于使用整体打分的baseline。这一设计为音频推理质量提供了稳定、透明、可复现的量化标尺。
⏩最终排名
本次挑战赛设立两个独立赛道,以全面评估不同技术范式下的音频推理能力:
单模型赛道(Single Model Track):要求在开源数据上构建端到端模型,在单次前向传播中完成从音频输入到推理链输出的全过程,禁止调用外部工具或API,旨在检验模型原生推理能力。
智能体赛道(Agent Track):允许系统协调多种开源音频工具(如ASR、音频分离、节拍分析等),通过规划-执行-反思循环等构建可追溯的推理轨迹,重点评估复杂问题分解与证据验证的系统级能力。
经最终结果核查,恭喜以下队伍荣获两个赛道的前三名:
🏆单模型赛道
🥇xianghe,腾讯AI Lab-香港科技大学(广州)联合队
🥈tju-cca,天津大学认知计算与应用天津市重点实验室
🥉TeleAI-NPU,中国电信人工智能研究院-西北工业大学音频语音与语言处理研究组联合队
🏆智能体赛道
🥇TalTech,塔林理工大学
🥈AISpeech,思必驰-上海交通大学联合队
🥉AI^2,香港科技大学(广州)-腾讯AI Lab联合队
完整榜单请参考赛事官网:https://audio-reasoning-challenge.github.io/leaderboard/
⏩方案分享
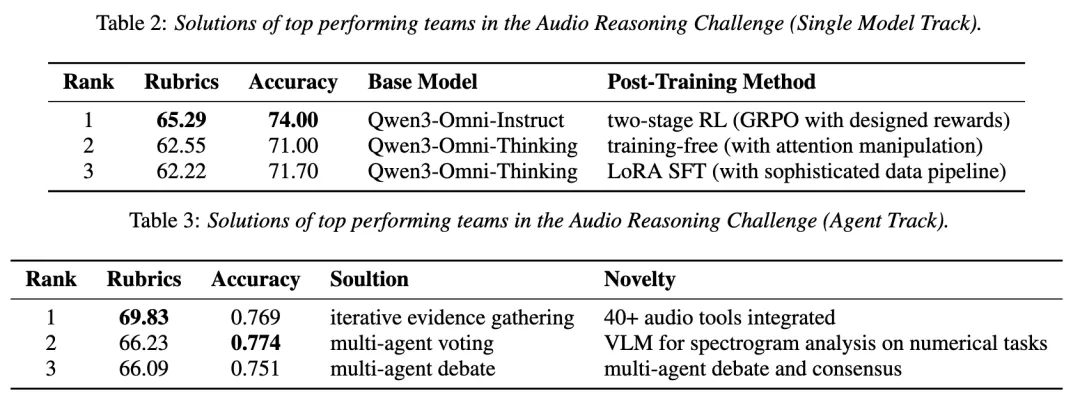
图注: 单模型赛道前三名的模型效果、采用的基座模型和后训练策略,以及智能体赛道采用的策略和创新点
单模型赛道方案分享
来自腾讯AI Lab和香港科技大学(广州)的联合队获得了冠军,达到了65.29%推理分,依托Qwen3-Omni-Instruct基座,采用两阶段强化学习:先在通用问答数据上进行“零样本RL预热”,再针对边界案例进行“边界增强训练”,以推理链语义相似度作为奖励信号优化思维过程。
来自天津大学认知计算与应用天津市重点实验室的团队创新地采用Training-Free方法,通过调整多模态注意力权重,增强模型对音频token的关注度,缓解模型过度依赖语言先验的问题。这种轻量级结构干预显著提升了模型对真实音频证据的利用效率。
中国电信人工智能研究院和西北工业大学的联合队则着重于高质量推理数据构建,提出“从问题到推理”的数据生成策略,避免常见的“先写答案再编解释”的伪推理路径,并通过双重验证机制筛除不可信样本,在LoRA微调下优化模型内生思维结构。
总体而言,单模型赛道展示出通过强化学习、注意力调控与数据对齐,使模型内部逐步形成稳定、可泛化的推理模式。尽管当前在推理质量评分上略逊于智能体系统,但其快速迭代能力与结构简洁性预示着未来巨大的发展潜力。
智能体赛道方案分享
来自爱沙尼亚塔林理工大学的团队获得了智能体赛道冠军,以69.83%的推理质量分与76.9%的答案准确率位居榜首,其系统集成40余种专业音频工具,并设计迭代式证据收集机制——当初始置信度不足时,可主动以不同工具重新分析音频。
来自思必驰和上海交通大学的联合队创新性地将音频转换为Mel频谱图、CQT频谱图等视觉表示,借助视觉语言模型分析频谱结构,提升对数值类与时间结构类问题的推理精度。同时,通过多智能体投票机制与一致性路由策略,系统能够在不同子模型之间交叉验证结论,降低单一路径错误的风险。
来自香港科技大学(广州)与腾讯AI Lab的联合队构建了多智能体辩论框架,各子智能体分别生成推理路径并互相批评,在多轮讨论后由中央控制器汇总达成共识。这种“讨论—质疑—修正”的机制显著减少了幻觉推理,使推理链更加完整、逻辑更加严谨。
整体来看,智能体系统的优势在于其结构透明、证据清晰、决策过程可追溯。随着技术的发展,多模态智能体细致流程编排、复杂工具调用也正在快速赋能音频领域。
⏩开源共享与论文征稿
无论您是否参赛,均可撰写音频推理模型或智能体相关的论文,并投稿至Interspeech 2026 Audio Reasoning Challenge Special Session (Main Conference Track),组委会同样欢迎基于本次竞赛基准MMAR或MMAR-Rubrics取得的研究成果投稿。所有提交的论文将遵循与大会常规论文完全相同的评审流程,被录用后将被索引并收录于 ISCA 文献库中。此外,组委会会在被录用的文章中选出Best Innovative Award,奖励Nvidia RTX 5070显卡。挑战赛全部评测数据、评估脚本及细节报告已开源:
比赛细节报告:https://arxiv.org/abs/2602.14224
评测数据及评估脚本:https://github.com/ddlBoJack/MMAR
本次挑战赛标志着音频智能评估从“结果测评”向“过程测评”的新范式,欢迎语音与多模态研究者持续关注音频推理智能的发展!
