语音小管家
模型权重、微调代码及 SGLang 推理栈已在 GitHub 和 Hugging Face 开源;S2 Pro 版本已在官方平台上线。
开源协议:Fish Audio Research License
Fish Audio 正式开源 S2 文本转语音模型,基于 4.4B 参数的双自回归(Dual-AR)架构与 1000 万小时音频数据。该模型实现了生产级的低延迟流式推理,并支持通过自然语言标签进行词级情感控制,以及多角色、跨段落的长音频生成。
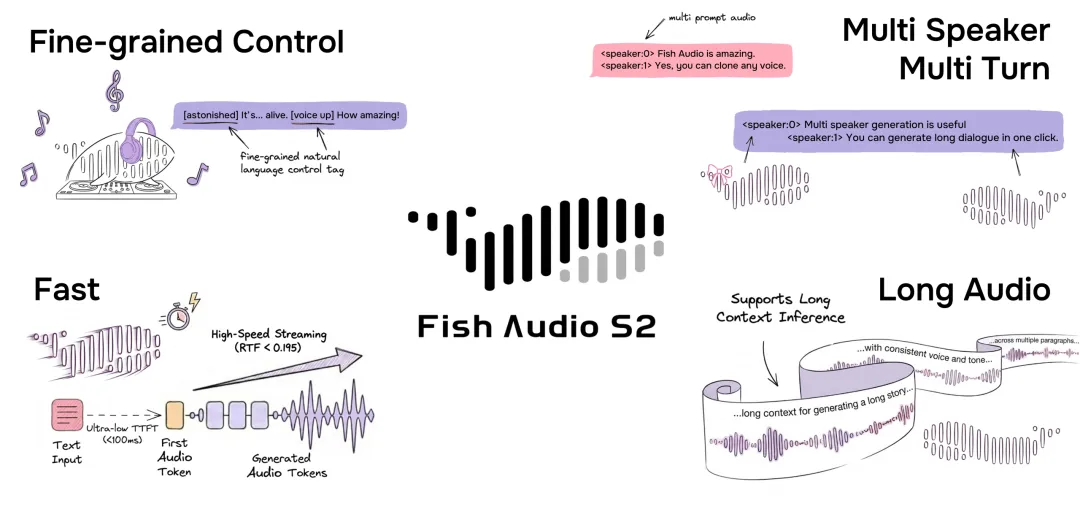
自然语言精细化行内控制:支持在文本中嵌入自由格式的指令标签(如
[astonished]、[voice up]),实现词级的音调、情感和语速控制。在 EmergentTTS-Eval 中,副语言控制胜率达 91.61%,优于 GPT-4o-mini-tts。多角色多轮对话支持:通过
高效率流式推理性能:实测首包延迟(TTFT)小于 100ms,实时因子(RTF)低于 0.195。在单张 NVIDIA H200 上,系统可在维持 RTF < 0.5 的前提下,实现每秒 3000+ 声学 token 的吞吐量。
长文本上下文推理稳定性:支持长上下文推理(Long Context Inference),确保在生成跨段落的长文本故事或演讲时,音色与语气保持一致,避免传统 TTS 模型在长序列下的质量衰减。
Dual-AR 非对称架构优化:采用 4B 参数的 Slow AR 处理语义 codebook,400M 参数的 Fast AR 处理残差声学细节。该设计与标准 LLM 同构,可无缝利用 SGLang 的连续批处理、RadixAttention(前缀缓存命中率达 86.4%)等优化手段。