构建稳健的对话语音大语言模型(Speech LLM)在很大程度上依赖于真实的多语种对话语音数据,然而当前此类数据的稀缺对该领域的发展构成了重大挑战。Interspeech2025多语种对话语音语言模型(MLC-SLM)挑战赛旨在通过发布真实世界的多语种对话语音数据集,推动构建高效的多语种对话语音大语言模型的探索。该挑战赛成功举办,并在Interspeech2025期间举办了研讨会,吸引了广泛关注。
近期,西北工业大学音频语音与语言处理研究组(ASLP@NPU)联合南京大学、南洋理工大学、华为和Nexdata等多家单位,对该赛事进行了系统的总结,相关论文“Summary on The Multilingual Conversational Speech Language Model Challenge: Datasets, Tasks, Baselines, and Methods”被语音研究领域顶级会议ICASSP 2026接收。论文详细介绍了为MLC-SLM挑战赛发布的数据集、每个任务的设置和基线系统,并总结参赛队伍所采用的方法,为学术界和工业界提供关于开发高效多语种对话语音大语言模型的见解。现对该论文进行简要的解读。
论文题目:Summary on The Multilingual Conversational Speech Language Model Challenge: Datasets, Tasks, Baselines, and Methods
作者列表:穆秉甡,郭鹏程,孙照凯,王帅,刘和鑫,邵明辰,谢磊,Eng SiongChng,肖龙帅,丰强泽,王大亮合作单位:南京大学,南洋理工大学,华为,Nexdata
论文预印版:https://arxiv.org/pdf/2509.13785
大型语言模型(LLMs)在多种自然语言处理任务中展现出了卓越的能力,包括文本理解、生成和推理等。这些进展推动了人们将LLMs的应用范围从文本扩展到其他领域,尤其是语音领域,因为语音提供了一种更自然、更直接的交流方式。语音LLMs(SLLM)指的是整合了语音模态的LLM。近年来,SLLM在诸多任务中取得了显著进展,包括语音识别、语音合成、语音增强以及口语对话系统等。
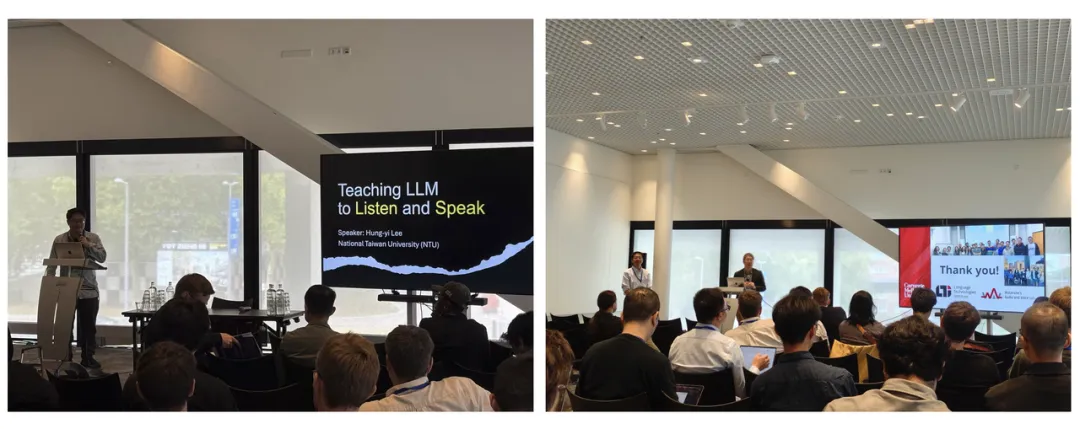
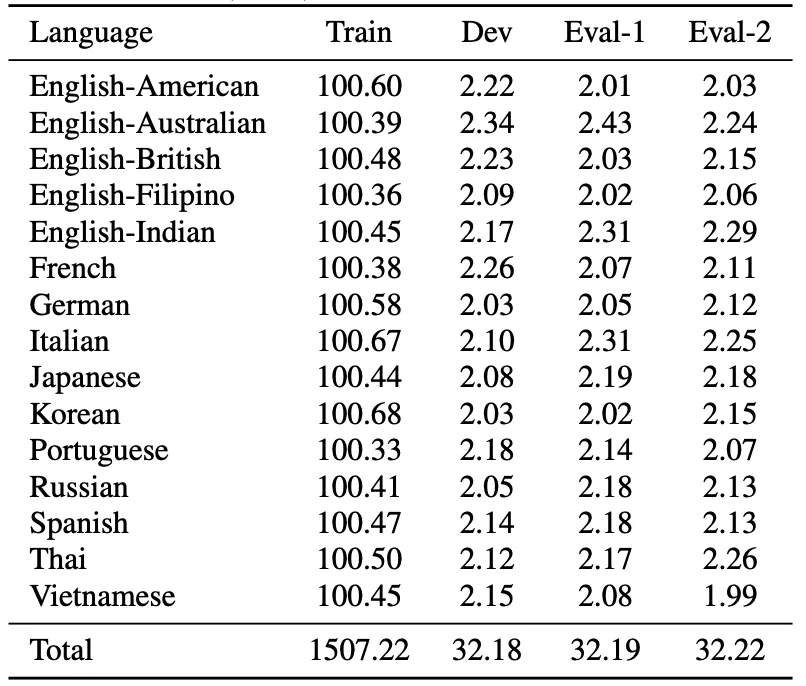
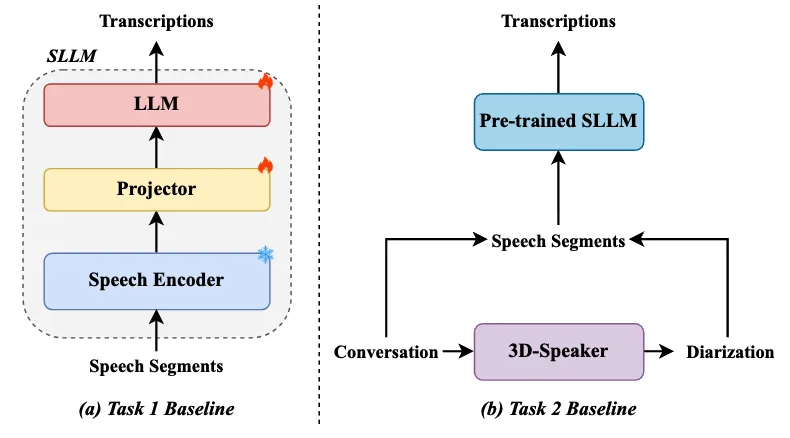
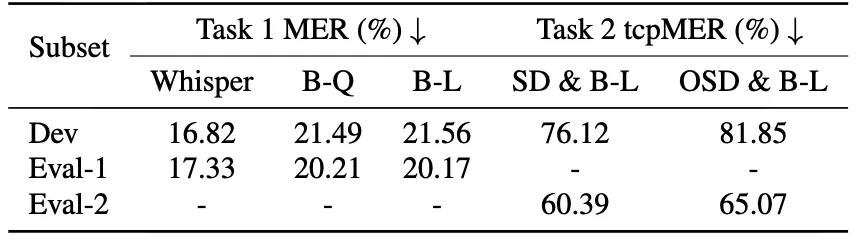
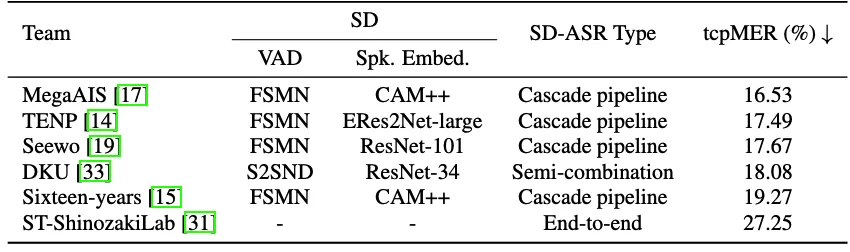
然而,开发强大的基于LLM的口语对话系统在很大程度上依赖于真实世界的对话语音数据,这些数据体现了人类交流的复杂性,包括自然停顿、打断、说话人重叠以及多样的对话风格。这类数据的稀缺性,尤其是在多语种环境中,对该领域的发展构成了重大挑战。Interspeech 2025多语种对话语音大语言模型(MLC-SLM)挑战赛旨在通过发布一个真实世界的多语种对话语音数据集,推动构建有效的多语种对话SLLM的探索。该挑战赛包含两个任务:任务1专注于多语种对话语音识别,任务2则涉及多语种对话语音日志与识别。MLC-SLM挑战赛吸引了来自13个国家的78支队伍参与,两个任务共产生489份有效的排行榜结果提交和14份技术报告。该挑战赛成功举办,并在Interspeech2025期间举办了研讨会,包括赛事总结、获奖团队方案分享、主旨和特邀报告等,吸引了众多来自学术界和工业界的同行参加。图1 Shinji Watanabe 和 李宏毅老师在首届MLC-SLM竞赛研讨会上做主旨报告本文旨在介绍为MLC-SLM挑战赛发布的数据集、每个任务的设置和基线系统,并总结参赛队伍所采用的方法,为学术界和工业界提供关于开发有效的多语种对话SLLM的见解。本任务聚焦于在多语种对话场景下优化自动语音识别(ASR)的准确性。该任务的目标是构建一个基于LLMs的ASR模型。本任务将为参与者提供每个录音的真实分段和说话人标签。我们使用词错误率(WER)和字符错误率(CER)来评估最终结果。具体而言,对于没有明确词边界的语言,包括日语、韩语和泰语,我们使用CER进行评估;而对于其他语言,我们则使用WER。最后,我们通过混合错误率(MER)整合所有语言的平均识别错误率。本任务的目标是构建一个同时用于语音日志(SD)和语音识别的系统。在评估过程中,本任务不会提供任何先验信息或真实信息(例如,不提供分段或说话人标签)。我们鼓励使用基于管线的系统或端到端系统,在设计和实现上提供灵活性。我们使用时间约束的最小置换词错误率(tcpWER)和时间约束的最小置换字符错误率(tcpCER)来评估最终结果。与任务1类似,我们使用tcpCER评估日语、韩语和泰语,而使用tcpWER评估其他语言。本任务中所有提交记过的最终排名通过时间约束的最小置换混合错误率(tcpMER)决定。所有评估指标均使用meeteval工具包计算。两项任务都要求参与者基于SLLM开发系统。参与者可以使用公开可用的外部数据集和预训练模型,包括语音基础模型和LLMs。允许对发布的训练子集进行数据增强,增强方式包括但不限于添加噪声或混响、速度扰动和音调修改。严禁将评估子集用于不合规目的,包括但不限于将评估子集用于模型微调或训练。参与者在任务1和任务2中均不得采用系统融合。提交的结果必须来自单一系统,而非通过结果融合获得。表1展示了赛事发布的MLC-SLM数据集的统计信息。该数据集总共包含约1604小时的多语种对话数据,其中训练集(Train)1507小时,开发集(Dev)32小时,任务1评估集(Eval-1)32小时,任务2评估集(Eval-2)32小时。任务1和任务2共享相同的训练集和开发集。训练集和开发集提供了用于构建语音日志和识别系统的真实分段、说话人标签和转录文本。Eval-1评估集提供真实分段和说话人标签,而Eval-2评估集则不提供。每个子集包含11种语言:英语、法语、德语、意大利语、葡萄牙语、西班牙语、日语、韩语、俄语、泰语和越南语。英语子集包含来自不同地区的口音:美国口音、澳大利亚口音、英国口音、菲律宾口音和印度口音。每个录音包含两位说话人围绕随机分配的话题进行的约20分钟的多轮对话语音,话题包括名人、梦想、教育、情感、时尚、食物、游戏、互联网、电影、购物、旅行等。对话的说话人年龄和性别各异。对话自然流畅,说话人围绕每个话题进行有意义的交流。所有录音均在安静的室内环境中使用iPhone等手机采集,采样率为16kHz。该数据集为构建多语种对话SLLM提供了丰富的资源,可应对语言多样性、说话人变异性和语境理解等挑战。此外,训练集(Train)和开发集(Dev)的语音数据及相应的真实分段、说话人标签和转录文本已向参与者发布,同时发布的还有详细的元数据,包括对话主题、说话人信息、录制条件和语音数据编码信息。Eval-1子集的语音数据、真实分段和说话人标签,以及Eval-2子集的语音数据也已向参与者发布。挑战赛结束后,我们发布了Eval-1和Eval-2两个子集的真实分段、说话人标签和转录文本,以促进MLC-SLM数据集的更广泛应用和进一步研究。赛事发布了两个任务基线系统的数据处理、模型训练和模型推理代码,以方便参与者快速上手和开展可复现的研究。图2展示了两个任务基线系统的架构。任务1的基线系统采用标准的SLLM范式,该范式由语音编码器、投影层和LLM解码器组成。具体而言,语音编码器使用原生的Whisper-large-v3编码器,投影层由两个带GELU激活函数的卷积层、两个带ReLU激活函数的线性层以及LayerNorm组成,LLM则使用Qwen2.5-7B和Llama3.1-8B。我们通过两阶段训练策略使SLLM能够完成ASR任务。在第一阶段,我们只训练投影层。在第二阶段,我们加载第一阶段的投影层参数,并使用低秩适应(LoRA)联合训练投影层和LLM。任务2的基线系统采用级联管线。具体来说,我们使用3D-Speaker工具包进行SD任务,并使用任务1的预训练SLLM模型进行ASR。我们通过三阶段策略获得任务2的结果。在第一阶段,我们对pyannote-segmentation模块进行微调,以用于重叠检测。在第二阶段,我们加载第一阶段的分割模块,对Dev和Eval-2中的原始对话进行推理,得到SD结果。在第三阶段,我们根据SD结果对原始对话进行分割,并将分割后的语音片段输入到任务1的预训练SLLM模型中,以生成转录文本。表2展示了基准系统在Dev和Eval数据集上的结果。对于任务1,原生的Whisper-large-v3表现优于采用Qwen2.5-7B或Llama3.1-8B的SLLMs。我们将此归因于两个因素:首先,基线的SLLM没有利用语言识别功能,而原生的Whisper-large-v3在推理时会使用该功能;其次,基线的SLLM在推理过程中存在严重的幻觉问题。此外,Qwen2.5-7B和Llama3.1-8B之间的性能差异极小。对于任务2,没有重叠检测的SD模块表现更好,因为数据集中的说话人重叠时间过短,不具有显著意义。此外,由于基线的SD分段方法产生了大量短语音片段,任务1中预训练的SLLM表现出较高的tcpMER。表2 基线系统在Dev和Eval数据集上的结果。Whisper指的是原始的Whisper-large-v3,B-Q指的是基于Qwen2.5-7B的SLLM,B-L指的是基于Llama3.1-8B的SLLM,SD指的是带重叠检测的说话人日志,而OSD指的是不带重叠检测的说话人日志任务1共有24支团队提交了其在任务1的Eval-1数据集上的结果,排名前9且提交了技术报告的团队所使用的MER结果和主要技术列于表3。我们总结了多语种对话SLLM如何实现卓越的ASR性能的见解,涵盖了SLLM架构、训练策略、多语种适配、数据增强以及对话上下文利用等方面。表3 在任务1的Eval-1数据集上提交了有效技术报告的排名靠前的团队及其主要技术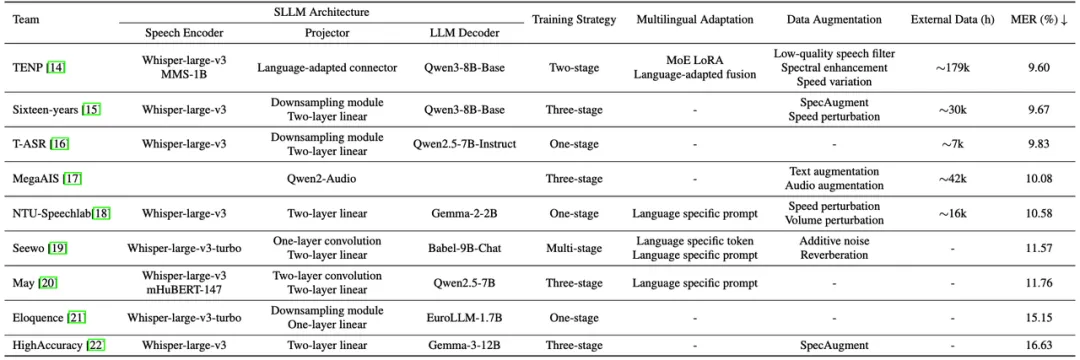 大多数团队构建其SLLM时会使用语音编码器、投影器和LLM解码器,其架构与图1所示类似。Whisper系列因其强大且广泛的多语种ASR能力,成为最常用的语音编码器来源,其中Whisper-large-v3是使用最频繁的编码器。一些团队也会使用Whisper-large-v3-turbo作为语音编码器,但其性能略逊于Whisper-large-v3编码器。此外,有两个团队采用双编码器架构,分别使用经弱监督学习和自监督学习训练的编码器,以提供更全面的语音特征。投影层的作用是对语音特征进行下采样,并将其与LLM的文本嵌入空间对齐。下采样通常通过拼接相邻的语音特征或使用卷积层来实现,而线性层则用于将下采样后的语音特征映射到LLM的文本嵌入空间中。作为投影层中另一种下采样方法,Q-former会将语音特征转换为指定长度的可学习查询,但其实验效果并不理想。一种专门设计的语言自适应投影层会在语言识别的条件下对双编码器的输出进行加权融合,融合后的嵌入在生成CTC提示时被输入到LLM中。LLM解码器的来源多种多样,包括Llama-3.2、Gemma-2}、Gemma-3、Qwen-2.5、Qwen-3、Babel、EuroLLM系列等。我们发现,在SLLM中,不同的LLM解码器之间没有显著的性能差距。此外,对现有的SLLM进行微调也是一种可行的解决方案,例如Qwen2-Audio和Phi-4-multimodal-instruct。用于ASR任务的SLLMs的训练策略多种多样,包括单阶段、两阶段、三阶段和多阶段训练。单阶段训练是同时训练投影层和LLM,还可选择应用LoRA进行参数高效微调。两阶段训练包括从单语到多语的策略、先训练语音编码器和投影层再联合训练投影层与LLM的策略,以及与基线相同的训练策略。三阶段训练的每个阶段都涉及优化语音编码器、投影层和LLM解码器中的一个或多个组件。例如,分别训练这三个组件,或者联合训练语音编码器与投影层、投影层与LLM,又或者将三个组件一起训练。其最终目标是优化所有三个组件,使其更好地适应ASR任务。对于微调现有SLLMs的三阶段训练,每个训练阶段会使用不同类型的数据来提升其ASR性能。多阶段训练通过思维链推理和各种强化学习策略进一步挖掘SLLMs的潜力。在推理阶段,模型平均仍是提升SLLMs在ASR任务上性能的关键方法。此外,一些推理参数对ASR任务中的SLLMs推理至关重要。例如,不同的SLLMs在对不同语言进行推理时,最佳波束大小可能不同,而且生成过程中是否对下一个token进行采样也会影响ASR性能。多语种适配使SLLM能够生成更匹配输入语音的语言输出,减轻了输出中的语言混淆问题。特定语言提示是实现多语种适配最直接的方法,具体是将“Please transcribe the speech”这一提示翻译成与输入语音相同的语言。将特定语言的可训练特殊token与特定语言提示相结合,能进一步增强多语种适配效果。此外,为每种语言单独训练一组投影层和LLM LoRA参数,是实现多语种适配的另一种方法。更进一步,在双编码器中应用MoE LoRA,并基于语言识别对语音特征进行加权融合,这使得融合后的语音特征及其生成的CTC提示都能作为另一种形式的特定语言提示,从而实现多语种适配,这种方法在一定程度上融合了前面讨论的所有方法。由于已发布的MLC-SLM数据集规模相对较小,许多团队采用了各种数据增强技术。鉴于公开可用的外部数据集是被允许使用的,这成为了数据增强的关键方法之一。然而,由于一些外部多语种数据集质量较低,因此有必要对其进行筛选和剔除。此外,由于不同语言的公开语音数据规模差异很大,参与者采用了数据平衡策略,以提升低资源语言的性能。常见的数据增强技术,如SpecAug、SpecSubstitute、速度扰动、加性噪声和混响模拟等,得到了广泛应用。更复杂的文本与语音结合的增强技术能够进一步提升SLLM的性能。对话语音中高度的上下文相关性,为利用上下文的对话SLLM提供了极佳的潜力。将固定数量的相邻历史或未来话语假设作为对话上下文纳入其中,可使SLLM的性能超过使用大量额外数据训练的SLLM。此外,使用历史或未来话语的真实转录文本,能够进一步挖掘对话上下文利用的潜力。另一种方法通过对比学习来增强SLLM捕捉当前话语内容与其对话上下文之间语义连贯性的能力,这种学习方式会使当前话语与其相关上下文对齐。任务2共有10支团队提交了他们在任务2的Eval-2数据集上的结果,排名前6且提交了技术报告的团队的tcpMER结果和所使用的主要技术列于表4中。我们总结了关于多语种对话SLLM如何结合SD和ASR以实现卓越性能的见解。表4 在任务2的Eval-2数据集上提交了有效技术报告的排名靠前的团队及其主要技术级联系统是用于SD和ASR最常见且应用最广泛的方法,它包含三个关键组件:(1)语音活动检测(VAD)模块,用于精确预测语音片段的时间戳;(2)说话人嵌入模型,用于区分说话人的表征;(3)说话人聚类模块,用于对说话人进行分组。大多数团队使用与基线系统相同的基于FSMN的VAD模块,而有一个团队则采用创新的S2SND模型作为其VAD模块。说话人嵌入模块有多种选择,包括CAM++、ERes2Net-large和ResNet模型。对SD结果进行后处理能显著提升ASR性能,包括设置最大语音片段时长以及拼接同一说话人的相邻片段。得到SD结果后,级联系统方法会切分原始对话语音,然后应用任务1中预训练的SLLMs对语音片段进行推理以生成转录文本。值得注意的是,任务1中表现最佳的SLLM在对通过SD结果得到的语音片段进行转录推理时,未必能达到最佳性能,这是因为该表现最佳的SLLM对于SD结果中不同的片段长度,泛化能力有限。为了降低级联系统的复杂性,有必要将SD和ASR进行更深层次的集成。一种半集成方法将原始对话语音以及相应的说话人注册的三元组集(包括说话人嵌入和起止时间戳)作为输入,传入一个具有说话人日志感知能力的SLLM,该模型随后会为每个三元组所代表的语音片段生成转录文本。另一种半集成方法首先采用创新的DiariZen作为SD模型,为原始对话语音中的每个说话人生成帧级别的静音-目标-非目标-重叠(STNO)掩码,然后将这些掩码输入到增强版的Whisper模型DiCoW中,以生成原始对话的转录文本。端到端方法是采用单个SLLM来联合执行SD和ASR,该模型直接从原始对话语音中预测说话人标签、片段边界(开始和结束时间戳)以及相应的转录文本。只有一个团队探索了这种端到端方法,该方法将局部滑动非重叠推理窗口与来自先前说话人轮次的基于提示的上下文相结合,以预测谁在说话以及说的是什么。端到端SLLM采用局部SD与ASR格式进行训练,以学习结构化的说话人-文本对齐。在推理过程中,它利用更新后的说话人上下文和预测的说话人提示来处理局部窗口内的原始对话语音,迭代地确保连贯性。由于LLM难以有效处理语音中的说话人信息和时间戳,因此半集成方法和端到端方法的表现不如级联系统。第二届MLC-SLM挑战赛近期启动,更多数据,新的挑战,敬请期待!

 语音小管家