
 语音小管家
随着大语言模型(LLMs)特别是音频大模型(Audio-LLMs)和全能模型(Omni-models)的快速发展,口语对话系统取得了显著进步,不断缩小人机交互与人人交互之间的差距。为了实现真正“类人”的交流,系统需要具备双重能力:一是感知并与用户情绪状态共鸣的情绪智能;二是驾驭动态、自然对话流(如实时话语交替)的鲁棒交互机制。
近期,西北工业大学音频语音与语言处理研究组(ASLP@NPU)联合南京大学、华为、希尔贝壳、Soul AI Lab及南洋理工大学等多家机构,在语音领域顶级会议 ICASSP 2026 上发起了首届类人口语对话系统挑战赛(HumDial)。该挑战赛基于真实人类对话构建的大规模数据集,旨在为大模型时代的对话系统提供公平的评估基准。现对该挑战赛总结论文进行简要的解读和分享。
论文题目:The ICASSP 2026 Humdial Challenge: Benchmarking Human-Like Spoken Dialogue Systems in The Llm Era
现有的商用模型(如 GPT-4o Realtime [1])和开源社区的迅速跟进(如 Qwen2.5-Omni [2]、GLM-4-Voice [3] 等)已经证明,当前语音对话系统能够实现令人印象深刻的低延迟和自然交互质量。然而,一个基本问题仍然存在:最先进的人机对话系统距离实现人类水平的对话自然度还有多远?
虽然目前的模型在完成任务方面表现优异,但要评估它们“复刻”人类交流微妙之处(特别是深度的情感共鸣和复杂的交互逻辑)的能力,需要一个标准化的评估平台。现有的评估数据集往往依赖“伪多轮”的拼接单轮对话或“合成混合”的音频重叠(如 Full-Duplex-Bench [4],Multi-Bench [5])。这种机械的方法破坏了情绪的自然流动,也无法捕捉真实的认知同步(如犹豫或合作式的打断)。为了解决这些限制,HumDial 挑战赛利用真实世界录制的对话,为多轮情绪演变、推理以及全双工交互建立了一个统一的标准。
赛事官方网址:https://aslp-lab.github.io/HumDial-Challenge/
为了突破传统数据的局限性,HumDial 采用了一种结合大模型脚本生成与真人演绎的“人机协同”混合数据构建管线。
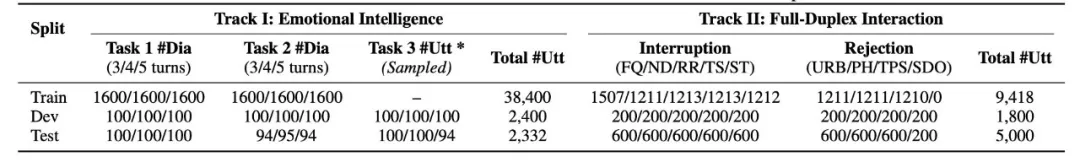
赛道一(情感智能)数据:我们利用 Gemini 2.5-pro 生成了跨越 3 至 5 轮的连贯用户思维流脚本。数据涵盖了 6 种均衡的情绪类别,全部由真人进行录制。任务一的对话侧重于初始情绪被干扰事件打断的动态轨迹;任务二聚焦于由潜在触发因素驱动情绪状态转换的隐式因果链;任务三则直接从这些多轮对话中提取关键的情绪片段。在规模上,训练集为任务一和任务二各提供了 1600 段不同轮次的多轮对话(总计4800段),任务三则包含 38,400 句单点语音。
赛道二(全双工交互)数据:我们使用 DeepSeek 生成了嵌入特定交互提示(如插话或旁白)的自然对话脚本。与传统的通过语音合成文本不同,我们专门邀请真人演绎进行录音,确保了所有的“打断”都发生在具有认知意义的语义节点(例如用户犹豫时),从而完美保留了真实的重叠时机和韵律特征。该赛道的训练集共包含 9,418 句用于严格评估的语音数据。
两个赛道的具体数据分布与统计详情如表1所示。
表1 两个赛道的数据集统计情况
赛道设置与提交方案汇总:
ICASSP2026类人语音对话系统(HumDial)挑战赛结果公布
赛道一:情绪智能 (Emotional Intelligence)
该赛道主要评估系统对情绪动态的感知、推理和生成能力,包含以下三个任务:
情绪轨迹检测:评估准确识别和总结多轮对话中情绪变化的能力。
情绪推理:评估感知用户情绪潜在原因的能力。
共情评估:测试生成文本和音频格式共情回复的能力。
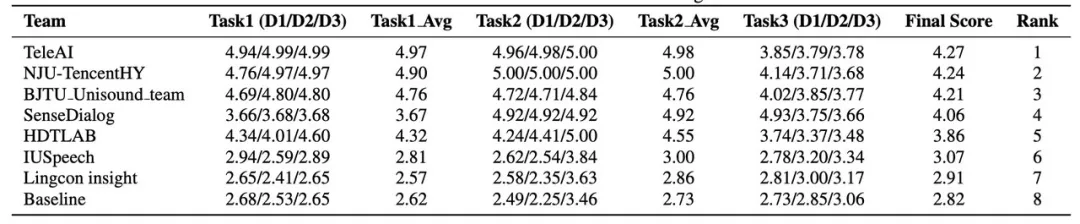
评估方法采用了自动化与人工评估相结合的混合框架(Qwen3-Omni-30B 模型结合 20 名专业人类评估员)。本赛道的最终评估结果如表2所示。
表2 情感智能赛道结果
赛道二:全双工交互 (Full-Duplex Interaction)
该赛道评估系统在人机语音对话过程中实时决策能力。评估包含两个核心场景:
打断 (Interruption):评估对用户干预的响应,如跟进问题、否定/不满、重复请求、话题切换和沉默/终止。
拒绝 (Rejection):测试针对非指令性语音的鲁棒性,如用户实时反馈、停顿处理、第三方语音和对他人说话。
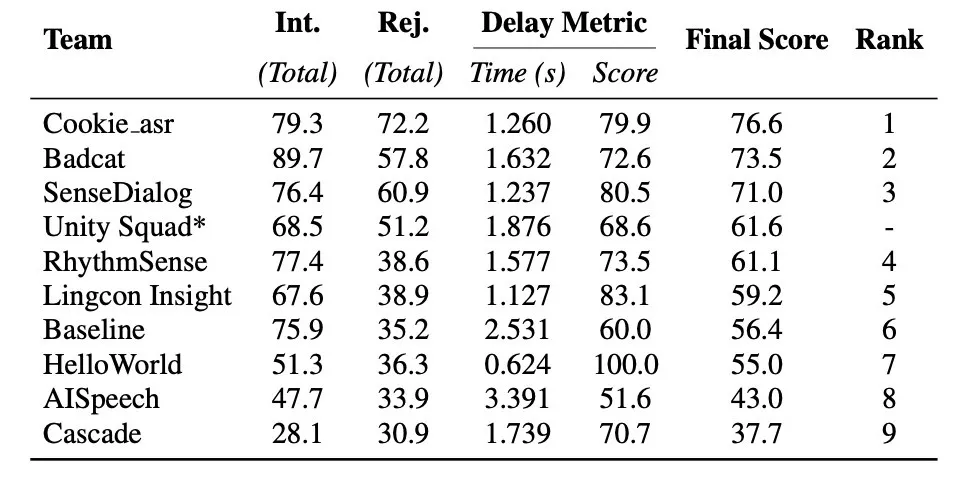
重点考察响应率、延迟以及拒绝率等核心指标。总分计算公式为:
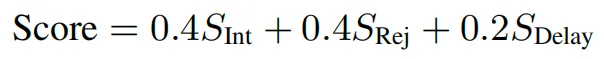
本赛道的最终评估结果如表3所示:
表3 情感智能赛道结果,*表示超时提交
本次 HumDial 挑战赛吸引了 100 多支来自全球学术界和工业界的注册团队,共产生 15 份有效提交。
情绪智能赛道结果:顶尖团队在情绪跟踪和推理方面取得了接近天花板的表现,但在生成共情回复(任务三)时普遍遇到困难。这突显出尽管大模型擅长分析情绪逻辑,但生成富有共情力的语音和文本回复仍然是一个严峻挑战。
全双工交互赛道结果:顶尖系统在实时交互中展现了不同的优势。Badcat 团队实现了最高的打断成功率,而 Cookie asr 团队通过在低延迟和稳健的噪声拒绝之间取得最佳平衡荣获第一名。值得注意的是,区分有效用户轮次与背景干扰(即拒绝能力)仍是全双工系统的主要障碍。
未来,我们将进一步优化HumDial数据集和评估方案,对领先的商业和开源模型进行基准测试,并在后续出版物中提供全面的对比分析。
更多详细的评估指标说明、具体打分设置以及完整的挑战赛结果,请访问挑战赛官方主页获取:🔗https://aslp-lab.github.io/HumDial-Challenge/
[1] Aaron Hurst, et al., "Gpt-4o system card," arXiv preprint arXiv:2410.21276, 2024.
[2] Jin Xu, et al., "Qwen2.5-omni technical report," arXiv preprint arXiv:2503.20215, 2025.
[3] Aohan Zeng, et al., "Glm-4-voice: Towards intelligent and human-like end-to-end spoken chatbot," arXiv preprint arXiv:2412.02612, 2024.
[4] Guan-Ting Lin, et al., "Full-duplex-bench: A benchmark to evaluate full-duplex spoken dialogue models on turn-taking capabilities," arXiv preprint arXiv:2503.04721, 2025.
[5] Yayue Deng, Guoqiang Hu, Haiyang Sun, Xiangyu Zhang, Haoyang Zhang, Fei Tian, Xuerui Yang, Gang Yu, and Eng Siong Chng, “Multi-bench: A multi-turn interactive benchmark for assessing emotional intelligence ability of spoken dialogue models,” arXiv preprint arXiv:2511.00850, 2025.
