
 语音小管家
近日,HKUST Audio 团队推出新一代联合音视频生成模型 Talker-T2AV。该模型面向talking head 场景,将传统 TTS 从单一语音生成进一步拓展到 文本到音频+视频联合生成,能够同时生成自然语音与同步的人脸运动,为数字人、AI 口播、虚拟主播、视频配音等应用提供了新的技术路径。
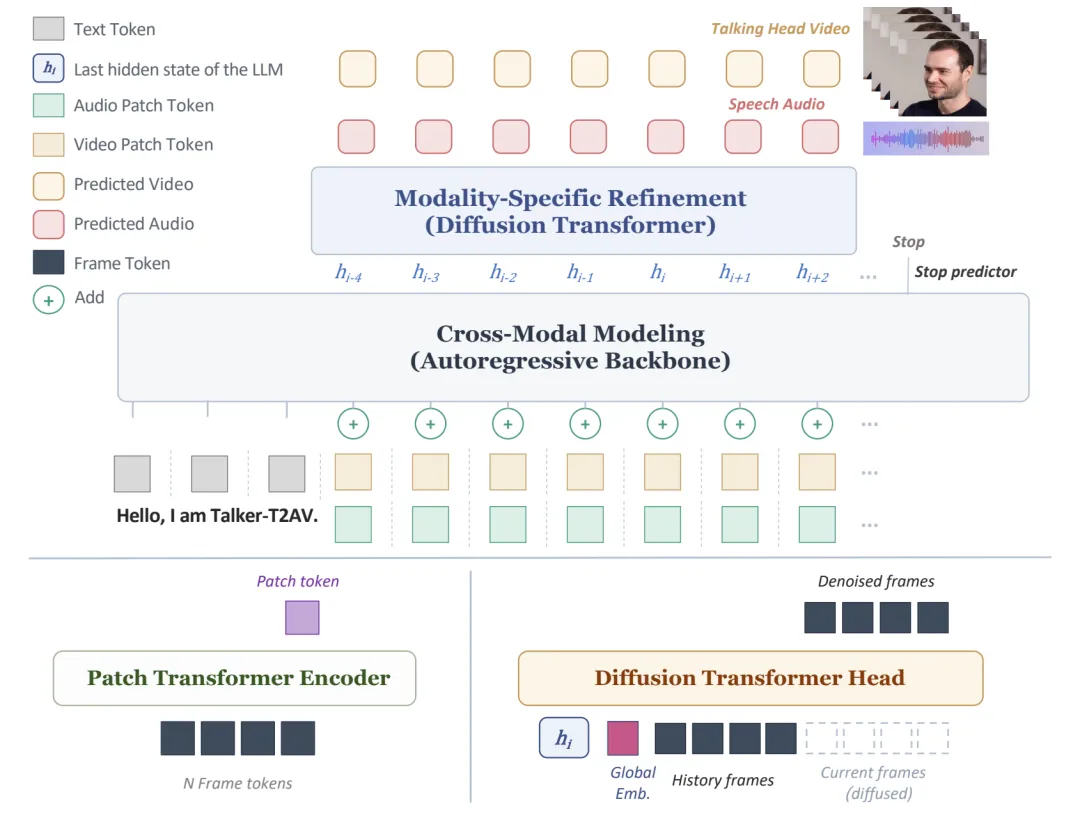
不同于常见的“先生成语音,再驱动视频”的级联式方案,Talker-T2AV 采用自回归扩散建模框架,在统一的 patch-level token 空间中联合建模音频与视频,并通过模态专属的扩散头分别生成语音 latent 和视频 motion latent,从而提升跨模态一致性和生成效率。
目前,Talker-T2AV 已开放论文、模型权重和代码,开发者可以直接体验和复现相关能力。
论文题目:Talker-T2AV: Joint Talking Audio-Video Generation with Autoregressive Diffusion Modeling
⏩克隆样例抢先看:声音、口型和头动一起学
官方Samples 页面首先展示的是Zero-Shot Audio-Video Cloning:给定一小段参考音视频,模型不需要针对特定说话人微调,就可以同时克隆说话人的声音特征和面部动态风格,并用新的文本生成新的talking head 视频。
这一组样例建议放在文章最前面展示,读者可以直观看到Talker-T2AV 与普通 TTS 最大的不同:它克隆的不只是音色,而是“说话方式 + 面部运动 + 音画同步”。
⏩从文本直接生成talking head 视频
除了零样本音视频克隆,官方页面还提供了一组Joint Text-to-Audio-Video Generation 样例:输入文本、说话人 embedding 和身份图像,模型直接生成时间对齐的语音和 talking-head 视频。
⏩从TTS 到 T2AV:让 AI 真正“开口说话”
过去我们讨论TTS,通常关注的是音质、自然度、音色相似度和韵律表现。也就是说,模型要解决的是“这句话听起来像不像真人说的”。
但在数字人和视频生成场景中,只生成声音已经不够了。用户需要的是一段完整的“说话表现”:声音要自然,嘴型要对齐,表情和头动要协调,音频和视频还不能错位。
Talker-T2AV 正是面向这一问题提出的。它将任务从 Text-to-Speech 扩展为Text-to-Audio-Video:输入文本,直接生成带语音、口型和面部运动的talking head 视频。
⏩高层联合建模,低层模态解耦
Talker-T2AV 的核心思想可以概括为:高层一起建模,底层分别生成。
在talking head 生成中,语音和面部动作在语义层面高度相关。例如,说话内容、节奏、停顿和口型变化之间存在紧密对应关系。但在低层细节上,声学信号和视觉运动又是两类完全不同的生成对象。
如果让音频和视频在所有层面都强行绑定,模型容易产生不必要的模态纠缠;如果完全拆开,又会削弱音画同步和跨模态一致性。
因此,Talker-T2AV 采用共享自回归语言模型进行高层跨模态建模,再通过两个轻量级 diffusion transformer heads 分别完成音频和视频的低层细节生成。这样既能保证音视频协同,又能让不同模态各自保留更适合自己的生成方式。
⏩统一token 空间,释放自回归模型能力
Talker-T2AV 使用 Qwen3-0.6B 作为自回归主干,在统一的 patch-level token 空间中对文本、音频和视频进行建模。
具体来说,音频和视频都被编码为25 Hz 的时间对齐 latent 序列。模型在统一序列中同时理解文本语义、音频节奏和视频运动,并将音频 patch embedding 与视频 patch embedding 在对应位置进行融合。
这种设计使模型能够在同一个自回归框架下学习“说什么”“怎么说”“脸怎么动”之间的关系,也让音视频生成不再依赖简单的后处理拼接。
在解码阶段,音频侧使用WhisperX-VAE 生成 32 维音频 latent,视频侧使用 LIA-X 生成 40 维 motion latent,最终合成为带声音的 talking head 视频。
⏩一个模型,覆盖三类音视频生成任务
Talker-T2AV 的另一个亮点是统一性。它不是只面向单一的文本生成视频任务,而是可以在同一模型框架下支持多种音视频生成玩法。
T2AV:文本到音频+视频输入文本,模型同时生成语音和同步的视频运动,适用于数字人口播、虚拟主播、内容生成等场景。
A2V:音频驱动视频给定一段语音,模型可以驱动参考人物生成对应的面部运动和口型表现,适用于配音视频、视频翻译和虚拟形象驱动。
V2A:视频配音 / 视频补声音给定一段无声talking head 视频,模型可以生成与画面匹配的语音内容,为视频 dubbing 和多模态补全提供可能。
这意味着Talker-T2AV 更像是一个统一的说话人音视频生成框架,而不仅仅是一个 TTS 模型或 lip-sync 模型。
⏩两种前缀模式,支持风格控制和续写
Talker-T2AV 还支持通过gt-prefix-seconds控制生成方式。
当gt-prefix-seconds 为 0 时,模型主要利用参考音频中的说话人音色和参考视频中的身份信息,生成新的说话风格和头部运动,适合“只借用声音和人脸”的场景。
当gt-prefix-seconds 大于 0 时,模型会将参考音频和 motion 的前 N 秒作为前缀输入,从而延续参考片段中的韵律、节奏和头动风格。这种方式类似零样本语音克隆,但进一步扩展到了语音与视频的联合风格克隆。
⏩应用场景
Talker-T2AV 代表了一个非常明确的趋势:TTS 正在从单模态语音生成,走向多模态人物表达生成。
过去,TTS 模型主要回答“这句话怎么说”。而在多模态生成场景中,模型还需要回答:谁在说、用什么语气说、嘴型如何变化、表情和头动如何配合、音画如何保持同步。
这对语音技术提出了更高要求,也打开了更大的应用空间。未来的TTS 可能不再只是一个音频模块,而会成为数字人、视频生成、虚拟陪伴、AI Agent 表达系统中的核心组件。
⏩开源体验,欢迎上手
目前,Talker-T2AV 已在 Hugging Face 开放预训练权重,并在 GitHub 提供推理脚本和相关代码。官方仓库包含infer.py推理入口,也提供了参考音频、参考motion 和参考视频等样例数据。
感兴趣的开发者可以根据官方说明下载Talker-T2AV、WhisperX-VAE、LIA-X 相关权重,进行本地推理和二次开发。
从Text-to-Speech 到 Text-to-Audio-Video,Talker-T2AV 给出了一个很有代表性的方向:AI 生成的下一步,不只是让声音更像真人,而是让声音、表情和动作共同组成完整的“说话行为”。
