
 语音小管家
录取信息:Accepted to Interspeech 2026
论文题目:AuDirector: A Self-Reflective Closed-Loop Framework for Immersive Audio Storytelling
单位:上海人工智能实验室、清华大学
论文链接:https://arxiv.org/pdf/2605.11866
代码链接:https://github.com/Riddae/AuDirector
Demo链接:https://riddae.github.io/AuDirector_demopage
AuDirector 像一位音频导演,把故事理解、角色选角、分轨制作、质量审查和自然语言修改串成一个可迭代的创作闭环
面向沉浸式音频故事生成,AuDirector 提出首个支持自然语言反馈编辑的自反思闭环多智能体框架。该系统创新性地打通自动选角、情绪控制、质量审查与定向返工流程,实现从故事到成品的导演式音频创作,为有声书、广播剧、播客及游戏叙事等场景提供高质量智能生成方案。
⏩沉浸式音频故事生成还缺什么?
如果让如今的AI 生成一段广播剧,难点已经不再只是“把文字正确念出来”,真正影响沉浸感的,已经是角色声音是否贴合人设、情绪是否随着剧情起伏、雨声和脚步声是否踩在正确的位置、背景音乐是否烘托出场景,以及生成结果不理想时能不能自动返工。
AuDirector 试图解决的正是这个问题:它不把音频故事生成看成一次性的模型调用,而是把它组织成一套“导演式”的多智能体工作流。系统先理解故事,再完成选角、配音、音效生成和配乐设计,随后由 Critic Agent 做质量审查;当用户想进一步修改时,也可以直接用自然语言提出要求。
⏩音频故事生成难在哪里?
过去的语音合成、音效生成、音乐生成模型已经能在各自任务上取得不错效果,但音频故事是一个更复杂的组合问题:它需要把语音、环境音、动作音效和背景音乐放进同一个时间线里,并在更长篇幅中保持角色、情绪和节奏的一致。
现有基于Agent 工作流的音频叙事系统仍常见几个问题:
角色声音与人物设定不够贴合,容易出现声音气质和角色画像割裂的问题;
同一角色在不同剧情中的情绪表达不稳定,缺少细粒度控制;
生成结果一旦出现低质量片段或音效不匹配,缺少自动发现和定向返工机制;
用户想改某一段对白、某个音效或某处音乐时,往往很难做到局部、精确地修改。
⏩AuDirector 的思路:把生成过程变成导演式闭环
AuDirector 将音频故事创作拆成三个阶段:Identity-Aware Pre-production、Collaborative Synthesis and Correction,以及 Human-Guided Interactive Refinement。直观地说,它像一个小型音频制作团队:Director Agent 负责理解故事和调度流程,Casting Agent 负责选角,Acoustic Production Agent 负责生成语音、音效和音乐,Critic Agent 负责质检,Mix Agent 负责混音,Interaction Agent 负责理解用户反馈。
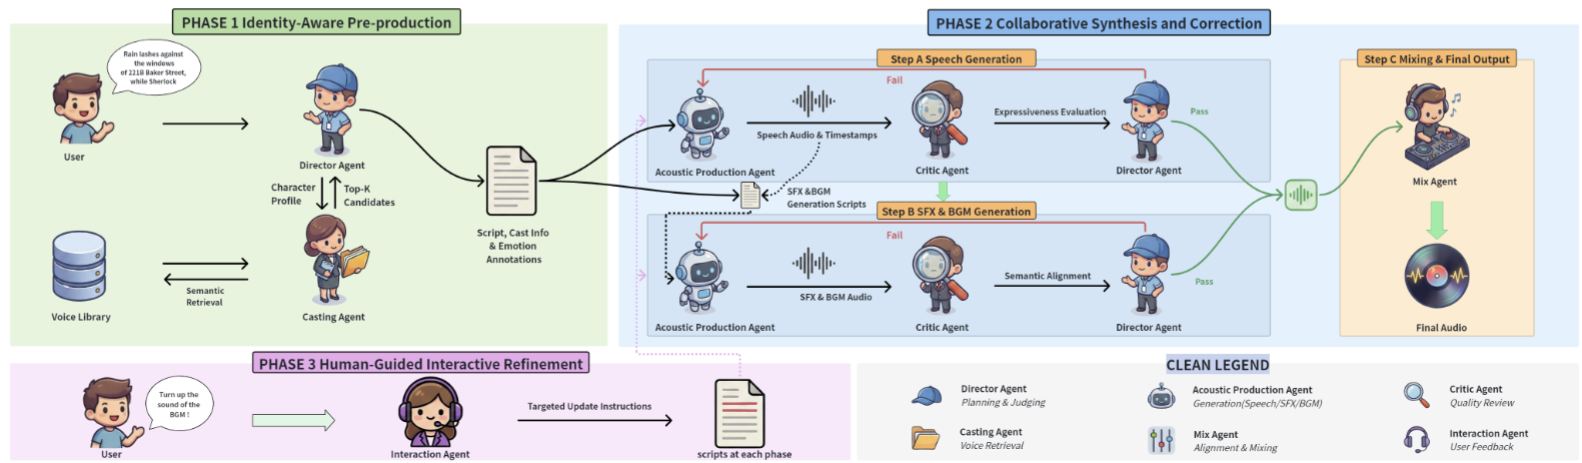
图1:AuDirector 的三阶段闭环工作流:自动选角与情绪规划、生成与质检返工、自然语言交互编辑。
1. 自动选角与情感导演
第一步是Identity-Aware Pre-production。系统会先从用户输入的故事中解析出结构化剧本、角色画像和逐句情绪指令。它要回答的问题包括:谁在说话?这个角色是什么身份和性格?这句台词应该以什么情绪说出来?
为支持更贴合角色的声音选择,AuDirector 构建了一个包含 320 条多样化语音样本的音色库,覆盖不同年龄、性别、口音和说话风格。选角不是简单地随机挑选声音,而是先用文本嵌入做粗筛,再由 Director Agent 结合剧本上下文从候选音色中做最终选择。
情绪控制也不是简单给台词贴上“开心”或“悲伤”的标签。AuDirector 会将情绪拆解为多种基础情绪的组合信号,用来指导每句台词的表达强度和情绪走向,让同一角色在不同上下文中呈现更自然的情感起伏。
2. 生成、评估、返工:让系统先自查
第二步是Collaborative Synthesis and Correction。传统流程往往是“一次生成,直接输出”,而 AuDirector 引入了闭环质检:生成语音、音效和背景音乐后,先由 Critic Agent 评估,如果分数低于阈值,就触发定向重生成。
具体来说,语音片段主要检查音质是否清晰、表达是否符合角色和情绪;音效与背景音乐则重点检查是否和文本描述、故事场景相匹配。对于不达标的部分,系统会调整相关指令并重新尝试,直到得到更合适的版本。
这个机制的价值在于,它把生成式模型的不稳定性放进了可管理的流程里:问题片段会被发现、定位和返工,而不是直接混入最终音频。最后,Mix Agent 再把通过检查的语音、音效和音乐统一合成为完整作品。
3. 用自然语言做精确修改
第三步是Human-Guided Interactive Refinement。用户不需要打开专业音频编辑软件,也不需要重新生成整段作品,只要用自然语言说明想改哪里、怎么改,Interaction Agent 就会修改底层 production script,并触发受影响片段的定向重生成。
例如,用户可以直接说:
“第三段对白更激动一些。”
“把雨声调小一点。”
“结尾音乐换成更悬疑的风格。”
相比整体端到端重做,这种方式更适合真实创作流程:未受影响的音轨可以保持不变,系统只修改目标组件或目标片段,既降低计算成本,也让创作者更容易做细节打磨。
⏩实验结果说明了什么?
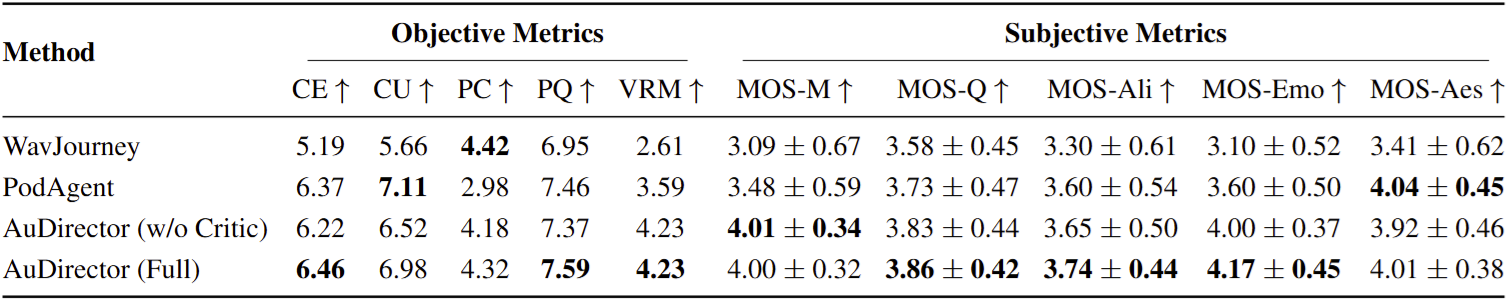
AuDirector 在播客和广播剧两类场景上进行评测 ,并与 WavJourney、PodAgent 等系统进行对比。为了尽量排除底层模型差异,实验让各系统使用相同的 LLM 和音频生成后端,因此表 1 更主要反映的是“多智能体调度、质量审查和返工流程”本身带来的影响。
表1:AuDirector 与基线方法在客观指标和主观评分上的对比
音频美学指标
相比前人基于Agent 工作流进行音频故事生成的工作,包括 WavJourney 和 PodAgent,AuDirector 在 Meta 提出的 Audiobox Aesthetics 分数上取得了显著的进步,其中 CE (Content Enjoyment) 和 PQ (Production Quality) 都明显提升,CU (Content Usefulness) 指标上,生成语音内容为主的 PodAgent 领先,毕竟语音内容对人工创作而言可懂度更好,然而它的 PC (Production Complexity) 差很多,说明 PodAgent 生成结果在声音层次、音效丰富度和场景音乐设计上相对不足。相比之下 WavJourney 的 PC 略微胜过 AuDirector,但缺少了生成后的自我审查和自我修复,以及针对故事内容选择音色,使得其他分数都显著落后。
音色匹配度(Voice-Role Matching)
用于评估人物声音是否符合角色设定和故事语境。该指标由Gemini-3-Pro 进行评分,结果显示 AuDirector 相比 WavJourney 和 PodAgent 具有更明显的优势。
主观评分
主观评分部分则从人的听感出发,评估生成结果是否真的“好听、合适、协调”。评分维度包括音色匹配度(MOS-M)、音质(MOS-Q)、音效和音乐与剧本的匹配度(MOS-Ali)、人物情绪与剧本的匹配度(MOS-Emo),以及各音轨之间的整体和谐程度(MOS-Aes)。结果显示,AuDirector 相比 WavJourney 和 PodAgent 有更明显的综合优势;加入 Critic Agent 后,系统在音质、匹配度和整体协调性上进一步提升,说明自我审查机制对最终听感有直接帮助。
自然语言编辑的表现
交互式编辑实验更接近真实创作场景:AuDirector使用200 条自然语言编辑指令进行测试,覆盖语音精修、音效内容修改、音量控制和结构编辑四类任务。评估指标为 Instruction Execution Accuracy(IEA),也就是系统是否准确理解并执行了用户的修改意图。
表2:自然语言交互编辑的指令执行准确率
由于交互式编辑主要通过修改底层脚本来实现,论文进一步评估了系统能否准确理解并执行用户的编辑指令。结果显示,在语音精修、音效内容修改、音量控制和结构编辑四类任务中,AuDirector 的平均编辑成功率达到 90%,说明它已经能够较稳定地支持自然语言驱动的局部修改。
⏩总结与展望
AuDirector 的价值不只是生成更长的音频,而是把音频故事制作变成一个可规划、可审查、可修改的流程。它让系统能够理解角色、组织音轨、控制情绪,并在结果不理想时进行局部返工。
未来,这类框架可以用于有声书、广播剧、播客、游戏叙事和数字人内容,让AI 音频不只是“能发声”,而是更懂角色、场景和剧情。
当然,系统仍受底层音频生成模型限制,尤其是环境声和细微音效的表现还有提升空间。随着非语音音轨生成能力进一步增强,这类导演式音频工作流也会有更大的应用潜力。
结 语
●AuDirector 展示了一条从“生成音频片段”走向“导演完整音频故事”的路径。
●当 AI 能理解角色、控制情绪、审查质量,并根据自然语言反馈局部返工,音频创作就不再只是模型输出,而更像一个可协作、可迭代的制作过程。
