
 语音小管家
本期分享国防科技大学与湖南师范大学近期发表在IEEE Transactions on Neural Networks and Learning Systems的一篇语音人脸多模态学习的综述文章。
【论文标题】A Survey on Human-centric Voice-Face Multimodal Learning
【论文作者】Wuyang Chen(陈武阳), Kele Xu(许可乐,通信作者), Qiya Song(宋启亚), Yanjie Sun(孙彦洁), Xinwang Liu(刘兴旺), Xingyi Li(李星谊), Yong Dou(窦勇), Huaimin Wang(王怀民)
【论文单位】College of Computer Science and Technology, National University of Defense Technology国防科技大学计算机学院,中国长沙;Hunan Normal University湖南师范大学,中国长沙
【作者邮箱】chenwuyangcn@gmail.com; sqyunb@hnu.edu.cn; kele.xu@ieee.org; sunyanjie21@nudt.edu.cn; xinwangliu@nudt.edu.cn; lix467272@gmail.com; yongdou@nudt.edu.cn; whm_w@163.com
【论文亮点】
提出人本语音-人脸多模态学习的系统化视角:本文聚焦语音-人脸多模态学习,将语音、人脸图像与视频等人本多模态信息纳入统一分析框架,区别于一般音视频学习中自然声音与自然场景的宽泛研究范式。
构建跨任务综述框架:系统梳理语音-人脸关联、跨模态生成、说话人识别、音视频深度伪造检测、视听语音感知、音视频情感计算以及多模态大模型等典型任务,揭示不同任务之间的内在关联和知识迁移关系。
强调生物计量与神经认知基础:从面部感知、声音感知和语音-人脸联合感知机制出发,分析人类如何处理声音与面部信息,为设计更符合人类感知规律的多模态模型提供理论启发。
系统整理数据集与表征学习方法:从数据采集流程、标注粒度、任务适配性、模态依赖关系等角度归纳语音-人脸相关数据集,并总结动态表征、静态表征、跨模态属性学习等表征学习范式。
关注公平性、鲁棒性与真实场景挑战:系统讨论人口统计偏差、低资源语言、多说话人场景、模态缺失、视觉遮挡、域迁移、深度伪造与伦理风险等问题,指出可信人本多模态系统仍需解决公平性和安全性挑战。
总结人本多模态大模型趋势:分析 LLM/MLLM 在语音-人脸任务中的应用进展,指出现有大模型仍存在任务覆盖有限、声脸融合较浅、细粒度人本语义建模不足等问题,未来需要发展面向语音-人脸数据的专用人本多模态基础模型。
【引言】
人工智能的最终目标之一是赋予机器理解人类感知、交流与行为的能力。在人类日常交流中,声音和面部信息承担着不可替代的作用:语音不仅传递语言内容,还包含说话人身份、情绪、语调和社会语境等丰富信息;人脸则通过外貌、表情、口型和头部运动等视觉线索,帮助人类完成身份识别、情绪理解和语音感知。随着深度学习和多模态学习的发展,语音-人脸多模态学习已成为人本智能研究中的重要方向,在虚拟人生成、说话人识别、视听语音识别、深度伪造检测、情感计算和智能人机交互等场景中展现出广泛应用价值。
然而,现有相关研究大多围绕单一任务展开,例如语音驱动人脸生成、音视频说话人识别、视听语音增强或音视频情感识别等,缺乏一个从以人为中心(人本)的语音-人脸视角出发的系统性综述框架。与一般音视频学习不同,语音-人脸多模态学习具有鲜明的人本属性和生物认知基础:面部结构与声道特征之间存在生理关联,声音和面部共同承载身份、情绪和行为意图,二者在神经认知层面也具有独特的联合感知机制。因此,简单将其归入通用音视频学习,容易忽视其在数据属性、任务关联、模型设计、公平性和伦理风险等方面的特殊性。
本文围绕人本语音-人脸多模态学习展开系统综述,从生物计量和神经认知基础、任务演化与关联、表示学习、数据集分类、典型下游任务、多模态大模型以及公平性与鲁棒性挑战等方面进行全面梳理,旨在为该领域建立清晰的研究图谱,并为未来构建更加自然、可信和具有人类感知能力的多模态智能系统提供参考。
【研究背景】
音视频多模态学习长期以来是人工智能领域的重要研究方向,其目标是通过联合建模听觉与视觉信息,提升机器对复杂环境和人类行为的理解能力。已有综述工作通常从通用音视频学习、说话人建模、视觉语音分析或具体下游任务角度展开,涵盖自然声音与图像匹配、声源定位、音视频事件检测、视觉语音识别、说话人识别和深度伪造检测等内容。然而,这些研究往往没有将语音和人脸作为一个具有内在生物关联和认知基础的整体进行系统分析。事实上,语音-人脸数据与一般自然音视频数据存在显著差异:语音不仅是声学信号,也是语言、身份和情绪的载体;人脸不仅是视觉对象,也是身份、表情、口型和社会交互线索的集中体现。二者共同指向人这一核心主体,使语音-人脸多模态学习天然具有跨任务、跨模态和人本认知属性。
从生物计量和神经认知角度看,人类对面部和声音的感知并非彼此孤立。面部骨骼结构、声道形态、鼻腔结构等生理因素会影响声音特征,而语言、口音、语速和情绪表达又进一步强化声音与身份之间的联系。脑科学研究表明,面部感知和声音感知分别涉及视觉皮层、听觉皮层、颞上沟、梭状脸区等多个脑区,而语音-人脸整合则依赖更复杂的跨模态感知机制。这些发现为构建更符合人类感知规律的多模态模型提供了重要启发。
与此同时,语音-人脸相关任务之间也存在紧密联系。例如,语音-人脸关联学习可以服务于跨模态身份验证和说话人识别;视听语音增强、语音分离和语音重建可以作为语音识别的前端模块;情感计算中的表情、语调和语义信息也可为深度伪造检测和虚拟人生成提供辅助线索。当前大量系统仍采用任务孤立的建模方式,难以充分利用这些跨任务关联,限制了模型在真实场景中的泛化能力和系统集成能力。此外,语音-人脸多模态学习还面临数据集分散、标注粒度不统一、模态缺失、多说话人干扰、低资源语言、人口统计偏差和隐私伦理风险等挑战。在多模态大模型快速发展的背景下,该领域亟需从碎片化任务研究走向统一的人本多模态建模框架。本文正是在这一背景下,对语音-人脸多模态学习进行系统梳理,旨在揭示其理论基础、任务脉络、数据资源、方法演进和未来趋势。
【综述框架】
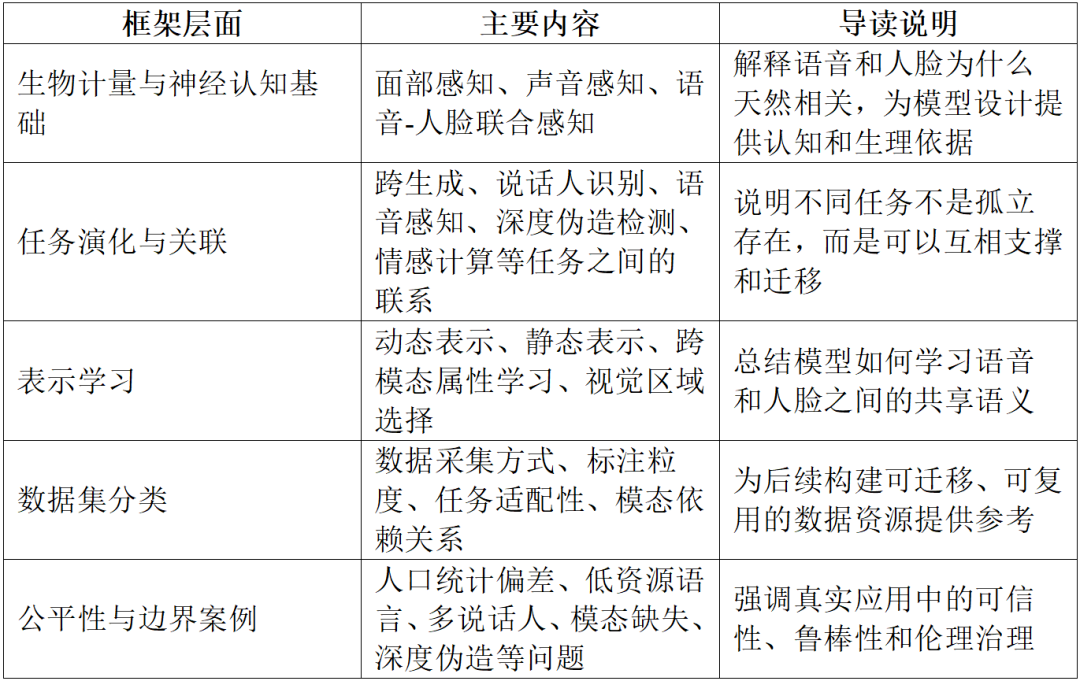
本文围绕人本语音-人脸多模态学习构建了一个从理论基础到任务应用、从数据资源到未来趋势的系统性综述框架。与传统音视频综述不同,本文并不只是按照音频任务或视觉任务分别罗列方法,而是以人为核心主体,分析声音与面部信息在身份、情绪、语言、行为和认知层面的内在联系。整篇综述主要从五个层面展开,如表1所示:
第一,梳理语音-人脸感知的生物计量与神经认知基础,说明声音和面部之间并非简单的模态组合,而是存在生理结构、身份表达和认知加工层面的深层联系;第二,分析语音-人脸相关任务的演化路径和相互关联,揭示不同任务之间可以共享表示、监督信号和归纳偏置;
第三,总结面向语音-人脸数据的人本表示学习方法,强调动态表示、静态表示、跨模态属性学习以及视觉区域选择对模型语义学习的影响;
第四,系统整理语音-人脸相关数据集,从采集流程、标注粒度、任务兼容性和模态依赖关系等角度进行分类;
第五,讨论人口统计偏差、真实场景边界案例和伦理风险,指出公平性与鲁棒性是人本多模态系统走向实际应用必须解决的问题。
表1 综述框架与导读结构概览
【主要内容】
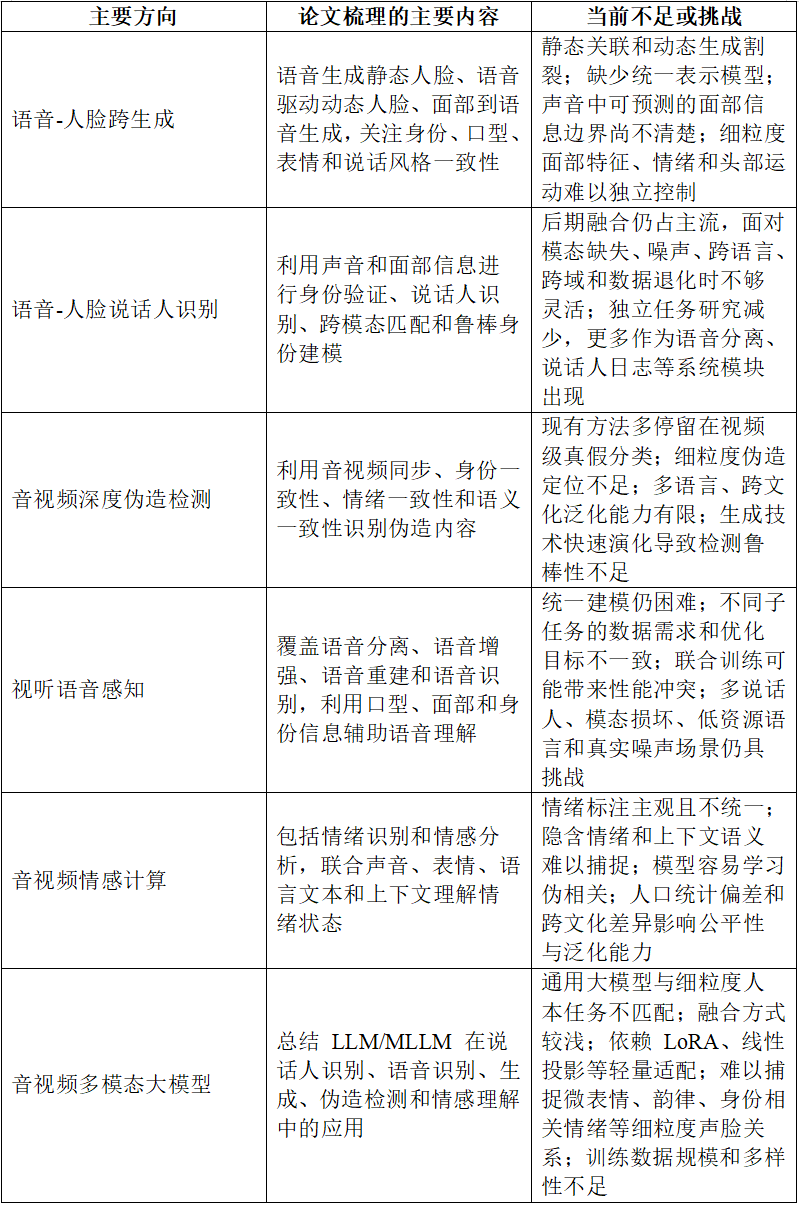
本文系统梳理了人本语音-人脸多模态学习中的核心研究方向,具体参考表2,包括语音-人脸跨生成、语音-人脸说话人识别、音视频深度伪造检测、视听语音感知、音视频情感计算以及音视频多模态大模型。与一般综述只罗列任务不同,本文更强调这些方向之间的内在联系:它们都围绕“人”的声音、面部、身份、情绪、语言和行为展开,许多任务之间共享表示空间、监督信号和建模假设。例如,语音-人脸关联学习可以支撑说话人识别和跨模态生成;视听语音增强、语音分离和语音重建可以作为语音识别的前端模块;情感计算中的表情、语调和语义信息也可以辅助深度伪造检测和虚拟人生成。
首先,在语音-人脸跨生成方向,论文总结了从语音生成静态人脸、语音驱动动态人脸到面部生成语音等任务的发展。该方向的核心目标是建模声音与面部特征之间的内在联系,使模型能够根据声音推断身份、年龄、性别、表情、口型和说话风格等视觉信息,或反过来根据面部运动恢复语音。然而,论文指出,当前静态声脸关联和动态人脸生成通常被分开研究,缺少一个能够同时支持静态身份关联和动态表情/口型生成的统一表示模型。此外,一个根本问题仍未解决:声音中到底包含多少可预测的面部信息,哪些面部属性可以由声音推断,哪些属性本质上具有不确定性。
其次,在语音-人脸说话人识别方向,论文回顾了从手工融合、深度融合到面向真实场景的鲁棒建模方法。该方向利用声音和面部两种模态进行身份验证、说话人识别和跨模态身份匹配,在智能安防、会议分析、个性化服务和多说话人场景中具有重要价值。当前方法中,后期融合仍然是主流策略,因为其实现简单且在受控环境下效果较好。但论文指出,当系统面对模态缺失、噪声干扰、跨语言、跨域或数据退化等真实场景时,简单后期融合的局限性会变得明显。近年来,该方向也逐渐从独立任务转向更大系统中的功能模块,例如服务于语音分离、说话人日志和情感场景分析。
再次,在音视频深度伪造检测方向,论文将语音-人脸不一致性视为识别伪造内容的重要线索。该方向不仅关注面部伪造或声音伪造本身,也关注身份一致性、口型同步、语音-视觉相关性、情绪一致性和语义一致性。相比单模态伪造检测,语音-人脸多模态检测更适合识别复杂生成式 AI 内容,因为伪造模型往往难以同时保持声音、面部、身份、情绪和时间动态的一致性。不过,论文指出,现有方法仍主要集中在视频级真假分类,而真实风险往往来自局部片段篡改。例如,只改动一句话中的关键词就可能改变整个视频含义。因此,细粒度伪造定位、多语言和跨文化泛化,以及对快速演化生成技术的鲁棒性,仍是该方向的重要挑战。
在视听语音感知方向,论文将语音分离、语音增强、语音重建和语音识别放在同一任务谱系中讨论。语音分离和增强利用视觉信息帮助模型在噪声或多说话人环境中提取目标语音;语音重建尝试从静默视频或口型运动中恢复语音;视听语音识别则利用声音和口型共同识别语言内容。论文指出,该方向正在从任务专用模型走向统一建模,例如将增强、分离、识别和重建放入同一模型框架中。然而,不同任务的数据需求、优化目标和输入输出形式并不一致,简单联合训练可能导致性能下降。此外,真实场景中的多说话人交互、跨会话变化、音频或视觉模态损坏、低资源语言等问题,也对模型鲁棒泛化提出了更高要求。
在音视频情感计算方向,论文主要讨论情绪识别和情感分析。该方向试图从声音、面部表情、语言文本和上下文中理解人的情绪状态和态度倾向,可用于心理健康、人机交互、智能客服、教育评估和社交机器人等场景。论文指出,情感计算并不只是识别“开心、愤怒、悲伤”等表层类别,还需要理解语义、上下文、文化背景和个体表达差异。当前方法面临的挑战包括:情绪标注主观性强,不同数据集标注体系不一致;模型容易忽略隐含情绪,例如反讽、隐喻、场景语境和观众反馈;模型可能依赖伪相关特征,例如把露齿简单等同于快乐;同时,情绪理解还受到性别、年龄、肤色、语言和文化背景影响,因此公平性和跨文化泛化是该方向的重要问题。
最后,在音视频多模态大模型方向,论文总结了 LLM/MLLM 在人本语音-人脸任务中的初步应用,例如说话人识别、语音识别、跨模态生成、深度伪造检测和情绪理解。大模型具备强大的语义理解、推理和多任务适配能力,为构建统一人本多模态系统提供了可能。但论文也指出,当前大多数多模态大模型仍是通用模型,主要面向图文或通用音视频理解,并未针对语音-人脸数据进行专门设计。现有方法通常依赖浅层融合方式,例如线性投影、Q-Former 或 LoRA 适配,难以捕捉细粒度声脸关联,如微表情、细微韵律变化、说话人相关情绪线索等。此外,人本语音-人脸训练数据的规模和多样性仍远小于通用多模态基础模型,限制了模型在复杂边界场景中的泛化能力。
表2 各主要研究方向的内容梳理与关键挑战
【领域挑战】
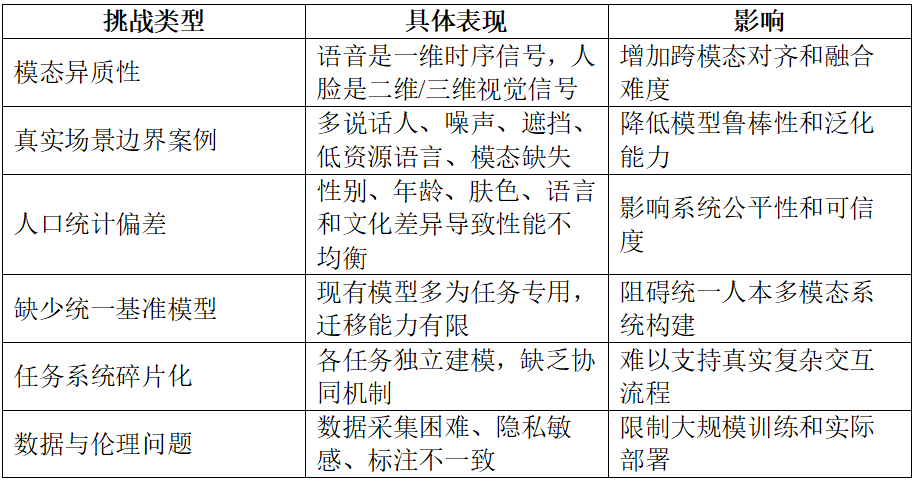
尽管语音-人脸多模态学习已经在多个任务上取得进展,但该领域仍面临一系列关键挑战。首先,语音和人脸属于高度异质的模态:语音是一维连续时序信号,人脸则通常表现为二维图像或三维动态视频,二者在采样频率、时间对齐、空间结构和语义粒度上存在显著差异,这给跨模态融合和统一表示学习带来困难。其次,真实场景中的人类交互复杂多变,模型需要应对多说话人重叠语音、多语言和低资源方言、视觉遮挡、音频噪声、模态缺失、跨域迁移和长时序对话等边界案例。第三,人本多模态系统容易受到人口统计偏差影响,不同性别、年龄、肤色、语言和文化背景的人群可能在识别、生成、检测和情感分析任务中受到不公平对待。
此外,该领域目前仍缺少类似自然语言处理或计算机视觉中通用基础模型的统一基准框架。现有模型大多针对单一任务设计,难以迁移到其他语音-人脸任务中,也难以支撑真实人机交互中多个任务的顺序组合或并行协同。数据集方面,语音-人脸数据采集成本高、隐私敏感性强,且不同任务对标注粒度、同步精度和身份信息的需求不同,导致数据资源分散、可复用性不足。最后,随着生成式 AI 的发展,语音-人脸技术既能增强自然交互,也可能被用于身份伪造、情绪操纵和虚假内容传播,因此隐私保护、伦理治理和可信评估成为该领域不可回避的问题。汇总信息参考表3。
表3 人本语音-人脸多模态学习的领域挑战概览
【发展趋势】
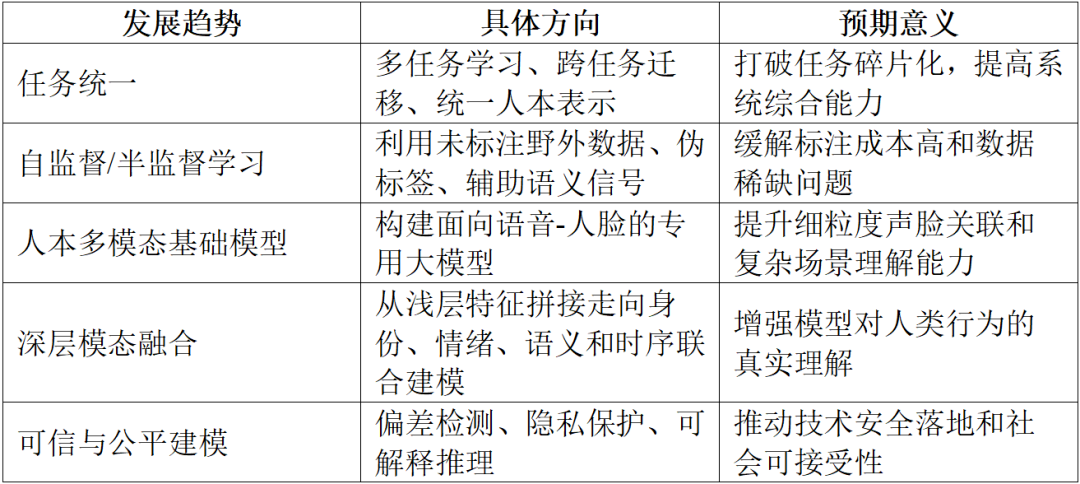
未来人本语音-人脸多模态学习将呈现出任务统一、数据利用方式转变和大模型融合三方面趋势,如表4所示。首先,任务边界将逐渐模糊。语音增强、语音分离、语音重建、语音识别、说话人识别、情感理解和深度伪造检测之间并不是完全独立的任务,它们都围绕人的声音、面部、身份和行为展开。未来模型需要从单任务优化走向多任务协同,通过共享表示和跨任务迁移提升系统整体能力。其次,自监督和半监督学习将成为利用野外语音-人脸数据的重要手段。由于高质量标注数据昂贵且任务依赖强,未来研究需要更多利用未标注音视频、字幕、社交互动信号和伪标签生成机制,构建更具泛化能力的人本多模态表示。最后,多模态大模型和预训练范式将持续推动该领域发展。现有通用 MLLM 主要面向图文或通用音视频理解,在细粒度声脸关联、口型同步、身份一致性、情绪变化和多说话人交互方面仍存在不足。未来需要构建面向语音-人脸数据的专用人本多模态基础模型,使模型能够同时理解声音、面部、语言、身份、情绪和上下文。与此同时,公平性、隐私保护和可解释性也将成为重要发展方向。未来系统不仅要追求性能提升,还需要能够解释模型为何作出某种判断,避免对特定人群产生系统性偏差,并在真实应用中满足可信、安全和伦理要求。
表4 人本语音-人脸多模态学习的发展趋势概览
【结论】
本文围绕人本语音-人脸多模态学习展开系统综述,从生物计量和神经认知基础出发,梳理了数据集、表示学习、典型下游任务、多模态大模型以及公平性和鲁棒性挑战。论文指出,语音-人脸多模态学习的发展受到数据资源、表示模型和任务设计三者共同影响:数据集决定模型能够学习到什么样的人本语义,表示学习连接原始语音和面部信号与具体任务目标,模型架构则决定这些表示能否在真实应用中发挥作用。因此,该领域未来不能只依赖单一任务上的性能提升,而需要建立跨任务、跨模态、可解释且可信的统一研究框架。总体而言,这篇综述为语音-人脸多模态学习建立了一幅较为完整的研究图谱。它不仅总结了已有方法和任务进展,也强调了该领域与人类感知、认知科学、心理学、伦理治理和多模态大模型之间的紧密联系。随着虚拟人、智能助手、内容安全、医疗健康和社交机器人等应用的发展,语音-人脸多模态学习将成为构建自然、可信和具有人类感知能力智能系统的重要基础。未来,只有将认知启发、数据建设、模型创新和伦理治理结合起来,才能推动该领域从分散任务研究走向真正的人本多模态智能。
【论文链接】https://ieeexplore.ieee.org/document/11578304
【代码链接】https://github.com/audio-visual/Survey-on-voice-face-multimodal-learning
