语音小管家
让 AI 生成一段踩着音乐跳舞的视频,今天看起来已经不算难事。Sora 2、Veo 3 这些模型给出的画面光鲜、配乐悦耳,第一眼几乎挑不出毛病。可只要你把音量调大,盯着舞者的手脚看上十几秒,往往会冒出一种说不清的别扭:动作明明在动,却和鼓点各走各的,重拍来了身体慢半拍才反应。画质和音质都在飞速逼近专业水准,唯独节奏的咬合始终差一口气。
那么问题来了——这一口气到底差在哪、差了多少?这件看似主观的事,恰恰是现有评测体系几乎给不出答案的地方。
为什么音乐-舞蹈联合生成比普通音视频生成难这么多?通用音视频任务关心的,是关门时配上一声响、画面下雨时音轨里有雨声这类事件级、稀疏的对应。而音乐是一条几乎连续的流,节奏层层嵌套;舞蹈要用连续的全身动作去回应这条流的每一次脉动,要求的是逐拍级别的精细耦合,完全不是一个量级的事。
可现有评测停在哪里?当下主流的音视频评测(如 VABench)基本只看两件事:单模态的音画质量打分,以及通用的视听一致性——语义对不对应、事件是否共现。用来判断音效配没配上画面足够了,一旦换到舞蹈场景却集体失灵:单模态指标看不见跨模态耦合,通用一致性又太粗,抓不住节奏与肢体之间那种细颗粒度的咬合。于是就出现了开头那一幕,模型在质量维度拿了高分,拍子却踩不准,而分数对此毫无察觉。
那把过去音乐到舞蹈研究里的拍点指标搬过来,行不行?也不行。那类指标依赖配对真值,要拿生成结果去比对一段标准答案的拍点。但音乐-舞蹈本身是开放式的,同一句提示词能对应无数种合理的编舞与配乐,用单一答案做逐点对齐,既不公平也不充分。真正缺的,是一把既能算、又能感知,且不依赖标准答案的尺子。
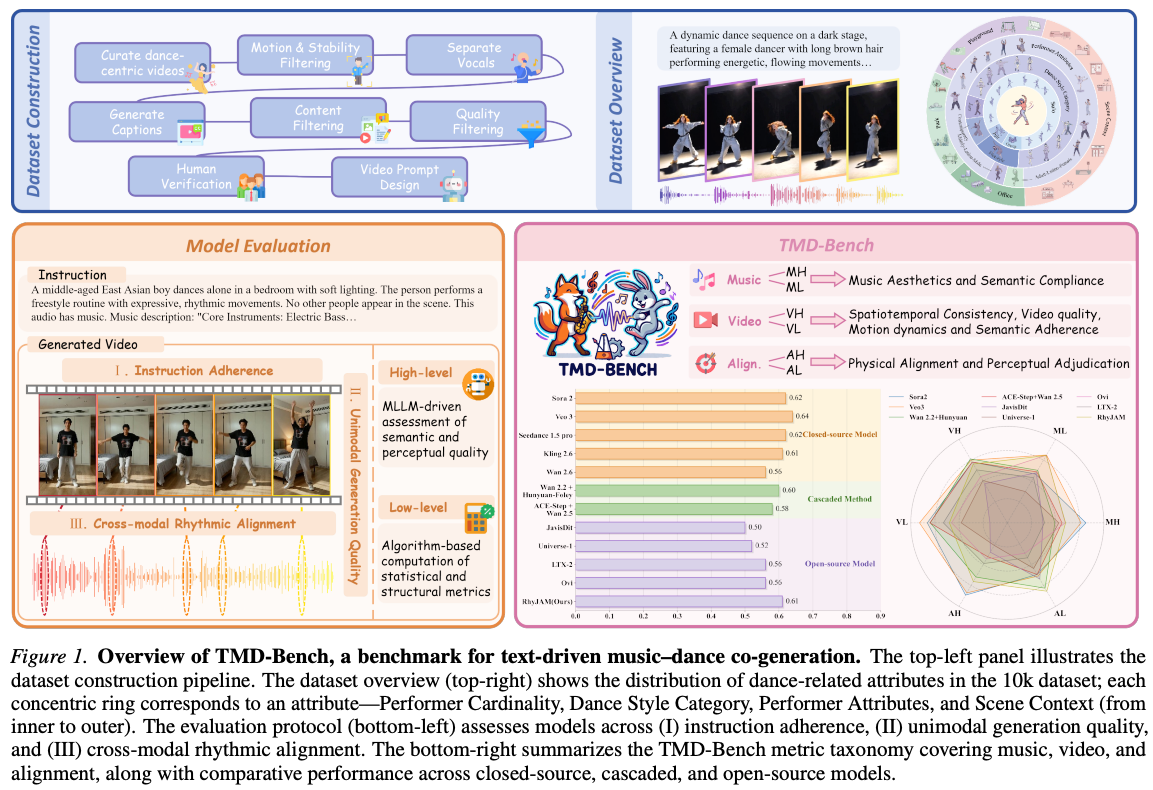
这正是浙江大学、腾讯与新加坡国立大学团队提出 TMD-Bench 想补的位置——首个面向文本驱动音乐-舞蹈联合生成的多层级评测范式。
它的思路是什么?把联合生成的好坏拆成三条互补的轴:音乐和舞蹈各自的生成质量、是否忠实于文本指令、以及最核心的,音乐节奏与舞蹈动作重音是否咬合。每条轴又同时用两层来量:底层是可计算、可扩展的物理指标,强调稳定;高层请来多模态大模型当裁判,去捕捉那些没法被单一数字还原的节奏感知和组合语义。
最硬的骨头是节奏对齐,团队为此设计了 MDAlign。它先把音频和视频都翻译成同一条时间轴上的离散事件:音频侧抽出节拍时间点,视频侧用姿态估计算出关键点的逐帧位移,平滑后把运动的局部峰值定义为动作重音。在此之上定义两个指标,一个衡量动作重音有没有落在拍子附近,看动作踩得准不准;一个衡量有多少拍子真正被动作回应,看有没有漏拍。关键在于,它们完全建立在生成结果自身抽出的节奏事件上,不需要任何标准答案,天然适配开放式生成。而物理匹配测不到的张力松紧,再交给具备推理能力的大模型补上一层感知判断。
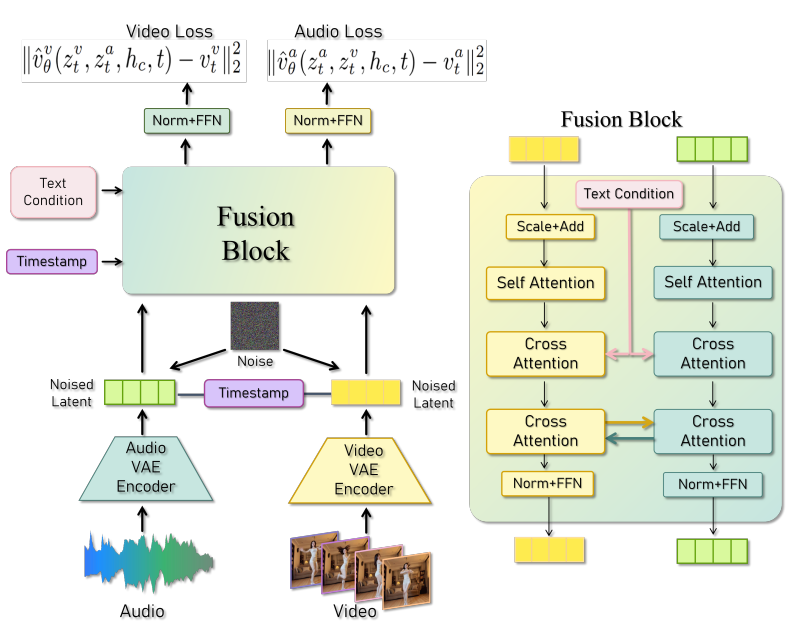
光有尺子还不够,团队还想验证一个判断:统一架构是不是天生更适合做跨模态节奏一致性?于是他们顺手给出基线 RhyJAM——一个基于流匹配的端到端扩散模型,在同一个扩散过程里同时生成音乐和舞蹈,音视频在相同时间步加噪、共享同一份文本语义,再通过模态内、文本条件、跨模态三类注意力逐步融合。
那么这套尺子量出来的结果是什么样?团队在 100 条提示词上展开评测,全程用与人类判断最吻合的 Gemini 3.0 Pro 当裁判,把闭源、级联与开源共十余个系统放在一起横量。
先看作为评分地基的音乐字幕器(Table 1),它在速度、功能场景等维度与大模型判断的一致率超过 0.9,说明拿它来给音乐语义打分是靠得住的。
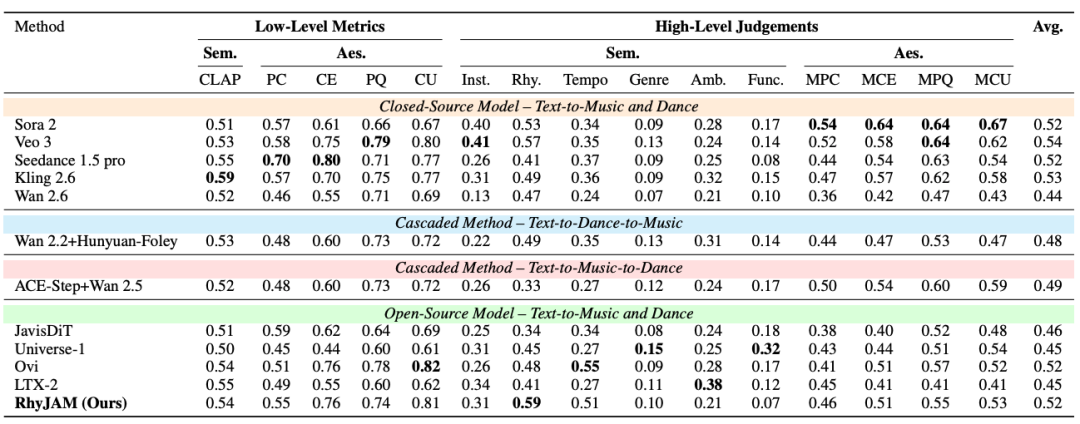
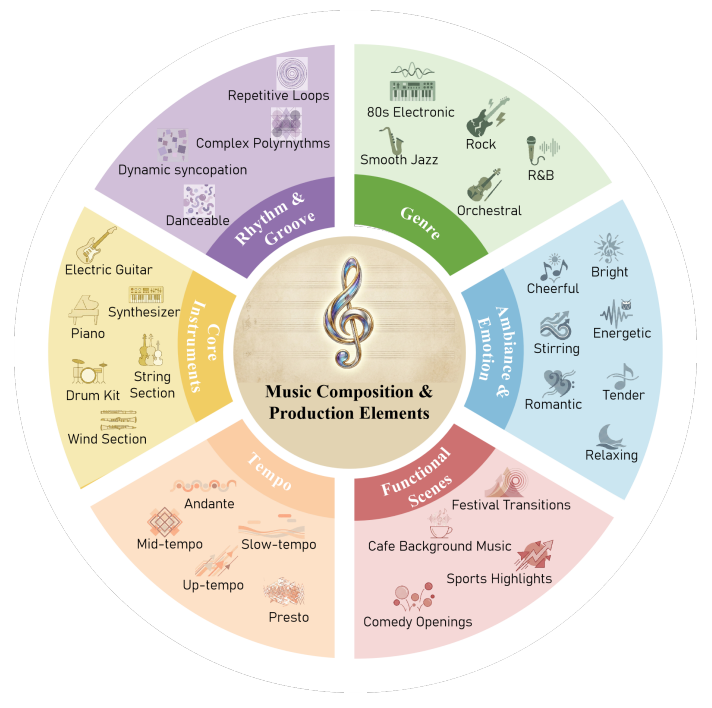
音频侧(Table 2)暴露出一个共性难题:流派、功能场景、情绪氛围这些需要把握整体结构的属性,几乎所有模型都跟不准,而 RhyJAM 在节奏与律动维度拿到全场最高(0.59),闭源系统则在制作质量和听感上整体领先。
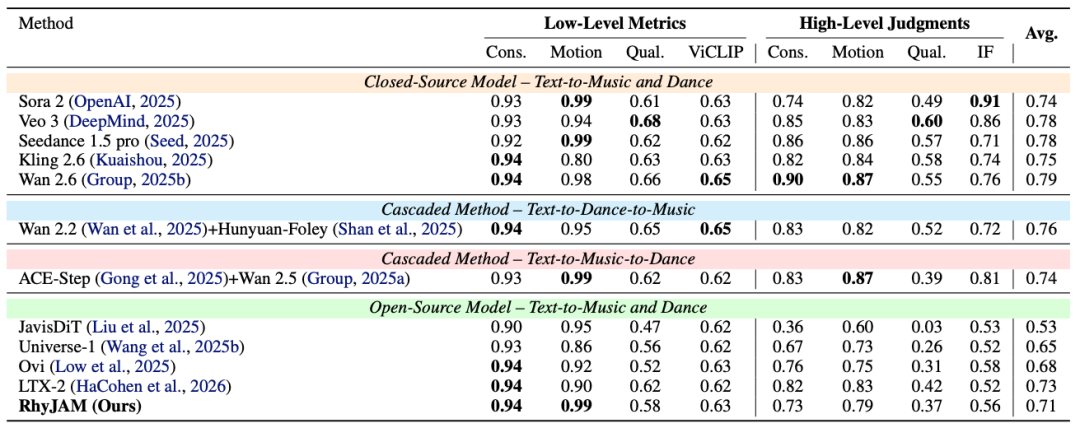
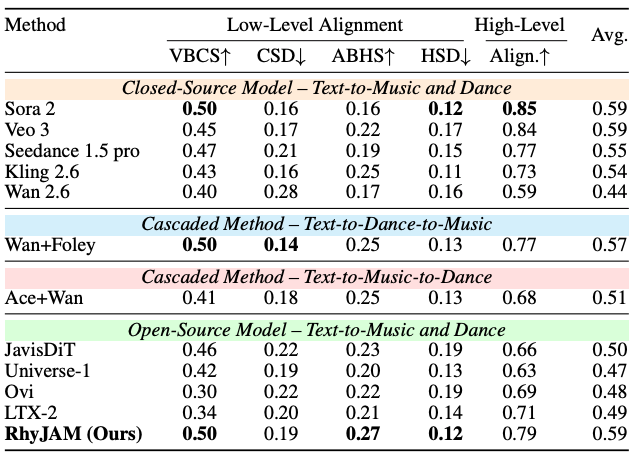
视频侧(Table 3)格局类似,闭源模型在画质和指令遵循上明显更强,RhyJAM 在开源阵营里表现最为均衡,但开源与闭源之间的差距依旧清晰。真正的重头戏在节奏对齐(Table 4):大多数模型都顾此失彼,像 Sora 2 拍点贴得很准、漏拍却严重(覆盖率仅 0.16),级联管线覆盖率上来了、整体一致性又掉队,唯有 RhyJAM 同时守住了高贴近度(0.50)和全场最佳的覆盖率(0.27),感知层对齐分也达到 0.79,超过所有开源与级联方案,逼近最强闭源系统。
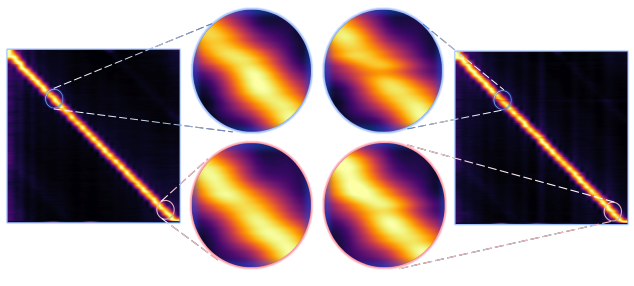
把模型内部摊开看(Figure 5),RhyJAM 的跨模态注意力呈现连续平滑的对角线,意味着画面动作与音乐节拍稳定对应;而没经过节奏对齐训练的基线,注意力碎成一片、不断抖动,节奏耦合明显更弱。
项目与论文
论文标题:TMD-Bench: A Multi-Level Evaluation Paradigm for Music–Dance Co-Generation
研究团队:浙江大学、天津大学、青岛大学、上海交通大学、新加坡国立大学等