
 语音小管家
一边聊天,一边办事。 从办公协作,走进智能座舱。
在上一篇《qwen-audio-agent架构解析》中,我们主要围绕办公场景介绍了框架。这一次,我们把它带进智能汽车座舱。
我们做了一套可运行的智能座舱示例:接入车控、音乐、导航与天气,让用户一次交代多件事、用一句话规划多个途经点,还能在后台任务持续执行时继续聊天,并结合车况与偏好提供服务。
围绕座舱交互,我们设计了分领域工具体系与严格评测。采用 qwen-audio-agent 前后台协同的完整链路,本次短上下文用例通过率达到 97.67%(84/86),在独立设计的 50 轮连续对话评测中,逐轮工具行为准确率达到 99.80%(499/500)。
▎从一句指令,到一路协作
视频基于社区贡献界面录制,仅作软件模拟演示;如涉及侵权,请联系核实删除。
后台持续工作,前台畅聊不停
将需要检索与整理的任务交给后台后,用户仍然可以继续聊天、使用车控工具。任务完成时,结果再自然回到前台对话,不需要用户一直等待或反复追问。
一句话多意图,多项操作执行
一次语音交互包含多个操作意图,模型生成多个 Tool Call,分别完成对应操作。框架汇集执行结果,再由前台统一反馈,用户不必拆成多轮指令。
多个途经地点,一次规划导航
一句话交代多个地点,智能体自动组织途经点、规划导航路线。
语音创建技能,车况变化自动响应
用语音创建专属技能,例如设置个性化提醒,智能体可以感知环境、按需响应。
记住你的偏好,推荐更合心意
智能体从日常对话中自动记住用户的口味与习惯,推荐餐厅时结合偏好和当前位置给出更个性化的选择。记忆在交互中自然积累,用户不必每次重复交代。
▎工具调得准,执行响应快
工具按业务领域组织,定义、执行器与前后台路由独立配置;当前共提供 6 类、38 个场景工具,各类工具的能力及默认执行方式如下:
| 业务领域 | 工具数 | 能力示例 | 默认位置 |
| 车控 | 11 | 车辆位置与车况、空调、车窗、天窗、车灯、充电等 | 前台 |
| 导航 | 12 | 地点搜索、路线规划、多途经点、常用地点与路线偏好 | 前台 |
| 音乐 | 10 | 搜索与播放、上下曲、音量、媒体源与收藏 | 前台 |
| 天气 | 1 | 城市天气查询 | 前台 |
| 闪购 | 1 | 商品搜索与下单演示 | 后台 |
| 自定义技能 | 3 | 列出、创建、更新、加载工作流或温度提醒规则 | 前台 |
| 合计 | 38 | 覆盖即时操作与后台组合任务 | 按需分流 |
执行位置可按业务调整;以下准确性评测覆盖车控、导航、音乐、天气四类,仅测试前台模式。
01. 工具调用准确性
Realtime-plus 为语音模型受控直连;Realtime-plus + Harness 为同一模型的完整产品链路。两款文本模型作为参考,均开启思考模式。
短指令:86 个用例,四类业务
覆盖车控、音乐、导航、天气:62 个单轮与 24 个短多轮用例,共 111 轮、92 次预期工具调用。
表 1 · 短用例分领域整例通过率
| 领域 | 测试用例数 | Realtime-plus + Harness | Realtime-plus | qwen3.7-plus | qwen3.8-flash |
| 车控 | 24 | 100.00% | 100.00% | 95.83% | 100.00% |
| 音乐 | 18 | 94.44% | 94.44% | 94.44% | 94.44% |
| 导航 | 36 | 97.22% | 91.67% | 100.00% | 100.00% |
| 天气 | 8 | 100.00% | 100.00% | 100.00% | 100.00% |
| 总体 | 86 | 97.67% | 95.35% | 97.67% | 98.84% |
长对话:10 组对话,每组 50 轮
与短用例评测不同,长对话评测围绕 22 种工具,单独设计了 10 组对话用例,每组连续交互 50 轮。共包含 250 次预期工具调用,穿插 250 个不应调用工具的闲聊轮次,考察历史上下文累积过程中的工具调用表现。
表 2 · 多轮长对话工具调用准确率
| 评测对象 | 总体准确率(%) | 需工具轮准确率(%) | 无工具轮准确率(%) |
| qwen3.8-flash | 98.60 | 98.80 | 98.40 |
| qwen3.7-plus | 98.40 | 97.60 | 99.20 |
| Realtime-plus | 99.20 | 98.40 | 100.00 |
| Realtime-plus + Harness | 99.80 | 100.00 | 99.60 |
02. 工具执行返回时延:前台直调与后台委托
工具采用即时操作前台直调、复杂任务后台委托的分工。实验保持前台为 qwen-audio-3.0-realtime-plus,对比它直接调用同一套业务工具,与交给后台 qwen3.8-flash 再调用工具的等待。
表 3 · 工具执行返回时延
| 领域 | 测试轮数 | 前台直调均值/秒 | 后台委托均值/秒 | 差值/秒后台-前台 |
| 车控 | 23 | 1.539 | 3.277 | 1.738 |
| 音乐 | 17 | 1.154 | 2.506 | 1.353 |
| 导航 | 44 | 1.616 | 4.301 | 2.685 |
| 天气 | 8 | 1.187 | 3.361 | 2.174 |
| 总体 | 92 | 1.480 | 3.560 | 2.080 |
本次样本中,前台直调与后台委托的工具返回均值相差约 2.08 秒。
此处比较工具放置方案,并非纯模型速度;两侧有效样本不同,不含后续语音播报。
▎架构做减法,体验做加法
从即时车控到长时间任务,Harness 把模型、工具与车内环境组织成一套连续工作的系统。
01. 统一理解,让座舱化繁为简
车控、导航、音乐共用同一个实时语音模型和对话上下文。业务能力通过工具接入,前台不必为每类任务再配置一套独立的理解模型。新增座舱服务,主要扩展工具与执行逻辑,减少多模型路由和联调负担。
02. 长任务后台推进,前台随时响应
采用长时间任务后台执行、即时操作前台直调的分工:资讯整理、行程研究异步推进,聊天和车控工具调用继续在前台完成;后台结果进入播报队列,在对话空隙自然带回。
// 模型工具调用示意
spawn_thinking({
  objective: "整理三条近期 AI 新闻,附上来源"
})
// 返回受理回执,后台继续执行
03. 感知车况,回应不只依赖语音
将位置与车况组织为状态,把触屏操作、条件变化通过事件协议接入上下文。Harness 将上下文更新与回复触发分离:普通变化只更新认知,状态变化满足用户自定义技能的条件时再提醒,感知环境而不频繁插话。
04. 车控并行执行,结果合并播报
“开车窗、调空调、调音量”可以一次交代。模型单次输出多个工具调用,Harness 并行调度可独立执行的操作,按调用标识汇齐结果,再由前台统一播报,减少串行等待与反复语音打扰。
05. 偏好跨行程延续,服务因人而异
采用“人设+用户信息+长期记忆”分层设计:助手的“灵魂”保持稳定,用户偏好从日常对话自动提取、合并保存,再在后续会话中读取。餐厅推荐记得口味,沟通方式贴合习惯,让个性化延续到下一次出行。
06. 模块灵活组合,座舱各有特色
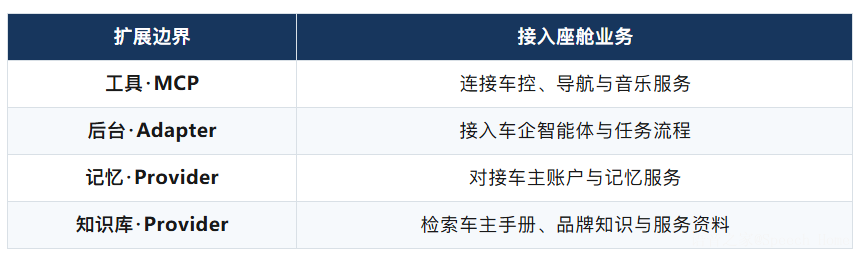
工具、后台智能体、记忆与知识库均可通过标准接口灵活扩展,便于接入车企现有的车控服务、用户体系和品牌知识。在复用核心对话与任务机制的基础上,快速构建贴合自身业务的座舱智能体。
▎模型 × Harness,让语音智能走进更多场景
qwen-audio-3.0-realtime-plus 融合音频理解与生成,兼顾低时延交互、复杂指令理解与自然表达,并自主判断何时回应、何时调用工具。Harness 则连接工具执行、任务调度、环境感知与长期记忆,让模型的判断转化为持续的业务行动。
智能座舱是这一组合的一次场景实践。未来,我们将继续面向客服、数字人、具身智能等领域拓展,让更多业务拥有能理解、会决策、可执行的语音交互能力。
参考资料:
座舱示例:https://github.com/QwenAudio/qwen-audio-agent/tree/main/examples/smart-cockpit
项目主页:https://github.com/QwenAudio/qwen-audio-agent
