
 语音小管家
近日,上海交通大学听觉认知与计算声学实验室关于音乐编辑方面的论文被本次IJCAI会议收录并做展示。该论文首次提出音乐编辑任务,并尝试将潜在扩散模型应用于解决该问题。同时提出了一系列策略提升了音乐编辑中的和谐性和一致性问题,以及长时音乐编辑带来的计算量和泛化性问题。基于论文中提出的音乐编辑框架,在音频质量、指令相关度、和谐性等多个指标上都取得了最优的结果。此外,得益于提出的改进策略,框架也支持长时和多轮音乐编辑。
InstructME: An Instruction Guided Music Edit Framework with Latent Diffusion Models
作者列表:Bing Han, Junyu Dai, Weituo Hao, Xinyan He, Dong Guo, Jitong Chen, Yuxuan Wang, Xuchen Song, Yanmin Qian
合作单位:Bytedance
背景动机
基于潜在扩散模型[1],我们第一个提出了适用于原子和高级操作的文本指令引导的音乐编辑框架InstructME。
我们指出了音乐编辑领域中一致性和和谐性的特殊问题,并通过Chunk-Transformer开发了Multi-scale Aggregation策略和Chord Condition来解决这个问题。
我们提出了音乐编辑任务在音乐质量、文本相关性和和谐性方面的定量评估指标。
我们提出的InstructME框架在主观和客观评估上都超越了以前的基线系统。
方案
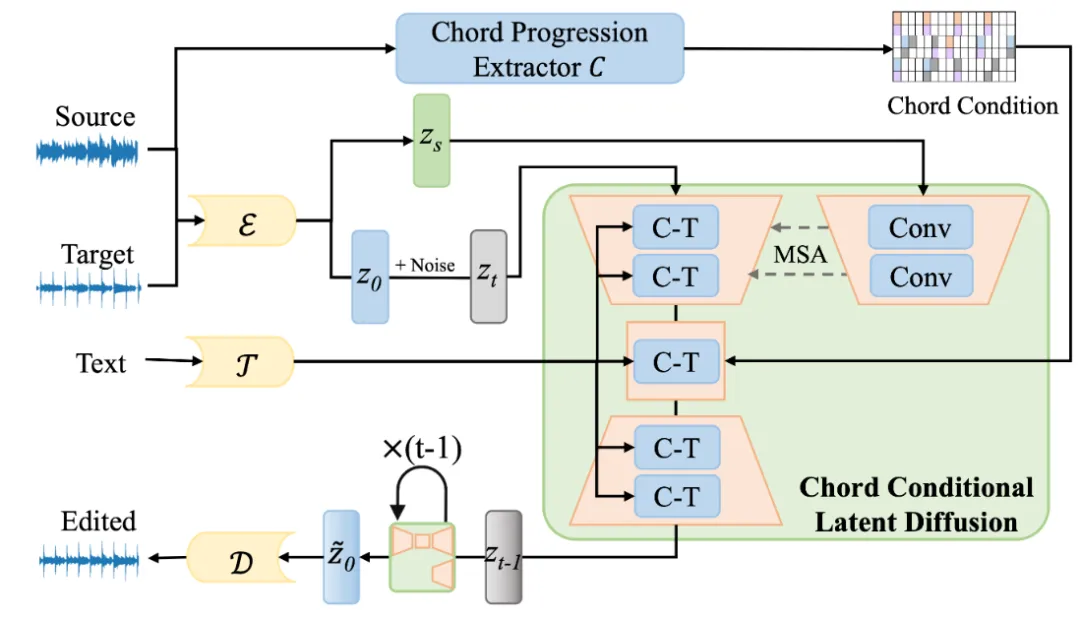
图1 InstructME框架结构示意图
整体框架如图1所示,InstructME 将音乐片段x_s和文本指令y作为模型的输入,并生成一个新的音乐片段x作为编辑后的片段。然后,对于每一个文本指令y,我们使用预训练好的文本编码器(T5)[2]将文本y转正文本嵌入。同时,一个基于变分自编码器(VAE)的音频编码器也将音乐片段x和x_s从一维波形转换到二维潜在表征空间,作为潜在扩散模型U-Net的输入。在推理阶段,经过扩散模型生成的潜在表征,则可以使用VAE的解码器还原成一维波行音频。
为了使扩散模型更适合音乐编辑任务,我们提出了一种增强的U-Net[3],包含了多尺度聚合(Multi-scale Aggregation)和和弦条件(Chord Condition)等策略。
多层级聚合策略(Multi-scale Aggregation)
与音乐生成任务不同,音乐编辑任务的一个需求是保留原始音乐中的某些内容和属性。为了保持原始音乐和编辑音乐之间的一致性,我们在U-Net的输入端直接将源音频z_t与目标音频z _s在特征纬度上拼接。同时,为了更有效地捕捉源音乐的高级特征,我们引入了一种多尺度聚合(MSA)策略。在U-Net中将源音频表征z_s输入到多层卷积编码器中,为相应的U-Net层生成具有不同分辨率的特征图,并融合到U-Net主干建模中,有效提升了InstructME音乐编辑的一致性。
和弦条件(Chord Condition)
和弦进行是定义一首乐曲音乐和谐的关键因素。在[4]中,研究者发现扩散模型中瓶颈特征的语义潜在空间具有很好的图像操纵的特性。首该工作启发,我们采用和弦识别模型C来提取源音乐的和弦表征p,并使用交叉注意力机制结合到U-Net的瓶颈特征映射中,有效的保证了音乐编辑时的和谐性。
Chunk Transformer
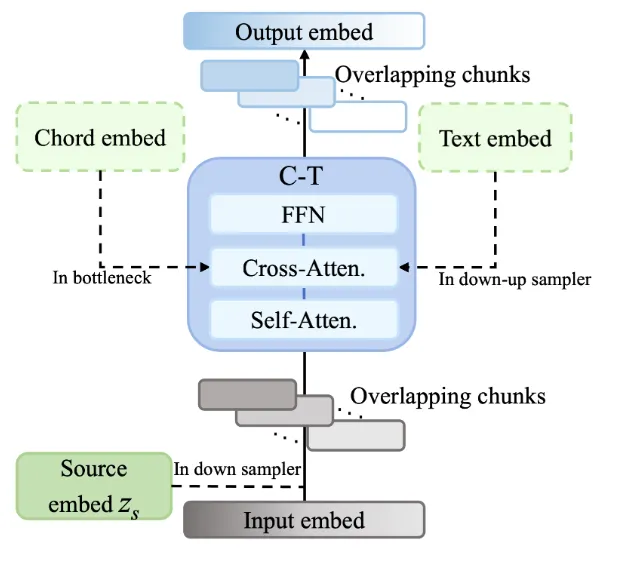
图2 Chunk Transformer框架结构示意图
由于自注意力机制的平方复杂度,长时音乐序列的编辑会带来大量的计算。为了缓解这个问题,如图2所示,我们采用块转换器以块的方式对长期时间依赖关系进行建模。该过程包括三个步骤:(1)将T帧的特征分割成重叠50%的K帧块,(2)通过Transformer对每个块进行单独处理,(3)最后将重叠的输出块融合合并为原始长度。
实验
训练&测试数据
评估指标
不同音乐编辑任务的评估结果
首先我们在不同音乐编辑任务(提取、去除、增加、替换)上和基线系统AUDIT[6]进行了比较,并计算了所有操作的指标的平均值,展示在了表1。可以看出,我们提出的InstructME框架在所有指标上相比于基线系统都有着很大的提升。同时,在out-of-domain的评估集上Slakh也能取得很好的效果,说明了我们框架的泛化性。
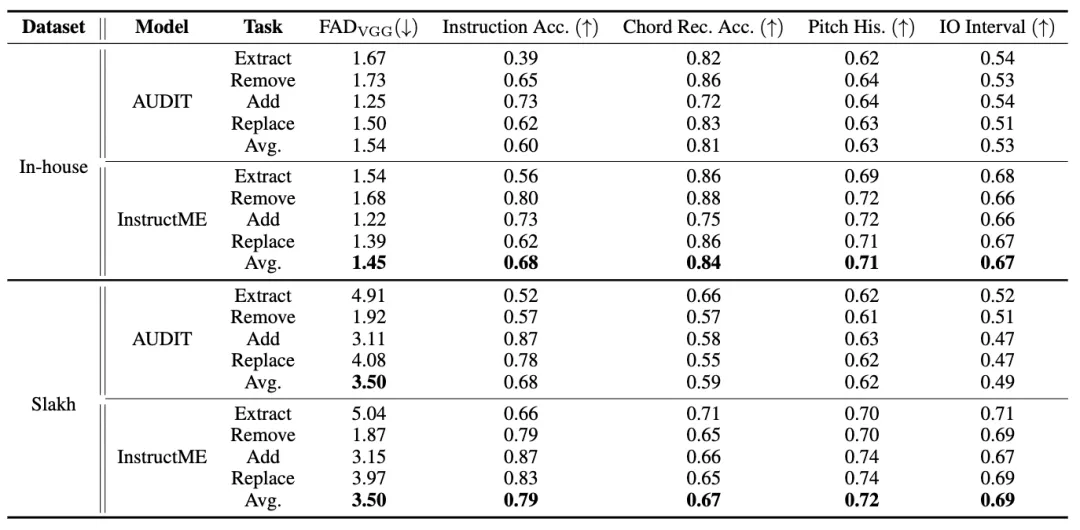
表1 不同编辑任务的性能评估
不同编辑时长的性能比较
为了训练的效率,所有的系统在训练的时候都是采用的10s的片段。从表2可以看到,当推理时应用到更长的音乐片段上时,基线系统回因为不匹配带来了巨大的性能下降。但我们提出的InstructME使用了chunk-Transformer,能有效的降低长时音乐编辑的计算量,缓解时长不匹配带来的性能下降。
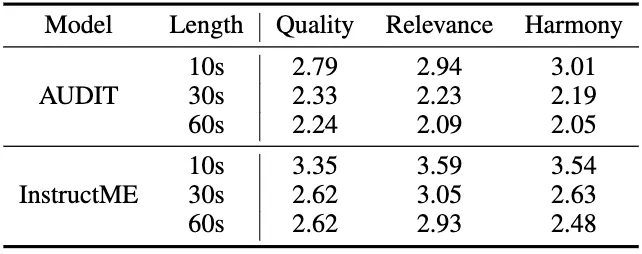
表2 不同编辑时长的性能比较
消融实验
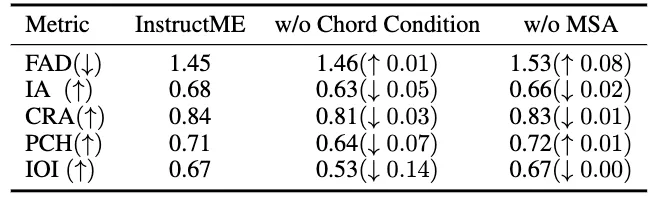
表3 关于Chord Condition和MSA的消融实验结果
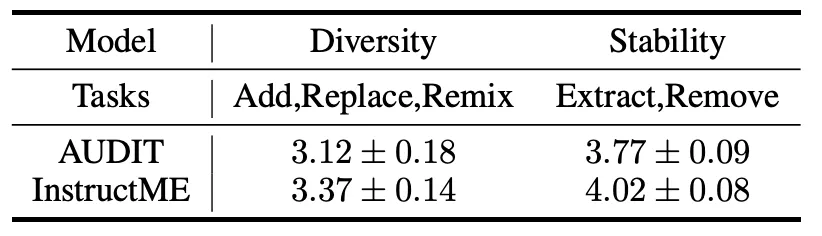
在图3中,我们在不同的编辑任务中,进行了多次采样来观察我们提出的框架的稳定性和多样性。从可视化中可以看出,在Add、Replace和Remix等需要创作型的编辑操作时,多次采样出来的频谱图会出现很大的差异,说明了InstructME的多样性能力。而对于Extract和Remove这种有确切答案的编辑操作,多次采样也会出现稳定的编辑结果,说明了InstructME的稳定性。在表4中,我们对多样性和稳定性也做了评估,说明了InstructME的优越性。
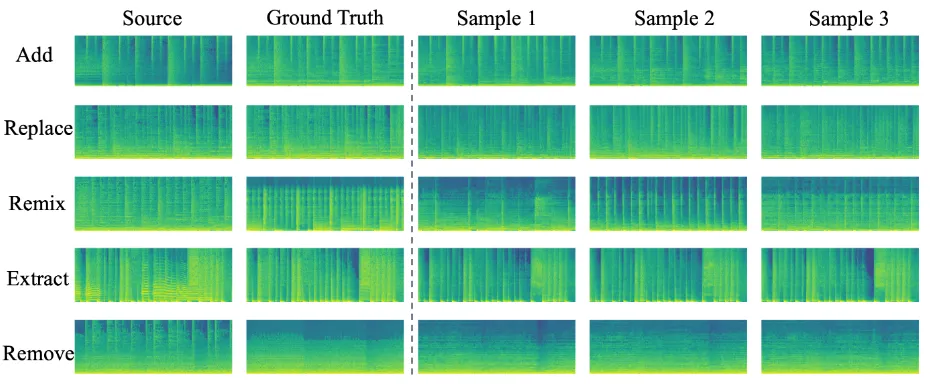
图3 多次编辑采样的频谱图可视化
总结
参考文献
[1] Rombach, R., Blattmann, A., Lorenz, D., Esser, P., & Ommer, B. (2022). High-resolution image synthesis with latent diffusion models. In Proceedings of the IEEE/CVF conference on computer vision and pattern recognition (pp. 10684-10695).
[2] Raffel, C., Shazeer, N., Roberts, A., Lee, K., Narang, S., Matena, M., ... & Liu, P. J. (2020). Exploring the limits of transfer learning with a unified text-to-text transformer. Journal of machine learning research, 21(140), 1-67.
[3] Ronneberger, O., Fischer, P., & Brox, T. (2015). U-net: Convolutional networks for biomedical image segmentation. In Medical image computing and computer-assisted intervention–MICCAI 2015: 18th international conference, Munich, Germany, October 5-9, 2015, proceedings, part III 18 (pp. 234-241). Springer International Publishing.
[4] Jeong, J., Kwon, M., & Uh, Y. (2023). Training-free style transfer emerges from h-space in diffusion models. arXiv preprint arXiv:2303.15403, 3.
[5] Manilow, E., Wichern, G., Seetharaman, P., & Le Roux, J. (2019, October). Cutting music source separation some Slakh: A dataset to study the impact of training data quality and quantity. In 2019 IEEE Workshop on Applications of Signal Processing to Audio and Acoustics (WASPAA) (pp. 45-49). IEEE.
[6] Wang, Y., Ju, Z., Tan, X., He, L., Wu, Z., & Bian, J. (2023). Audit: Audio editing by following instructions with latent diffusion models. Advances in Neural Information Processing Systems, 36, 71340-71357.
