
在语音研究领域,数据集的质量与可获取性是推动其发展的关键要素。可靠的模型构建高度依赖于高质量的数据支撑,这使得数据的采集和标注工作成为该领域研究的核心环节。然而,在实践过程中,无论是采集、整理、标注还是共享大规模数据集,都面临着重重困难。尤其是在儿童语音、健康领域语音以及低资源语言语音等特定领域,这些挑战愈发显著。其主要体现在隐私保护的考量、标准化规范的缺失,以及人工标注所需的高昂成本和漫长时间投入等方面。鉴于此,本次特别研讨会致力于召集相关领域的研究人员,共同探讨并分享他们在语音数据采集和标注方面的实践经验、技术方法以及理论见解。
许多现有的数据集受到所有权或隐私限制,无法实现公开共享。尽管如此,这些数据集在采集和标注过程中所运用的方法和遵循的准则,往往蕴含着与数据本身同等重要的价值。通过分享这些过程性的知识,即使对于那些无法公开的数据集,整个研究领域也能够提升研究的可重复性,并为创建类似的高质量数据集提供有益的借鉴。这种知识的交流与共享,不仅有助于规避在数据采集和标注过程中常见的错误和陷阱,还能够激发创新思维,推动自动化标注工作流程的优化与发展。
接收议题
数据采集的规划策略
涵盖数据采集对象(研究群体)的筛选原则与方法,以及如何设计有效的提示语以获取高质量的语音数据样本,确保数据的代表性和多样性。
数据质量评估体系
聚焦于建立科学、客观的语音数据质量评估指标和方法,能够准确衡量所采集数据的完整性、准确性、清晰度等关键质量特征,为后续的数据处理和模型训练提供可靠的基础。
自动化标注流程构建
探索如何利用先进的技术手段,如机器学习算法、自然语言处理技术等,实现语音数据标注过程的自动化,包括自动化标注工具的开发与应用,以及如何将人工标注员的专业知识与自动化技术有机结合,形成高效、协同的标注工作模式。
标注实践指南制定
包括人工标注的详细操作指南,明确标注的具体规则、标准和流程,以及自动化标注工作流程的设计原则和优化策略,确保标注工作的规范性和一致性。
标注可靠性保障措施
着重研究如何评估和提升人工标注的可靠性和一致性,通过制定严格的质量控制标准、实施交叉验证机制以及利用统计学方法进行可靠性分析等手段,确保标注结果的准确性和稳定性。
数据标准化规范
针对不同来源、采用不同协议和数据格式采集的语音数据,研究制定统一的标准化规范,包括数据格式的转换、标注内容的统一编码以及元数据的标准化描述等,以实现数据的无缝整合和共享。
隐私与法律问题应对
深入探讨在语音数据采集、处理和共享过程中,如何应对隐私保护、数据保密以及法律合规性等方面的挑战,包括制定合理的隐私政策、签订严格的保密协议以及确保数据处理活动符合相关法律法规的要求。
知识共享与经验交流
鉴于部分数据集受隐私限制无法直接共享,鼓励研究人员分享在数据采集和标注过程中的实践经验、技术方法以及所遇到的问题和解决方案,通过这种间接的知识共享方式,促进整个领域的技术进步和经验积累。
合成数据的有效利用
研究如何利用合成语音数据来扩充现有的数据集,包括合成数据的生成方法、质量评估标准以及在实际应用中与真实数据的融合策略,以解决数据稀缺性问题,提高模型的泛化能力和适应性。
具体可见:https://sites.google.com/view/speech-data-cca-is25/
提交指南
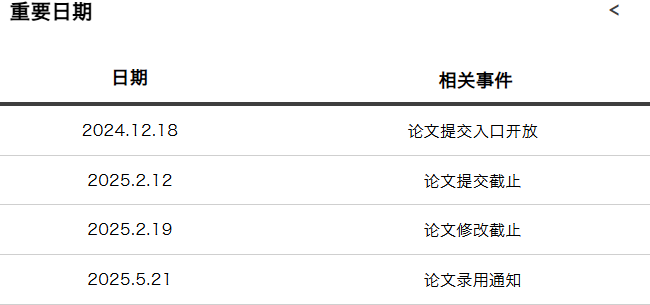
论文提交需严格遵循INTERSPEECH 2025官方网站所发布的标准论文提交指南。在提交论文时,请务必选择“语音数据采集、整理与标注的挑战”作为论文的主题领域,以便于稿件的分类和评审管理。
组织者
Mengyue Wu, Shanghai Jiao Tong University
(mengyuewu@sjtu.edu.cn)
Beena Ahmed, University of New South Wales
Mostafa Shahin, University of New South Wales
Tünde Szalay, Macquarie University
Tan Lee, Chinese University Hong Kong
Mark Liberman, University of Pennsylvania
Thomas Schaaf, Solventum
Ahmed Ali, Saudi Data and Artificial Intelligence Authority
Carlos Busso, Carnegie Mellon University