
听觉是人类感知周围环境并获取信息的重要方式。作为音频场景分类与事件检测领域的知名平台,DCASE 挑战赛到 2026 年已经走过了 13 个年头。今年,随着音频理解大模型的不断进步,来自香港中文大学、蚂蚁集团、罗切斯特大学、上海交通大学、萨里大学和伦敦国王学院的研究者共同举办了 DCASE 2026 挑战赛Task 5:音频依赖型问答(Audio-Dependent Question Answering, ADQA),比赛将于4月1日开始,诚邀各位参加。
- DCASE 2026 主页:https://dcase.community/challenge2026/
- DCASE 2026 Slack群聊:https://join.slack.com/t/dcase/shared_invite/zt-12zfa5kw0-dD41gVaPU3EZTCAw1mHTCA
- 训练集:https://huggingface.co/datasets/Harland/AudioMCQ-StrongAC-GeminiCoT
- 相关文章:https://arxiv.org/abs/2509.21060
- 联系方式1:harlandzzc@link.cuhk.edu.hk
- 联系方式2:sunrenhe.srh@antgroup.com
为什么要提出 ADQA?
当前的音频-语言大模型(LALMs)在评估中面临着严重的“文本幻觉”问题。许多模型在缺乏真正音频感知的情况下,仅靠文本提示就能生成看似合理的答案。数据表明,在部分音频理解选择题Benchmark中,即使用静音替换真实的音频输入,最先进的模型在测试集上的准确率也远超随机猜测,部分甚至可以超过50%。ADQA建立了一个严格的评估体系,通过过滤掉音频依赖性较弱的样本,迫使模型必须真正理解音频内容才能取得成功。
任务核心定义
ADQA任务要求系统必须基于提供的音频片段来回答多项选择题。在测试集的选择题设计中,研究者使用Audio-Dependency Filtering(ADF)尽可能排除了模型通过纯文本线索或先验知识进行推理和幻觉作答的可能性。理解音频信号是得出正确选项的唯一可靠途径。
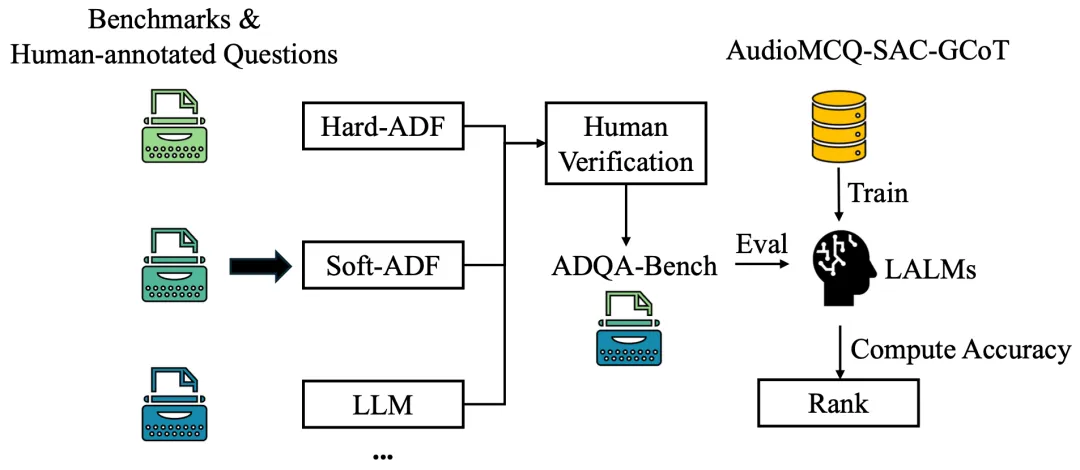
图1:Benchmark构造、训练和评估流程
训练集
本次挑战赛的训练集在包含超过 57 万个样本的 AudioMCQ 数据集[1]基础上进行了精细的裁减和优化。全新的AudioMCQ-StrongAC-GeminiCoT训练集包含 19480条经过高度筛选的样本,基于AudioMCQ的Strong Audio-Contribution Split构造,引入了来自 Gemini 3.1 Pro的原生思维链(提炼后)。这些基于清晰音频感知的推理标注不仅能作为监督信号来训练音频理解模型,还为小模型的思维链蒸馏提供了极大的价值。
评估方法与标准
主要评估指标为模型在研究者提出的多项选择评估集ADQA-Bench上的准确率。ADQA-Bench的构建经过极其严格的流程,包括人工数据标注、使用多种 LALMs 进行静音替换的硬过滤、基于困惑度的软过滤、使用 LLM 排除常识捷径,以及最终的人工验证。通过这套流程,将确保留下来的问题需要聆听音频才能正确作答。
赛事时间表
| 2026.4.1 | 发布训练集、开发集和基线系统 |
| 2026.6.1 | 发布评估集 |
| 2026.6.15 | 系统提交截止 |
| 2026.6.30 | 发布评估结果与挑战赛总结 |
组织委员会
本次挑战赛由全球多所高校与科技企业的专家联合发起,包括香港中文大学(DSP LAB)、蚂蚁集团(AI身份智能团队)、罗切斯特大学(AIR LAB)、上海交通大学(X-LANCE LAB)、萨里大学和伦敦国王学院。DCASE Task 5组织委员会诚邀音频信号处理专家与多模态大模型领域的前沿探索者,通过共同参与,深入探索音频理解大模型的真实边界。
[1] H. He et al., “Measuring Audio’s Impact on Correctness: Audio-Contribution-Aware Post-Training of Large Audio Language Models,” in Proc. Int. Conf. Learn. Represent. (ICLR), 2026.
[2] Y. Zang et al., “Are you really listening? Boosting Perceptual Awareness in Music-QA Benchmarks,” in ISMIR 2025 Hybrid Conference, 2025.
[3] J. Wang et al., “Pay More Attention To Audio: Mitigating Imbalance of Cross-Modal Attention in Large Audio Language Models,” arXiv preprint arXiv:2509.18816 (2025).