由CCF语音对话与听觉专委会组织的CNCC技术论坛【多模态大模型给语音音频技术带来哪些机遇与挑战?】将于10月24日在浙江省东阳市横店圆明新园举办。
多模态大模型给语音音频技术带来哪些机遇与挑战?
举办时间:10月24日13:30-17:30
地点:秋苑-澄心堂
注:如有变动,请以官网(https://ccf.org.cn/cncc2024)最终信息为准
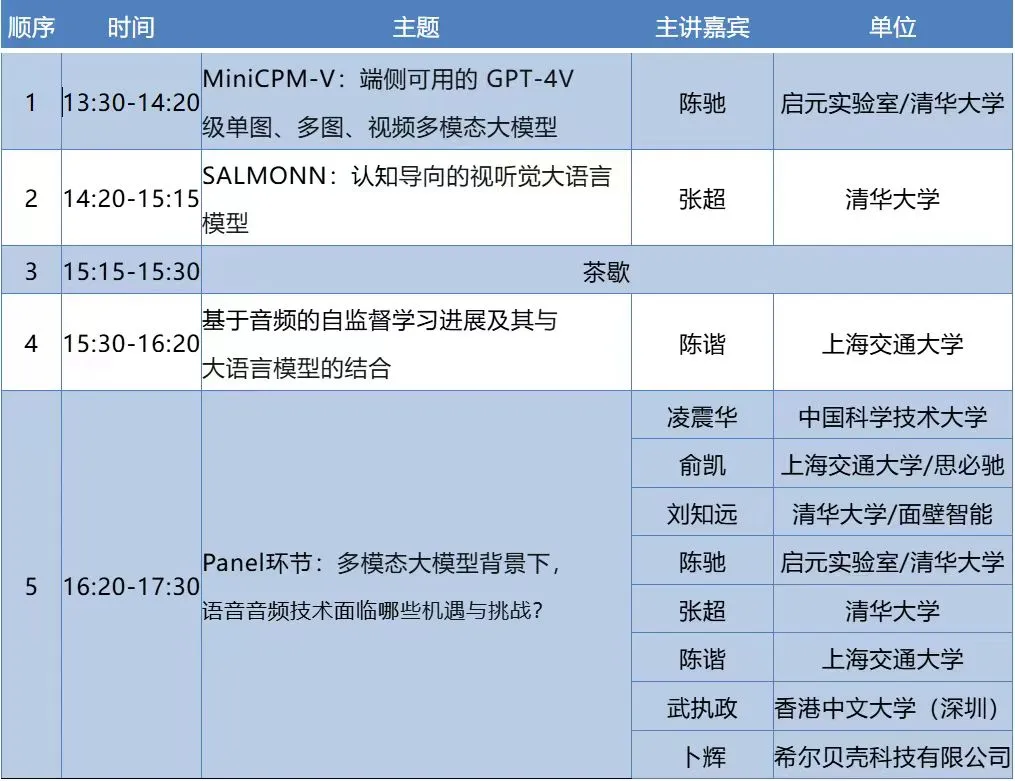
论坛安排
论坛嘉宾介绍
论坛主席
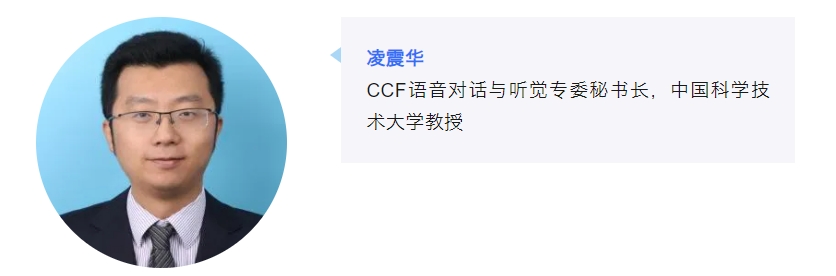
中国科学技术大学信息学院教授,语音及语言信息处理国家工程研究中心副主任,入选教育部CJ学者校企联聘学者,主要从事语音信号处理、自然语言处理等方向的研究。
论坛共同主席
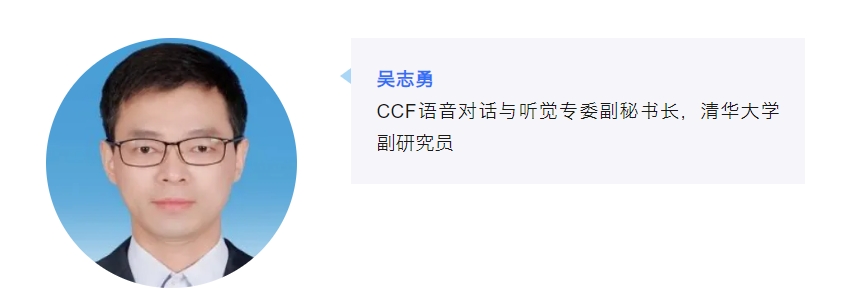
清华大学深圳国际研究生院副研究员。研究兴趣为智能语音交互技术,曾获教育部、北京市、深圳市科技进步等奖励。获深圳市教学成果奖、清华大学良师益友荣誉称号、CCF语音对话与听觉专委卓越服务者奖励。
论坛讲者
论坛讲者
主要研究多模态大模型与自然语言处理,在ACL、EMNLP等顶级会议发表多篇论文,多个顶级期刊和会议审稿人。参与国家重点研发计划和新一代人工智能重大项目。
报告题目:MiniCPM-V:端侧可用的GPT-4V级单图、多图、视频多模态大模型
报告摘要:多模态大模型迅速发展,成为人工智能领域研究热点,但其实用化仍面临诸多挑战。本报告介绍首个单图、多图与视频理解性能达GPT-4V级的端侧模型系列MiniCPM-V。通过统一视觉编码框架实现同时支持单图理解、多图联合理解、多图ICL及实时视频理解等功能,并具有领先的OCR能力、可信多模态行为及多语言支持等特性。模型具有更高知识密度,实现端侧设备上轻量化运行与高性能表现,展现了多模态大模型的实用化前景。
研究方向为多模态语音语言处理技术和计算认知神经科学。曾任剑桥大学副研究员、京东语音联合负责人、谷歌高级研究科学家等职务。入选国家高层次人才计划青年项目。
报告题目:SALMONN:认知导向的视听觉大语言模型
报告摘要:文本大语言模型(LLM)的一个关键缺陷在于其语言认知与物理世界的多模态信息几乎无关。本报告介绍首个通用听觉大语言模型SALMONN。通过将LLM直接与音频和语音编码器连接,实现对语音、音频事件、音乐、声源方位等听觉元素的通用感知和理解,具备语音指令、多语言、跨模态推理等高级能力。还通过视觉编码器及多时空精度因果Q-Former结构,实现认知导向的音视频感知,是第一个能“看”短视频的多模态大模型。
上海交通大学计算机系副教授,博导,获国家海外高层次人才青年项目。博士毕业于剑桥大学,先后在剑桥从事博士后研究、美国微软研究院任高级和资深研究员,主要研究方向为智能语音信号处理,发表论文90余篇。
报告题目:基于音频的自监督学习进展及其与大语言模型的结合
报告摘要:近年来,自监督学习在音频信号处理领域取得显著进展,展示了从海量无标签音频数据中学习潜在结构信息的强大能力。报告将介绍音频、情感语音和音乐数据自监督学习的最新进展。通过引入语句和帧级别联合学习,在音频分类、语音情感识别和音乐理解方面取得显著提升。进而将语音表征学习模型与大语言模型结合,扩展其在语音识别和空间音频理解等方面的多模态能力。研究表明,强大的音频表征模型即使通过简单结合,也能达到优异性能。
Panel嘉宾