2022年11月8日,由语音之家打造的AI语音技术相关的前沿论文成果分享平台—SH SSS(SH Symposium Series on Speech)第六期成功举办。本期是由何茂奎进行论文解读:《端到端音视频说话人日志网络》。

下面是本次论文解读的回顾:

VIDEO
POSTER


概述
Abstract
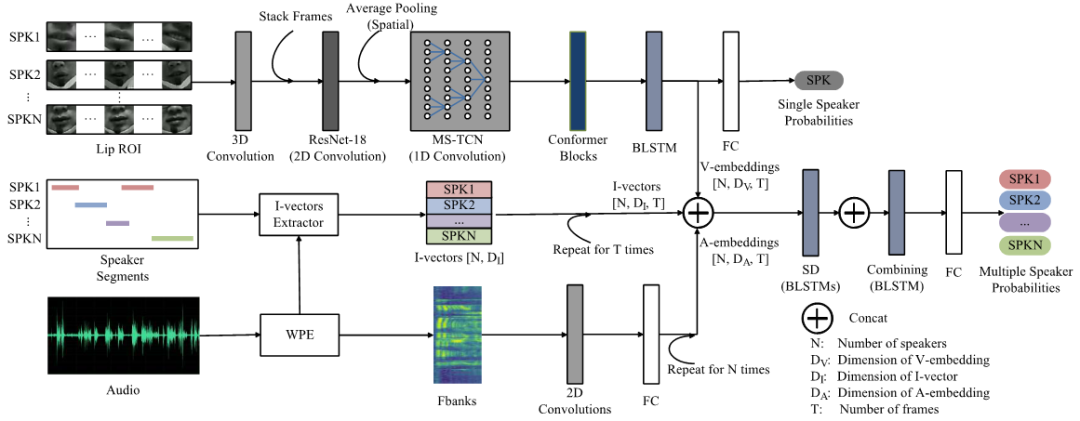
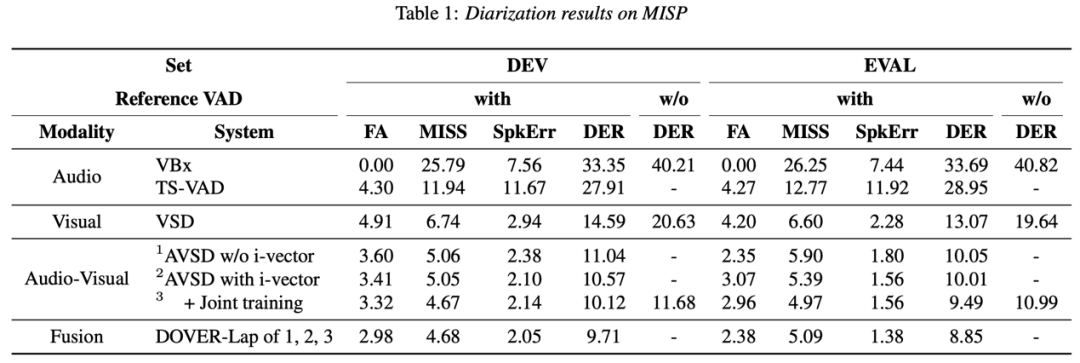
本文提出了一种基于端到端神经网络的音视频说话人日志方法。该音视频模型采用音频特征(例如 FBANK)、多说话人唇型(ROI)和多说话人 i-vector向量作为多模态输入。同时输出多个说话人的帧级语音/非语音概率。通过精心设计的端到端结构,所提出的方法可以很好处理重叠语音问题,并通过多模态信息准确地区分语音和非语音。i-vector是解决由视觉模态错误(例如唇部遮挡或检测不可靠)引起的音视频同步问题的关键点。该音视频模型对视觉模态缺失同样具有鲁棒性。我们在MISP数据集上进行了评估,所提出的方法在的开发/测试集上实现了10.1%/9.5%的分类错误率 (DER),而纯音频和纯视频系统的 DER 分别为27.9%/29.0%和14.6%/13.1%。

题 目 Tittle

中文:端到端音视频说话人日志网络

英文:End-to-End Audio-Visual Neural Speaker Diarization


收录会议 Source Title:INTERSPEECH 2022

作 者 Authors:何茂奎,杜俊,李锦辉

论文地址 Url:https://www.isca-speech.org/archive/pdfs/interspeech_2022/he22c_interspeech.pdf

论文代码 Code:https://mispchallenge.github.io/mispchallenge2022


研究方法 & 模型介绍

Methods & Data analysis

网络输入分为三部分。首先音频特征输入为Fbanks特征,由经过去混响(WPE)的音频提取,通过卷积神经网络(CNN)特取得到帧级音频特征;视频输入为当前所有人的唇部ROI,依次经过Lip reading网络,Conformer模块,BLSTM,最后通过全连接层来预测每个说话人帧级语音/非语音概率,由此构成一个纯视频的VAD网络,将BLSTM帧级输出(256维)作为视频端的特征;由于唇部输入由于遮挡,未面对摄像头或人完全未出现在视频中存在丢失,这样视频提供的信息将不准确,这将导致输出排列混乱,所以说话人编码特征(本文使用i-vector)将做为辅助信息来控制输出节点的说话人顺序。


实验结果

Results

该论文主要在MISP2021数据集上进行了实验评测。

文中对比了纯音频,纯视频(本文使用的视频特征支路),音视频的结果。可以看到在这样一个高语音重叠率环境中,纯音频的方法表现的很差,而利用高质量的视频输入,经过视频VAD网络就能超过纯音频的结果。虽然唇部运动和语音活动性高度相关,但是同样存在一些唇部发生运动但人并未说话或唇部并未运动但人在发声的情况,所以纯视频方法存在一定瓶颈。本文提出的音频视频网络达到了最好的结果。

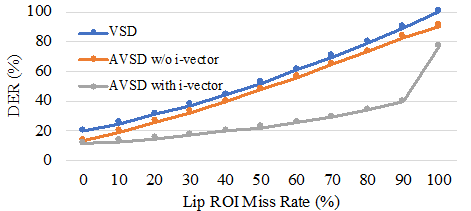
MISP2021数据中的人通常是面对摄像头,这样几乎在所有帧上都能检测到唇部,通过人为设置唇部帧丢失的比率,我们可以模拟视频部分缺失的情况。下图中我们对比了纯视频方法(VSD),不带说话人编码特征的音视频网络(AVSD w/o i-vector),及带说话人编码特征的音视频网络(AVSD with i-vector)。通过对比可以看到当唇部丢失比率上升时,没有i-vector的网络和VSD趋势一样DER显著上升,而带i-vector的网络依然具有很强的鲁棒性。