INTERSPEECH 2023 论文预讲会是由CCF语音对话与听觉专委会、语音之家主办,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 INTERSPEECH 2023 录用论文的作者进行报告交流。
INTERSPEECH 2023 论文预讲会邀请到
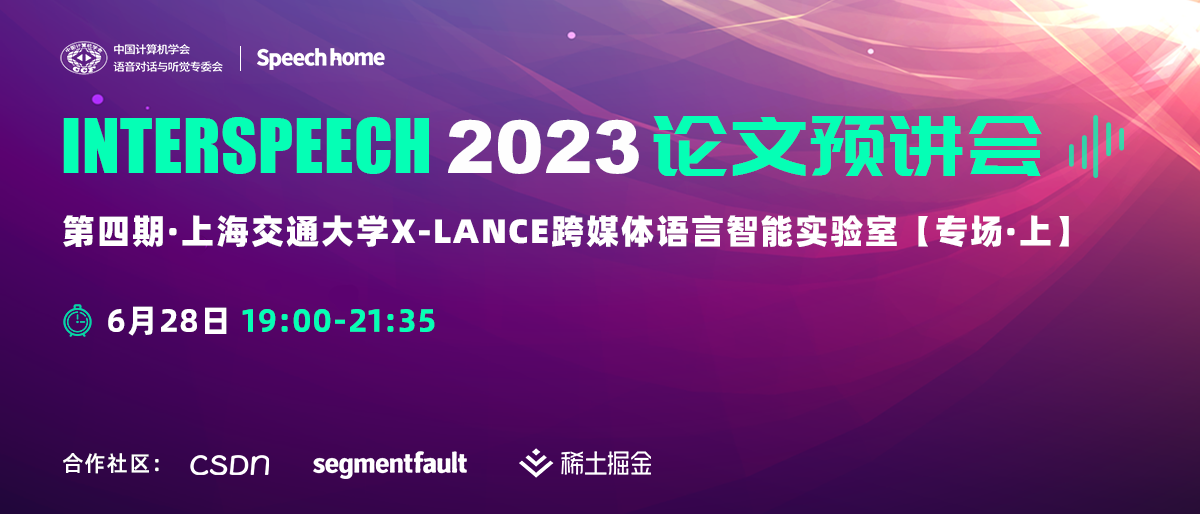
上海交通大学X-LANCE跨媒体语言智能实验室 在6月28日、7月5日分别做两期专场分享,欢迎大家预约观看。
下面是预讲会的回顾
钱彦旻
钱彦旻教授在本次报告中对上海交通大学X-LANCE跨媒体语言智能实验室近期工作进行了介绍。
王巍
论文题目:UniSplice: Universal Cross-Lingual Data Splicing for Low-Resource ASR
作者:Wei Wang and Yanmin Qian
摘要:我们关注语音识别(ASR)领域中低资源语言的数据稀缺问题,并提出了一种全新的跨语言语音合成框架UniSplice。该框架利用HuBERT的离散语音表示作为通用发音单位,应用数据拼接技术,将富资源语言的语音片段合成为低资源语言的训练数据。相比于基于神经网络的合成方法,UniSplice的训练和推理开销极低,可以在在线生成的拼接语音上训练ASR模型。我们在CommonVoice数据集,10小时低资源的实验设置下,应用UniSplice合成的语音进行模型微调,得到显著的识别性能提升。论文题目:Extremely Low Bit Quantization for Mobile Speaker Verification Systems Under 1MB Memory作者:Bei Liu, Haoyu Wang and Yanmin Qian摘要:如何开发为移动设备定制的轻量级系统是说话人验证任务中一个紧迫而有趣的话题。在本文中,我们研究了用于小型化说话人验证系统的极低比特量化。具体来说,我们提出了两种不同的二值量化方案,即静态量化器和自适应量化器。通过将它们应用于预训练的全精度 ResNet模型,我们成功获得了名为 b-vector的二值化模型,其模型大小小于 1MB 内存。Voxceleb 数据集上的实验表明,与之前最好的小型化说话人验证系统相比,我们最好的 b-vector 系统在 Vox1-O、E 和 H 上分别实现了 38%、36% 和 30% 的相对性能提升,同时保持几乎相同的模型大小。此外,对二值化权重分布的分析表明,与静态方法相比,自适应量化方案可以更好地匹配全精度权重分布,因此具有更有效的表示能力。陈正阳
论文题目:Attention-based Encoder-Decoder Network for End-to-End Neural Speaker Diarization with Target Speaker Attractor作者:Zhengyang Chen, Bing Han, Shuai Wang and Yanmin Qian摘要:在文章中,我们提出了一个新颖的基于注意力机制的编码器-解码器结构的端到端说话人日志系统。在这个结构中,我们加入了类似于TS-VAD系统中的说话人注册信息,消除了之前端到端系统中的说话人置换问题,加速了收敛。在训练过程中,我们提出了一种teacher-forcing的策略来获取这种说话人注册信息。在测试解码过程中,我们提出了三种启发式的解码策略来获取这个注册信息。另外,与EEND-EDA系统使用LSTM来计算attractor不同,我们使用了注意力机制来进行attractor的计算。通过这些设计,我们的系统可以在只使用0.5s注册语音的情况下性能超过EEND-EDA和TS-VAD系统。李晨达
论文题目:Adapting Multi-Lingual ASR Models for Handling Multiple Talkers作者:Chenda Li , Yao Qian, Zhuo Chen, Naoyuki Kanda, Dongmei Wang, Takuya Yoshioka, Yanmin Qian, and Michael Zeng摘要:最近,大规模通用语音模型在多个领域和语言中表现出强大的语音识别 (ASR) 性能。然而,对于这些预训练大模型来说,识别会议对话中经常出现的重叠语音仍然是一个挑战。本工作提出了一种使大规模预训练模型适应多人语音处理 的方法。我们首先设计了序列化输出训练(SOT)的增强版本,用于同时进行多说话人 ASR 和多人话语时间戳预测。提出的模型会同时进行多说话人 ASR ,计算说话人的数量,为每一句话语进行时间戳预测。本工作还进一步引入了一个轻量级适配器模块,即使在仅使用一种语言微调,也能保持大模型原本的多语言属性。在 AMI 和 AliMeeting 语料库上的实验结果表明,提出的方法可以有效地将预训练大模型迁移到多人语音处理任务上。论文题目:Weakly-Supervised Speech Pre-training: A Case Study on Target Speech Recognition作者:Wangyou Zhang and Yanmin Qian摘要:基于自监督学习(SSL)的语音预训练因其能够从大量无标签数据中提取丰富的表征而备受关注。另一方面,弱监督数据在语音预训练中的使用却较少被探索。为了填补这一空白,我们提出了一种基于说话人已知的语音数据的弱监督语音预训练方法。它采用了与基于掩蔽语音预测的 SSL 框架类似的训练过程,同时加入了额外的目标说话人注册信息作为辅助输入。通过这种方式,即使在存在高度重叠语音干扰的情况下,学习到的表征也会集中于目标说话人,从而可以直接应用于目标说话人语音识别等下游任务。我们在 Libri2Mix 和 WSJ0-2mix 数据集上的初步实验表明,与具有去噪能力的最先进的 SSL 模型 WavLM(同参数量级)相比,提出的模型取得了更好的识别性能。
INTERSPEECH 2023 论文预讲会面向全球线上招募,结合定向邀请与自选投稿的方式,来选择预讲会的嘉宾。
为了共创高质量的论文预讲会,我们诚挚邀请所有 INTERSPEECH 2023 作者参与到会议中来,也欢迎大家推荐适此会议论文分享的学者。
投稿方式
投稿邮箱:jack@speechhome.com
联系人微信