ICASSP 2024 论文预讲会由CCF语音对话与听觉专委会、语音之家主办,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 ICASSP 2024 录用论文的作者进行报告交流。
ICASSP 2024 论文预讲会第六期邀请到昆山杜克大学做本次会议的专场分享,欢迎大家观看。
实验室概况
昆山杜克大学是一所非营利性的中美合作办学机构,由美国杜克大学和中国武汉大学联合在中国江苏省昆山市创办,旨在开创世界一流的研究型综合性大学,为来自中国及全球的学生提供多样化的学术项目。语音及多模态智能信息处理实验室,Speech and Multimodal Intelligent Information Processing (SMIIP) Lab, 隶属于大数据研究中心,PI为李明老师,目前共3个研究方向,分别为智能语音处理、多模态行为信号分析、病理语音分析。
昆昆山杜克大学(二)【专场】
时间:3月10日(周日)10:00 ~ 11:40
形式:线上
议程:每位嘉宾分享25分钟(含5分钟QA)
昆山杜克大学(一)【专场】
时间:3月12日(周二)19:00 ~ 20:40
形式:线上
议程:每位嘉宾分享25分钟(含5分钟QA)
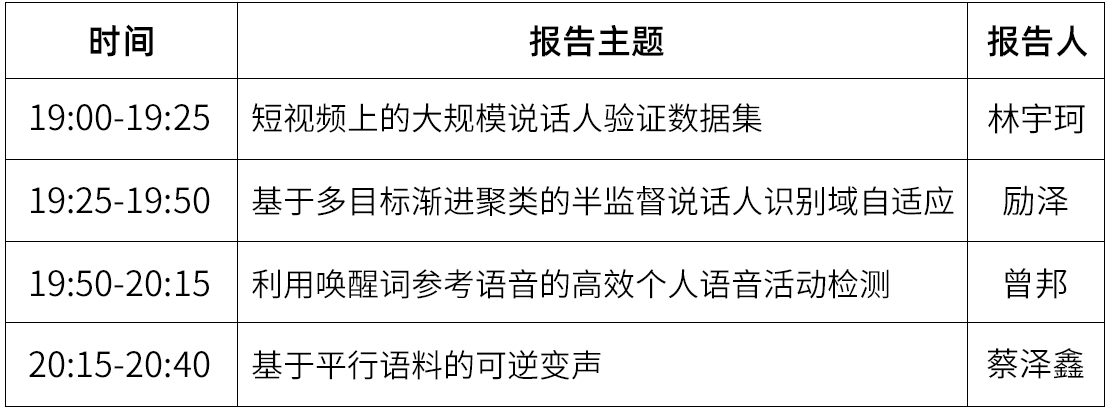
嘉宾&主题
分享主题:短视频上的大规模说话人验证数据集
摘要:本文构建了一个大规模的音视频说话人识别数据集,名为VoxBlink。首先提出了一种全新的鲁棒性音视频自动挖掘的解决方案用于构建基于短视频的大规模说话人识别数据集,最终版本包含了3.8万说话人的145万语音片段。由于自动化数据处理的解决方案不可避免引入噪声数据,因此本文通过多模态提纯方法在原数据集基础上获得了一个标签干净的子集,名为VoxBlink-clean。该子集包含1.8万个说话人和102万个语音片段。相较于VoxCeleb,VoxBlink的数据来源于普通用户的短视频,覆盖的场景更能与现实世界情境相符,可扩展性也更强。据我们所知,VoxBlink数据集是目前公开可用的最大的说话人识别数据集之一。通过将VoxCeleb2与VoxBlink-clean训练数据集结合在一起,我们验证了不同结构的说话人识别模型,对VoxCeleb1测试集进行了全面的评估。实验结果表明,在不同的骨干网络上,通过整合了VoxBlink-clean到训练集中,模型性能得到了显著提升,相对提升幅度在12%~30%之间。
摘要:当前,通过基于聚类算法给大规模无标签数据打上伪标签的方法在半监督说话人识别域自适应任务中表现出举重若轻的作用。在本文中,我们提出了一种专为半监督域自适应设计的新型伪标签方法——多目标渐进聚类(MoPC)。首先,我们基于多个不同的目标(图内去噪,类内去噪和类间去噪)从目标域的少量带标签数据中获取相应度量值。随后,我们采用Infomap算法对无标签目标域数据进行聚类,并利用提取的度量值对聚类结果进一步优化。此外,为进一步提高伪标签的质量,我们引入了子中心提纯和渐进合并策略。我们提出的MoPC方法在VoxSRC2023第三赛道的评估集上取得了4.95% EER的成绩,排名第一。另外,我们还在FFSVC数据集上进行了相关实验,并验证了我们方法的泛化性。
论文链接:https://sites.duke.edu/dkusmiip/files/2024/03/icassp24_lize.pdf
嘉宾简介:曾邦,武汉大学计算机科学与技术专业博士生,昆山杜克大学语音及多模态智能信息处理实验室研究实习生, 主要研究方向为特定人语音分离、特定人语音活动监测。
分享主题1:利用唤醒词参考语音的高效个人语音活动检测
摘要:传统的PVAD方案通过预训练的说话者识别模型从现有的注册语音中提取目标说话者人的声纹嵌入。当提取的目标说话人嵌入质量较差时,例如仅使用唤醒词语音作为参考,PVAD模型的性能可能会受到影响。在本工作中,我们引入了一种新颖而高效的PVAD模型。与传统方法中从预训练的说话者识别模型中提取的目标说话人嵌入不同,我们提出的方法直接使用注册语音的原始帧级特征作为目标说话人的辅助特征。通过这种方式,我们提出的模型实现了极高的召回率,这对语音助手应用至关重要。实验结果显示了我们提出的方法在使用现有查询语音或唤醒词语音作为参考的两种情况下的有效性。
论文链接:https://sites.duke.edu/dkusmiip/files/2024/03/icassp24_zengbang.pdf
嘉宾简介:蔡泽鑫,约翰霍普金斯大学CLSP (Center for Language and Speech Processing) 博士后研究员,在杜克大学获得电气与计算机工程博士学位(由昆山杜克大学李明老师联合指导),研究兴趣包括文本到语音合成、声音转换和音频深度伪造检测等。
分享主题2:基于平行语料的可逆变声
摘要:本文介绍了一种用于声音转换的创新深度学习框架,以减轻这类系统相关的固有风险,提高声音转换的安全性和可靠性。我们的方法侧重于开发一种能够对抗变声用于欺骗威胁的可逆模型。我们具体提出了一个允许检索源声音的转换模型,从而便于识别源说话者。该框架使用一系列由仿射耦合层组成的可逆模块以确保转换过程的可逆性。我们使用平行变声训练数据对所提出的框架进行了全面的训练和评估。我们的实验结果显示,这种方法在声音转换任务中达到了与不可逆系统相当的性能。值得注意的是,转换后的输出可以使用在前向过程中使用的相同参数无缝地还原为原始源输入。
直播将通过语音之家微信视频号进行直播
扫码添加语音小管家,进入语音之家讨论群
为了共创高质量的论文预讲会,我们诚挚邀请所有 ICASSP 2024 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。
联系人邮箱
bd@speechhome.com
联系人微信