ICASSP 2024 论文预讲会由CCF语音对话与听觉专委会、语音之家主办,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 ICASSP 2024 录用论文的作者进行报告交流。
ICASSP 2024 论文预讲会第十期邀请到上海交通大学X-LANCE跨媒体语言智能实验室做本次会议的专场分享,欢迎大家观看。
实验室概况
上海交通大学跨媒体语言智能实验室(SJTU Cross Media Language Intelligence Lab, X-LANCE)成立于2012年,前身是“智能语音实验室”(SpeechLab),经过多年发展,成为了涵盖视听文语言信息处理核心各研究领域的“跨模态语言智能实验室”。目前,跨媒体语言智能实验室的教师组有一位教授,四位副教授/副研究员和一位科研助理,拥有十九名博士研究生,三十六名硕士研究生,还包括ACM班、AI班、IEEE班、电院CS等专业、密西根学院、中法学院等的三十余名本科生。实验室获得了包括国家重点研发计划、自然科学基金委优秀青年科学基金在内的诸多国家和企业项目支持。实验室与思必驰科技股份有限公司深度合作,成立了“上海交通大学思必驰智能人机交互联合实验室”。实验室可调动丰富的数据资源以及多达数百块GPU卡的丰富计算资源,是国际上极少数可以进行产业级大尺度数据分析和研究的人工智能实验室之一。
第十期
上海交通大学X-LANCE跨媒体语言智能实验室【专场】
时间:3月18日(周一)19:00 ~ 20:40
形式:线上
议程:每位嘉宾分享20分钟(含5分钟QA)
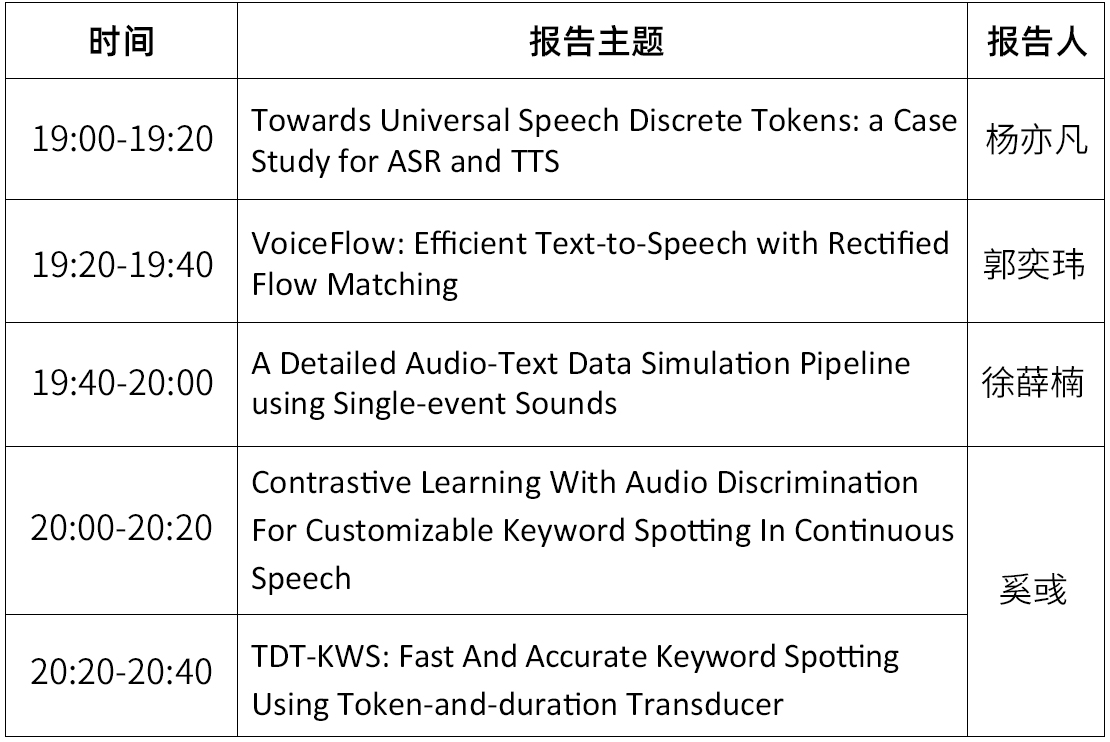
嘉宾&主题
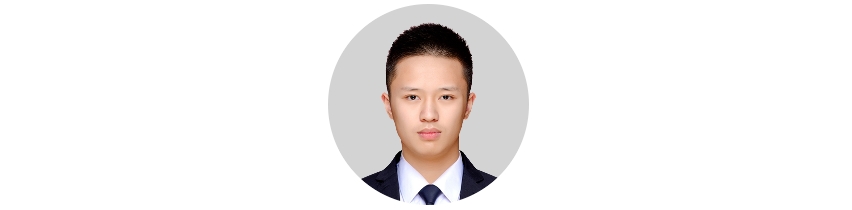
嘉宾简介:杨亦凡,上海交通大学X-LANCE跨媒体语言智能实验室一年级博士生,主要研究方向为语音识别。曾在INTERSPEECH等语音领域会议合作发表文章。分享主题:Towards Universal Speech Discrete Tokens: a Case Study for ASR and TTS
摘要:自监督学习(SSL)在语音处理领域的进展促进了利用离散标记进行语音识别和翻译等任务的研究兴趣。这些任务通过降低存储需求同时借助自然语言处理技术,展现了其潜在的优势。尽管如此,这些研究大多关注单一任务,面临过拟合或性能下降的问题,在多任务场景中出现性能损失。本研究针对几种领先的SSL模型生成的离散特征,在语音识别和合成任务中进行了全面的比较与优化。我们探讨了这些离散特征在不同语音任务上的通用适应性。实验结果表明,在语音识别任务中,离散特征与基于FBank特征的系统性能相当,而在语音合成方面,其在主观和客观评估中均优于梅尔频谱特征。这些发现表明了通用离散特征在语音相关任务中的巨大应用潜力。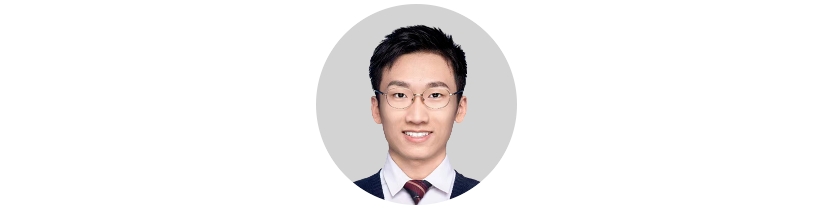
嘉宾简介:郭奕玮,上海交通大学X-LANCE跨媒体语言智能实验室一年级博士生,主要研究方向为语音合成。在ICASSP上已一作发表数篇论文,也在组内于AAAI、Interspeech等会议参与发表了工作。分享主题:VoiceFlow: Efficient Text-to-Speech with Rectified Flow Matching摘要:尽管基于扩散去噪模型的语音合成已经展现了强大的生成能力,从扩散模型中采样本身是一个复杂的迭代过程,这降低了合成的效率。在这篇论文中,我们提出VoiceFlow,一个基于整流匹配(rectified flow matching)的语音合成声学模型,来在极有限的采样步数下即实现高质量的语音合成。VoiceFlow把生成梅尔谱的过程视为从一个以文本为条件的常微分方程中采样,这一常微分方程对应的向量场由神经网络来估计。随后整流匹配的算法有效地将采样轨迹进行笔直化,从而降低了必要的采样步数。我们在单说话人和多说话人的数据集上同时进行了实验,用主观和客观的指标展现VoiceFlow能高效地生成比对应扩散模型更高质量的音频。同时,我们也进行了消融实验来证明VoiceFlow中整流匹配技巧的有效性。嘉宾简介:徐薛楠,上海交通大学X-LANCE跨媒体语言智能实验室三年级博士生。研究方向为声音-文本多模态学习。曾在Interspeech,ICASSP,TASLP等会议和期刊上发表音频描述、生成和音-文预训练的一系列工作。分享主题:A Detailed Audio-Text Data Simulation Pipeline using Single-event Sounds摘要:近期,音频-文本跨模态学习受到了越来越多的关注。然而,大多数现有的音频-文本数据集仅包含对声音事件的简单描述。与分类标签相比,这样的描述的优势明显有限。在本文中,我们首先分析了人类对音频描述可能包含的、超出声音事件标签的详细信息。基于此分析,我们提出了一个自动化的数据模拟方法,用于生成包含丰富细节的音频-文本对模拟数据。利用声音可以在时间域上混合和拼接的特性,我们在混合音频时控制四个方面的细节:时序关系、响度、说话人身份和发生次数,相应的细节通过大语言模型转换成自然语言文本描述,从而获得了文本描述中包含丰富细节的音频-文本对。我们通过少量模拟数据验证了我们提出的流程的有效性,证明了模拟数据使模型能够学习生成包含细节的音频描述。嘉宾简介:奚彧,上海交通大学X-LANCE跨媒体语言智能实验室四年级博士生。研究方向为语音识别和关键词检测。曾在ICASSP等会议发表论文。分享主题1:Contrastive Learning With Audio Discrimination For Customizable Keyword Spotting In Continuous Speech摘要1:连续语音中的可定制关键词检测因其在现实世界中的应用潜力而受到越来越多的关注。虽然对比学习已被广泛用于提取关键词表征,但以往的对比学习方法都是对预先分割的孤立词进行操作,并且只采用音频-文本表征匹配策略。然而,对于连续语音中的关检测监测,共同发音和流式单词分割很容易产生不同文本的相似音频模式,从而引发误报。为了解决这个问题,我们提出了一种新颖的带音频辨别的对比学习策略,用于学习具有音频-文本匹配和音频-音频辨别能力的关键词表示。在此,我们在训练过程中的每个滑动窗口都采用了 InfoNCE 损失,该损失同时考虑了音频-音频和音频-文本的数据对。我们在开源 LibriPhrase 数据集上进行的评估表明,与之前的方法相比,使用滑动窗口级别的 InfoNCE 损失可获得相当的性能。此外,在连续语音数据集 LibriSpeech 上进行的实验表明,通过结合音频的区分性,提出的CLAD 比没有音频判别的 CL 性能有显著提高。同时,与两阶段语音唤醒方法相比,采用 CLAD 的端到端唤醒系统不仅性能更好,而且推理速度也显著提高。分享主题2:TDT-KWS: Fast And Accurate Keyword Spotting Using Token-and-duration Transducer摘要2:设计一种能在资源受限的边缘设备上提供卓越性能的高效关键词检测系统(KWS)一直是备受关注的课题。现有的 KWS 搜索算法通常采用帧同步方法,尽管大多数帧都与关键字无关,但每一帧都会重复做出搜索决策。在本文中,我们提出了 TDT-KWS,它利用标记和持续时间转换器(TDT)来完成 KWS 任务。我们还为基于转换器(Transducer)的模型提出了一种新颖的 KWS 任务特定解码算法,该算法支持在流式语音场景中进行高效的帧异步关键词搜索。通过在公开的 Hey Snips 数据集和自建的 LibriKWS-20 数据集上进行评估,我们提出的 KWS 解码算法比传统的 ASR 解码算法产生了更准确的结果。此外,与 RNN-T 和传统的 TDT-ASR 系统相比,TDT-KWS 的唤醒词检测性能相当或更好,同时推理速度明显加快。此外,实验表明,与 RNN-T KWS 相比,TDT-KWS 对嘈杂环境具有更强的鲁棒性。
直播将通过语音之家微信视频号进行直播
扫码添加语音小管家,进入语音之家讨论群
ICASSP 2024 论文预讲会面向全球线上招募,结合定向邀请与征集报名的方式,来选择预讲会的嘉宾。

为了共创高质量的论文预讲会,我们诚挚邀请所有 ICASSP 2024 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。
联系人邮箱
bd@speechhome.com
联系人微信