ICASSP 2024 论文预讲会由CCF语音对话与听觉专委会、语音之家主办,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 ICASSP 2024 录用论文的作者进行报告交流。
第十七期
清华大学深圳国际研究生院(一)【专场】
时间:3月26日(周二)19:00 ~ 21:05
形式:线上
议程:每位嘉宾分享25分钟(含5分钟QA)
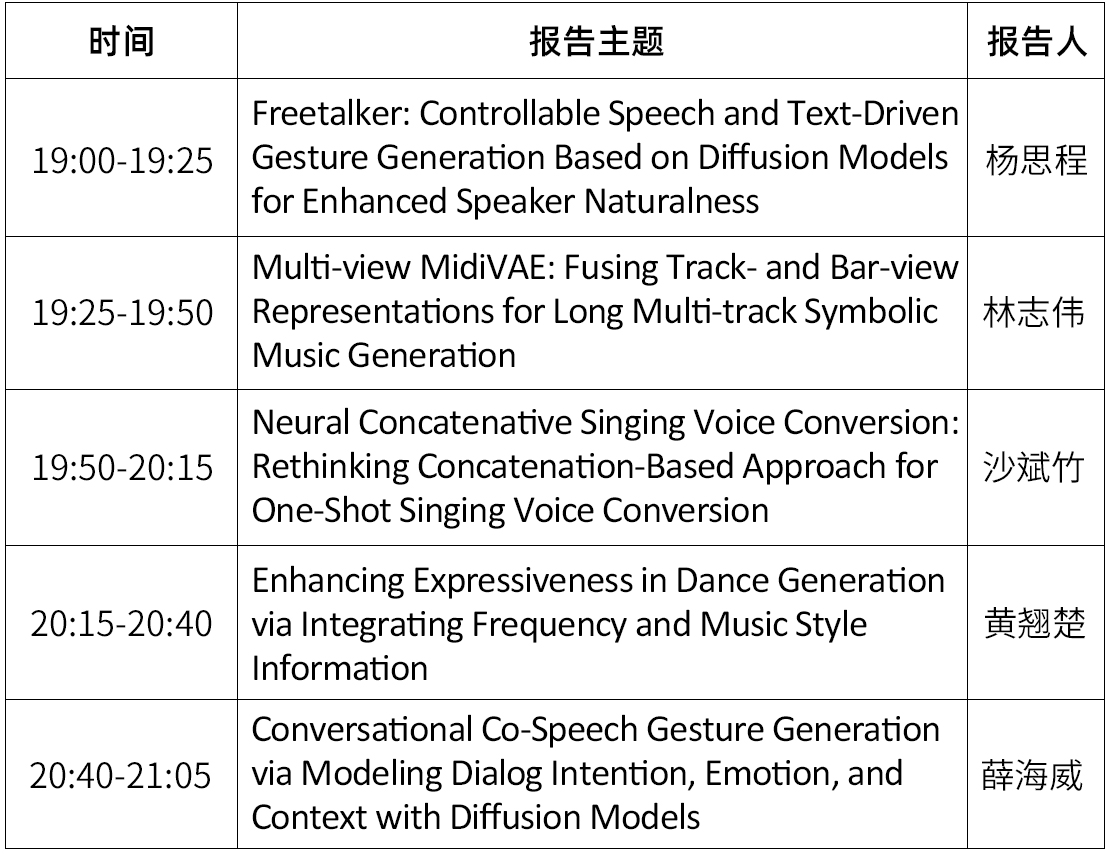
嘉宾&主题
嘉宾简介:杨思程,清华大学深圳国际研究院电子信息(人工智能)专业三年级硕士。研究方向是基于多模态表征学习的语音文本驱动数字人动作生成研究。相关工作发表于ICASSP,CVPR,IJCAI, ICMI,ACM MM上。
分享主题:Freetalker: Controllable Speech and Text-Driven Gesture Generation Based on Diffusion Models for Enhanced Speaker Naturalness
摘要:目前语音驱动虚拟数字人大多根据语音和文本生成共语手势,而不考虑说话者的非说话动作。此外,以往的共语手势生成工作都是基于单个手势数据集来设计网络结构的,这导致了数据量有限、通用性受损以及说话者动作受限等问题。为了解决这些问题,我们提出了FreeTalker,据我们所知,这是第一个同时生成自发(如共语手势)和非自发(如在讲台周围移动)发言人动作的框架。具体来说,我们利用来自各种运动数据集的异构数据,训练了一个基于扩散的演讲者运动生成模型,该模型采用了语音驱动手势和文本驱动运动的统一表征。在推理过程中,我们利用无分类器引导来高度控制片段的风格。此外,为了在片段之间创建平滑的过渡,我们采用了DoubleTake,这是一种利用先验生成并确保无缝运动混合的方法。大量实验表明,我们的方法能生成自然、可控的说话者动作。
摘要:变分自编码器(VAEs)是基于神经网络的符号音乐生成技术的重要组成部分,其中一些工作已经有了出色的结果并引起了相当大的关注。然而,以前的 VAE 仍然会遇到特征序列过长的问题,并且生成的结果缺乏上下文连贯性,因此建模长时间多乐器符号音乐的挑战仍然没有得到解决。为此,我们提出了Multi-view MidiVAE,作为VAE方法的先驱之一,该方法可以有效地建模和生成长多音轨符号音乐。模型利用二维表征 OctupleMIDI 来捕获音符之间的关系,同时减少特征序列长度。此外,我们通过使用混合变分编码解码策略来整合乐器视角(Track-view) 和小节视角(Bar-view) MidiVAE 特征,从而让模型专注于乐器特征和乐器间的协调交互、以及音乐的全局和局部信息。在CocoChorales数据集上的客观和主观实验结果表明,与基线相比,我们的方法在建模长多轨符号音乐方面表现出显着的改进。
嘉宾简介:沙斌竹,清华大学深圳国际研究院电子信息(计算机技术)专业二年级硕士。研究方向是单样本的歌声转换。相关工作发表于ICASSP。
该工作目前已经开源:https://github.com/thuhcsi/NeuCoSVC
嘉宾简介:黄翘楚,清华大学深圳国际研究院电子信息(计算机技术)专业二年级硕士。研究方向是音乐驱动舞蹈生成。相关工作发表于ICASSP。
摘要:舞蹈生成作为人类动作生成的一个分支,已引起越来越多的关注。最近,一些工作试图从某些方面增强舞蹈的表现力,其中包括舞种匹配性、舞蹈卡点性和舞蹈动态。然而,由于缺乏对上述三方面因素的综合考虑,其增强效果相当有限。在本文中,我们提出了一种新颖的舞蹈生成方法 ExpressiveBailando,该方法旨在生成富有表现力的舞蹈,同时兼顾上述三个因素。具体来说,我们通过将频率信息纳入 VQ-VAE 来缓解速度平均化问题,从而改善舞蹈的动态效果。此外,我们还整合了音乐风格信息,通过预先训练的音乐模型提取与流派和节拍相关的特征,从而改善了其他两个因素。实验结果表明,我们提出的方法可以生成具有高表现力的舞蹈,并且在主观和客观评价上都优于现有方法。
摘要: 音频驱动的语音协同人体手势(共语手势,co-speech gesture)生成技术近年来取得了显著进展。然而,先前的工作大多数仅关注单人语音驱动的手势生成,很少关注到手势生成除了说话人自身因素外,还会受到对话上下文等多个因素的影响。本文旨在探讨在对话中考虑多个参与者的对话协同语音手势生成的问题,提出一种针对双人语境的语音驱动交互手势生成方法。结合现实对话的状态,通过句子级别的意图感知模块和情感推理模块,初步建模双方的对话意图(Intention)、情感(Emotion)和话语上下文(Context),来进一步提升手势生成的丰富度,并基于扩散概率模型生成稳定、连贯的手势序列,为对话手势动作合成工作生成更加拟人、符合语音、贴近双方语境的高质量手势动作提供了进一步的解决方案。
直播将通过语音之家微信视频号进行直播
讨论群
扫码添加语音小管家,进入语音之家讨论群
为了共创高质量的论文预讲会,我们诚挚邀请所有 ICASSP 2024 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。
联系人邮箱
bd@speechhome.com
联系人微信