ICASSP 2024 论文预讲会由CCF语音对话与听觉专委会、语音之家主办,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 ICASSP 2024 录用论文的作者进行报告交流。
实验室概况
北京邮电大学智能语音与情感交互实验室【专场】
时间:3月28日(周四)19:00 ~ 20:00
形式:线上
议程:每位嘉宾分享30分钟(含5分钟QA)
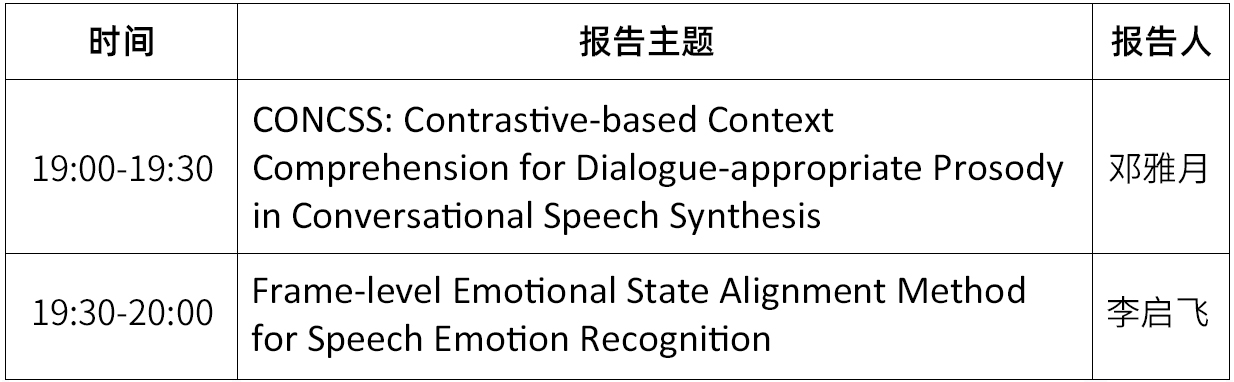
嘉宾&主题
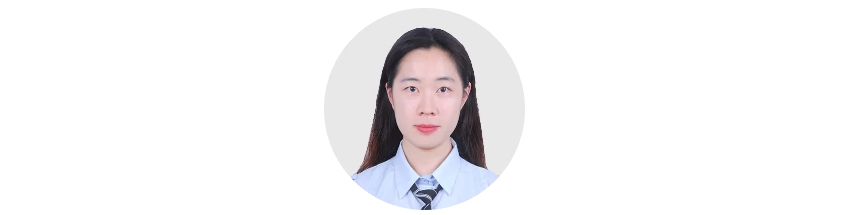
嘉宾简介:邓雅月,北京邮电大学人工智能学院智能语音与情感交互实验室二年级研究生,主要研究方向为高表现力语音合成、对话语音合成。合作文章曾发表于ICASSP,ACM MM等国际顶会。
分享主题:CONCSS: Contrastive-based Context Comprehension for Dialogue-appropriate Prosody in Conversational Speech Synthesis
摘要:近年来,随着深度学习技术的发展,基于神经网络的语音合成技术已经能够生成高质量的语音。然而,在一些复杂的对话场景中,这些合成系统仍存在不足,主要是它们难以生成具有自然对话风格韵律的音频。研究显示,将历史对话信息融入语音合成过程中,能够增强模型对历史对话内容的理解,进而提升合成语音的韵律表现。基于这一发现,我们提出了一种创新的对话语音合成框架——CONCSS。该框架融合了对比学习与语音合成技术,旨在学习有效且对上下文敏感的上下文表示。实验表明:在该向量指导下,下游的语音合成模型能够生成更加贴合历史对话语境的语音。
嘉宾简介:李启飞,北京邮电大学人工智能学院智能语音与情感交互实验室博士二年级研究生,主要研究方法为情感识别和抑郁症检测。合作文章曾发表于TAC,Neural Network,ACM MM,ICASSP,INTERSPEECH等研究领域内的期刊和会议。
摘要:语音情感识别(SER)系统的目标是在人机交互中识别人类的情感状态。大多数现有的SER系统是基于句子级别标签进行训练的。然而,音频中并非所有帧都表现出与句子级别标签一致的情感状态,这给准确辨别音频真实情感带来了挑战,造成识别系统性能不佳。为了解决这个问题,本文提出了一种用于SER的帧级情感状态对齐方法。整个方法分为三个步骤:1)利用聚类算法生成帧级别伪情感标签;2)通过帧级别情感伪标签继续预训练HuBERT模型实现帧级别情感对齐;3)通过注意力机制将帧级别情感表征与句子级别情感标签对齐实现SER。本文在IEMOCAP数据集上评估了所提方法的有效性,实验结果显示本文所提出的方法性能优于当前的其他先进方法的性能。
直播将通过语音之家微信视频号进行直播
讨论群
扫码添加语音小管家,进入语音之家讨论群

为了共创高质量的论文预讲会,我们诚挚邀请所有 ICASSP 2024 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。
联系人邮箱
bd@speechhome.com
联系人微信