ICASSP 2024 论文预讲会由CCF语音对话与听觉专委会、语音之家主办,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 ICASSP 2024 录用论文的作者进行报告交流。
ICASSP 2024 论文预讲会第二十二期邀请到萨里大学视觉语音与信号处理中心做本次会议的专场分享,欢迎大家观看。
实验室概况
萨里大学视觉语音与信号处理中心(CVSSP)由模式识别领域的开创者之一英国皇家工程院院士Josef Kittler教授成立于1986年,致力于机器感知(视觉,听觉),信号处理,人工智能等领域的研究。现有研究人员180余人(包括20余名教师,40余名博士后,近100名博士生),由皇家工程院院士Adrian Hilton教授领衔。CVSSP在计算机视觉和音视频人工智能领域排名全英第一。中心有世界级的音视频采集设备,计算和存储设施(1000CPU+300GPU+2PB). CVSSP机器听觉实验室现有约30名研究人员,在王文武,Mark Plumbley和Philip Jackson三位教授带领下,从事语音,音乐,一般声音(环境声音,声音事件,场景等等)相关的信号处理和人工智能方向的研究,涵盖的任务包括降噪,增强,分离,定位,跟踪,检测,分类,识别,标注,检索,生成,超分,转化,编码,等等。
第二十二期
萨里大学视觉语音与信号处理中心【专场】
时间:3月31日(周日)19:00 ~ 20:40
形式:线上
议程:每位嘉宾分享25分钟(含5分钟QA)
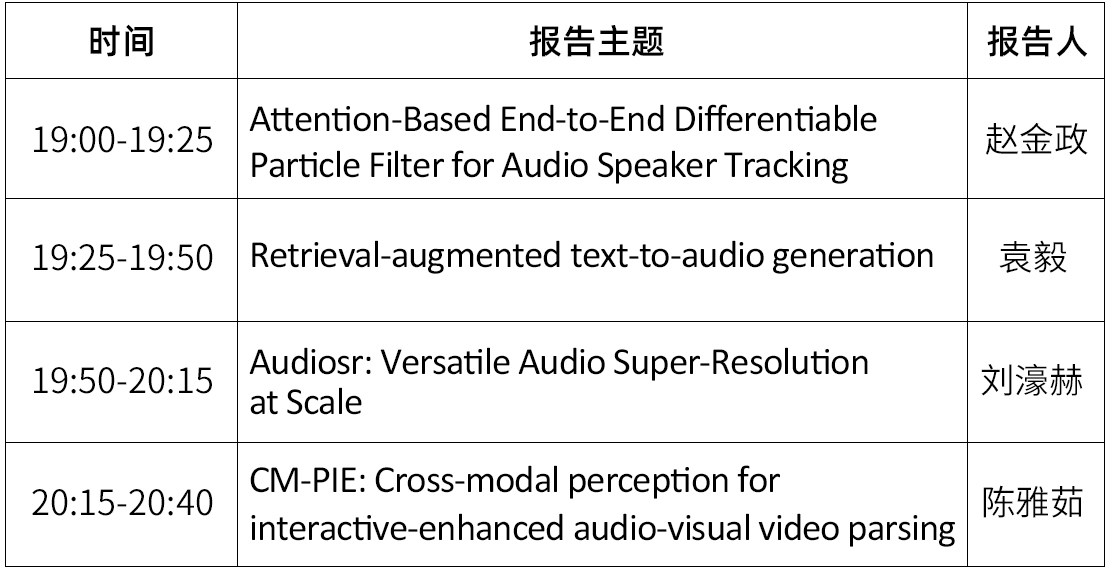
嘉宾&主题
嘉宾简介:赵金政,萨里大学视觉语音与信号处理中心2021级博士研究生,研究方向为多模态音视频内容理解,研究内容为音视频说话人追踪。在IEEE OJSP,ICASSP,INTERSPEECH, ACL, COLING等期刊会议发表文章若干。
分享主题:Attention-Based End-to-End Differentiable Particle Filter for Audio Speaker Tracking
摘要:粒子滤波因其能够对非线性过程或非高斯环境进行建模而被广泛用于说话人跟踪。然而,粒子滤波受到几个问题的限制。首先,使用预定义的measurement会限制模型的性能。此外,prediction和update模型往往是预设的,这使得它不能灵活适应不同的场景。为了解决这些问题,我们提出了一种端到端的可微粒子滤波框架,采用多头注意力来建模长距离依赖关系。所提出的模型采用self-attention作为可学习的prediction模型,使用cross-attention作为可学习的update模型。我们提出结合粒子滤波器和Transformer进行说话人跟踪,其中measurement提取、prediction和update步骤被集成到端到端架构中。在模拟数据集及真实数据集的实验结果表明,所提出的模型在单说话人及多说话人场景下比基线模型具有更优越的性能。
嘉宾简介:袁毅,萨里大学视觉语音与信号处理中心2022级博士研究生,研究方向为智能声音生成相关课题。在ICASSP,EUSIPCO, DCASE 等期刊会议发表文章若干,其参赛系统获得DCASE 2023 任务7 第一名。
摘要:尽管在文本到音频生成(TTA)方面取得了近期进展,如AudioLDM这样的最先进模型,训练在具有不平衡类别分布的数据集上(AudioCaps),其生成效果存在偏差。换句话说,它们在生成常见音频类别方面表现出色,而在稀有种类上表现不佳,因此降低了模型整体的生成性能。我们将这个问题称为长尾文本音频生成。为了解决这个问题,我们提出了一个简单的检索增强型方法应用于TTA模型。具体来说,给定一个输入文本提示,我们首先利用一个对比语言音频预训练(CLAP)模型来检索相关的文本-音频。然后,利用检索到的音频-文本数据的特征作为额外的条件来指导TTA模型的学习。我们用提出的方法增强了AudioLDM,并将结果增强系统称为Re-AudioLDM。在AudioCaps数据集上,Re-AudioLDM在FAD指标上达到了1.37,大幅度超越了现有方法。此外,我们展示Re-AudioLDM可以为复杂场景、稀有音频类别,甚至未见过的音频类型生成真实感音频,表明其在TTA任务中的潜力。
嘉宾简介:刘濠赫,萨里大学视觉语音与信号处理中心2022级博士研究生,师从Mark D. Plumbley教授和王文武教授。读博期间研究方向是智能音频创作相关课题。近期工作包括AudioLDM, VoiceFixer, NaturalSpeech, AudioSR等。其开源项目在GitHub上收获了7k+ star。
摘要:音频超分辨率是一项基础任务,旨在为低分辨率音频预测高频部分,以提高数字应用中的音频质量。以前的方法存在局限性,例如音频类型的范围有限,以及它们能够处理的特定带宽设置(例如,从4kHz到8kHz)。在这篇论文中,我们介绍了一种基于Diffusion的生成模型AudioSR,能够在包括音效、音乐和演讲在内的多种音频类型上执行稳健的音频超分辨率。具体来说,AudioSR能够将任何输入音频信号从2kHz到16kHz的带宽范围上采样到24kHz的高分辨率音频信号,并且采样率为48kHz。通过在各种音频超分辨率基准测试上进行广泛的客观评估,证明了所提模型的强大结果。此外,我们的主观评估显示,AudioSR可以作为一个插入式模块,以提高广泛的音频生成模型(包括AudioLDM、Fastspeech2和MusicGen)的生成质量。我们的代码和演示可在https://audioldm.github.io/audiosr上获得。
嘉宾简介:陈雅茹,萨里大学视觉语音与信号处理中心2022级博士研究生,研究方向为基于自然场景下的视频解析,研究内容为视听事件检测与定位。博士期间已发表论文2篇。
摘要:基于音频-视觉的视频解析(AVVP)是对仅包含弱标签的视频按片段级别进行事件检测,并将它们分类为可听或可见事件的一项任务。常用方法往往利用注意力机制来捕捉整个视频跨音频-视觉模态之间的语义相关性。然而,这些方法忽略了视频中个别段落包含的信息,也忽略了片段之间的关系;除此之外,现有的方法通常在学习特征时依赖于单一模态,也影响了最终的检测结果。在本文中,我们提出了一种新颖的交互增强的跨模态感知方法(CM-PIE),该方法首先通过应用基于片段的注意力模块来学习视频中更加细粒度的特征;此外,引入了跨模态聚合块,通过增强模态间的交互来共同优化音频和视觉信号的语义表示。实验结果表明,我们的模型在Look,Listen和Parse(LLP)数据集上相比其他方法提供了更好的解析性能。
直播将通过语音之家微信视频号进行直播
讨论群
扫码添加语音小管家,进入语音之家讨论群
为了共创高质量的论文预讲会,我们诚挚邀请所有 ICASSP 2024 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。
联系人邮箱
bd@speechhome.com
联系人微信