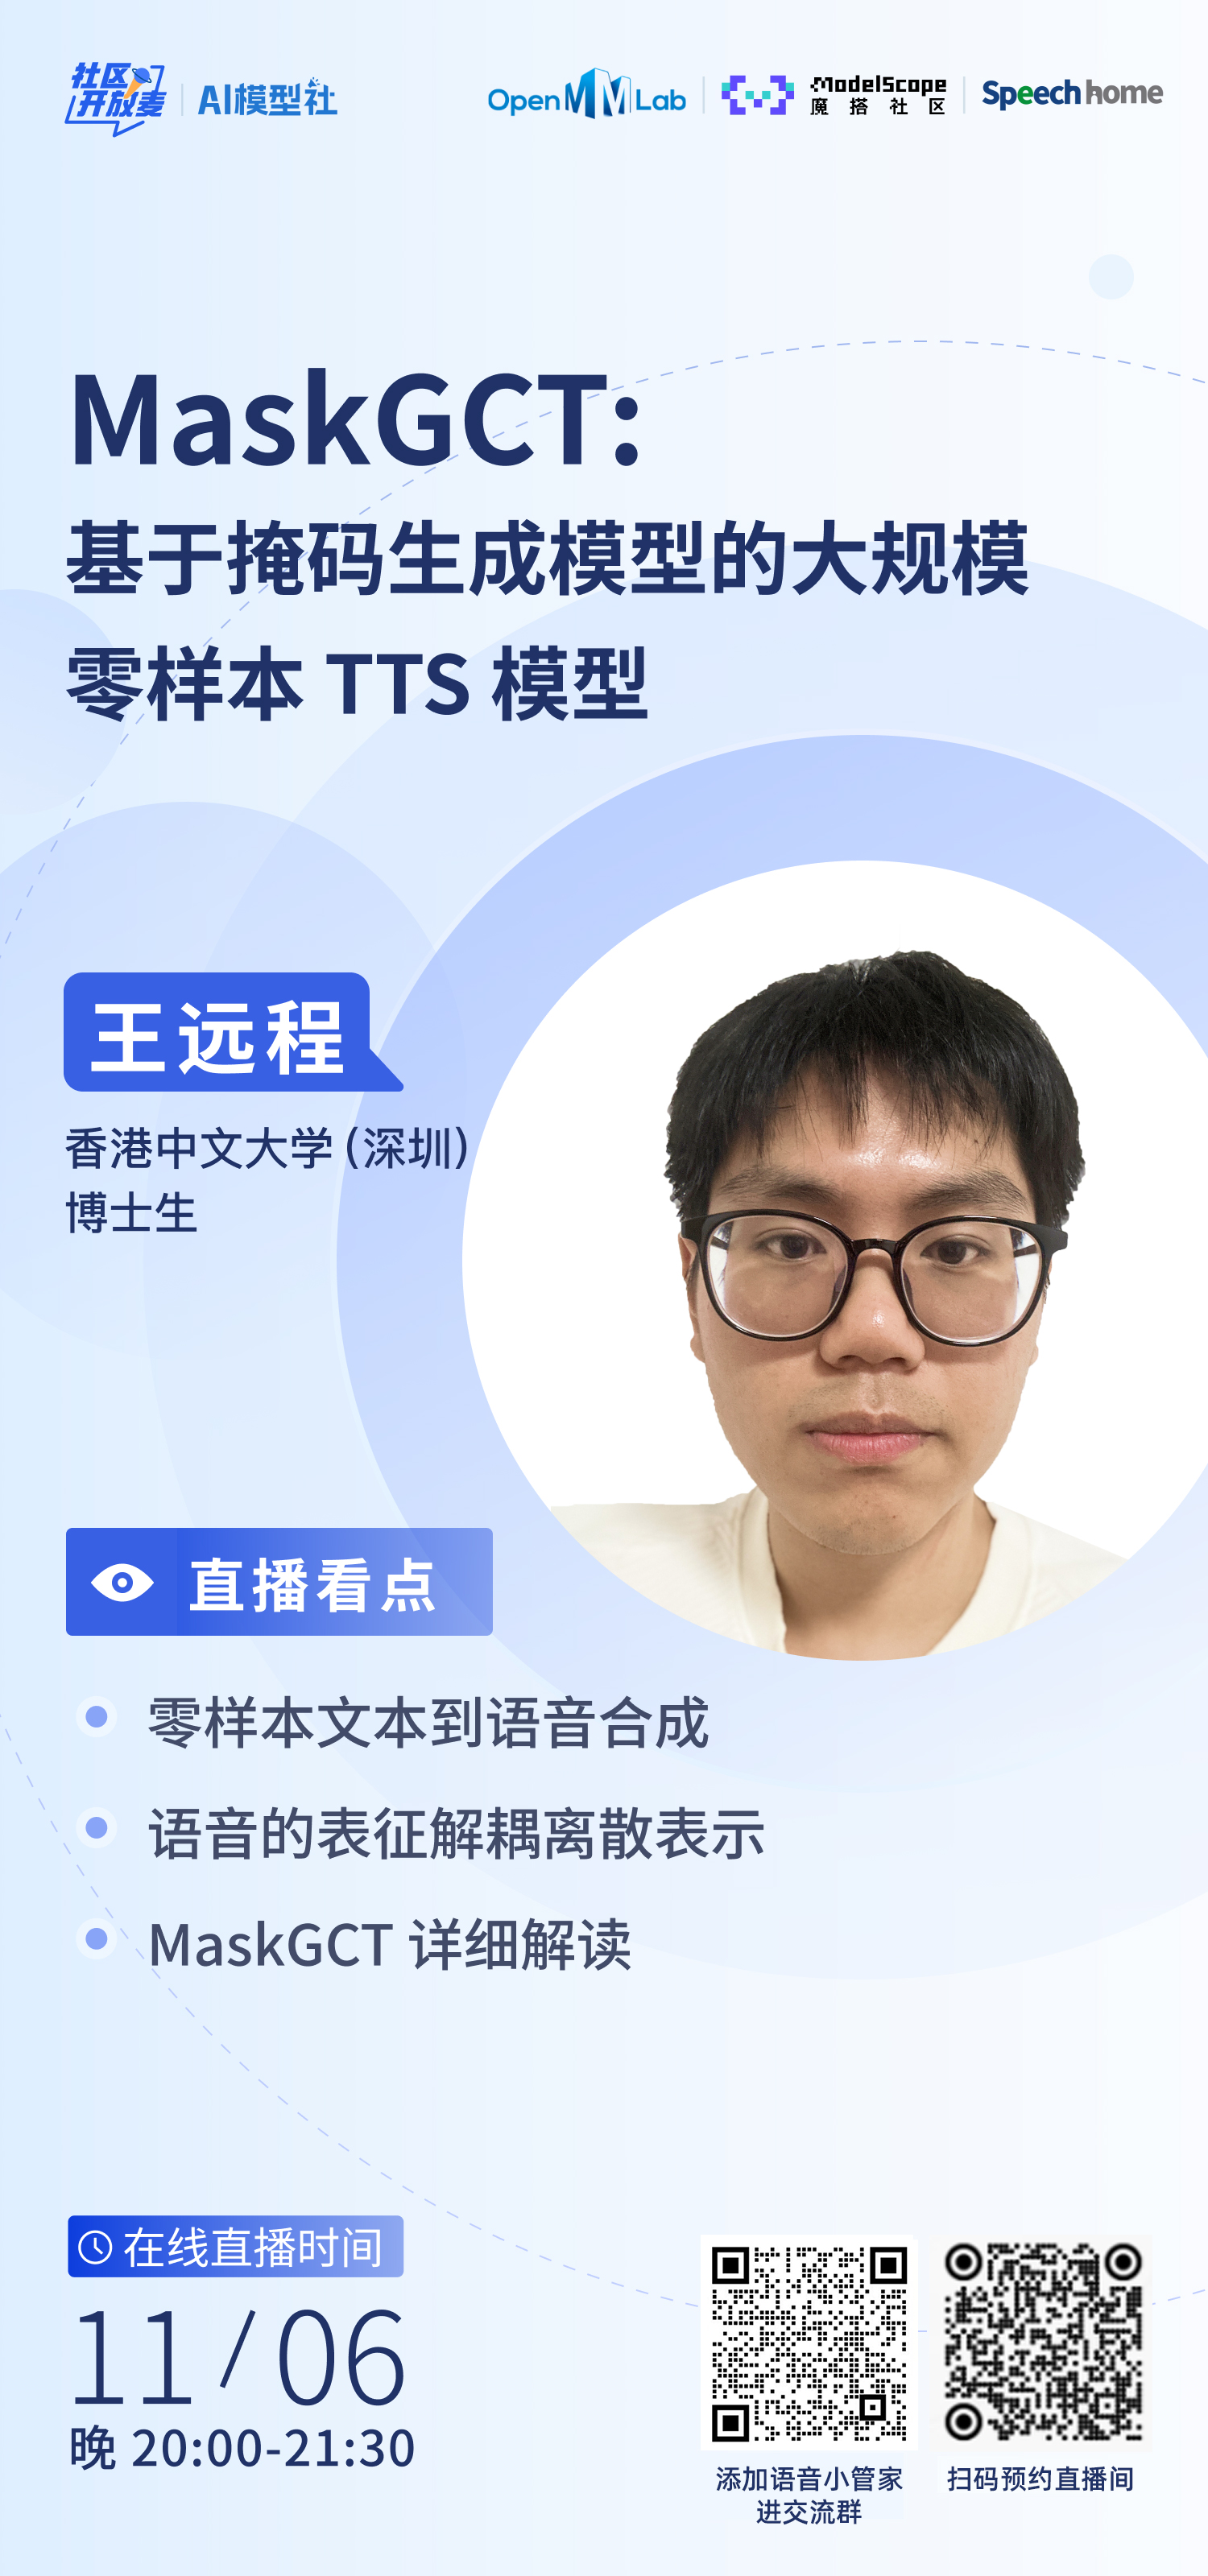
近期,港中大(深圳)联手趣丸科技联合推出了新一代大规模声音克隆 TTS 模型——MaskGCT。该模型在包含 10 万小时多语言数据的 Emilia 数据集上进行训练,展现出超自然的语音克隆、风格迁移以及跨语言生成能力,同时保持了较强的稳定性。MaskGCT 已在香港中文大学(深圳)与上海人工智能实验室联合开发的开源系统 Amphion 发布。
本期AI技术沙龙由开放麦联合魔搭社区、语音之家特别邀请到香港中文大学(深圳)博士生王远程同学带来《MaskGCT:基于掩码生成模型的大规模零样本 TTS 模型》的直播分享。
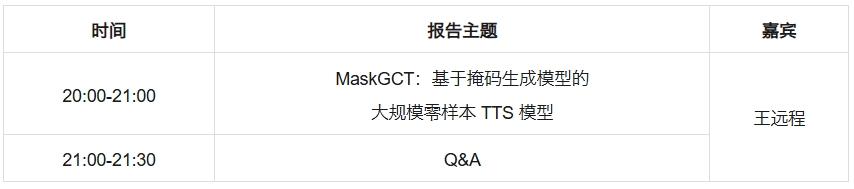
沙龙议程
时间:11月6日(周三)20:00 ~ 21:30
形式:线上直播
分享内容:零样本文本到语音合成、语音的表征解耦离散表示、MaskGCT 详细解读
分享嘉宾
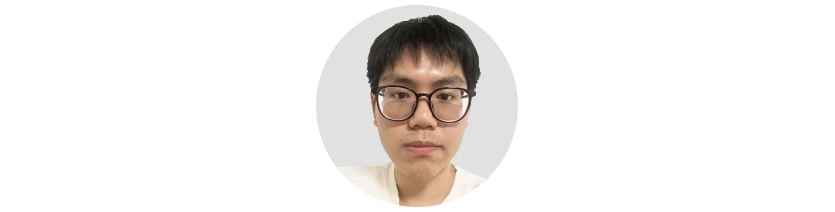
嘉宾简介:现为香港中文大学(深圳)的博士二年级学生,导师是武执政教授,曾在 NeurIPS, ICML, IEEE SLT 等会议上发表多篇论文。研究兴趣包括文本转语音合成、文本转音频生成以及统一音频表示和生成。王远程是开源 Amphion 工具包 (GitHub 7k+ stars) 的主要贡献者和领导者之一。曾共同主导开发了 NaturalSpeech 3,MaskGCT 等高级零样本文本转语音模型。
沙龙简介
本次分享将介绍一种名为 Masked Generative Codec Transformer(MaskGCT)的全非自回归 TTS 模型。现有大规模文本到语音(TTS)系统通常分为自回归和非自回归系统。自回归系统隐式地建模持续时间,但在鲁棒性和持续时间可控性方面存在一定缺陷。非自回归系统在训练过程中需要显式的文本与语音对齐信息,并预测语言单元(如音素)的持续时间,这可能会影响其自然度。
该模型消除了文本与语音监督之间的显式对齐需求,以及音素级持续时间预测。MaskGCT 是一个两阶段模型:在第一阶段,模型使用文本预测从语音自监督学习(SSL)模型中提取的语义标记;在第二阶段,模型基于这些语义标记预测声学标记。MaskGCT 遵循掩码预测学习范式。在训练过程中,MaskGCT 学习根据给定的条件和提示预测掩码的语义或声学标记。在推理过程中,模型以并行方式生成指定长度的标记。通过对 10 万小时的自然语音进行实验,结果表明 MaskGCT 在质量、相似度和可理解性方面优于当前最先进的零样本 TTS 系统。
文章详情:“MaskGCT:登上GitHub趋势榜榜首的TTS开源大模型”
参加方式
直播将通过语音之家微信视频号进行直播
手机端、PC端可同步观看
👇👇👇
讨论群
扫码添加语音小管家,进入语音之家讨论群
相关工作
Paper:https://arxiv.org/abs/2409.00750
GitHub:https://github.com/open-mmlab/Amphion/tree/main/models/tts/maskgct
Huggingface:https://huggingface.co/amphion/MaskGCT/tree/main
ModelScope:https://modelscope.cn/models/amphion/MaskGCT