为了更好地推动语音对话与听觉处理领域的深入交流与前沿研究,由中国计算机学会(CCF)语音对话与听觉专委会主办,武汉大学计算机学院及语音之家联合承办的第二届语音对话与听觉处理前沿进展研讨会(RASDAP2025, Recent Advances on Speech Dialogue and Auditory Processing)将于2025年6月14日在武汉大学计算机学院召开。
线上论坛
在研讨会开展前,为方便大家交流学习,将于6月11日、12日举办两场线上论坛,以下是第一场的相关议程:
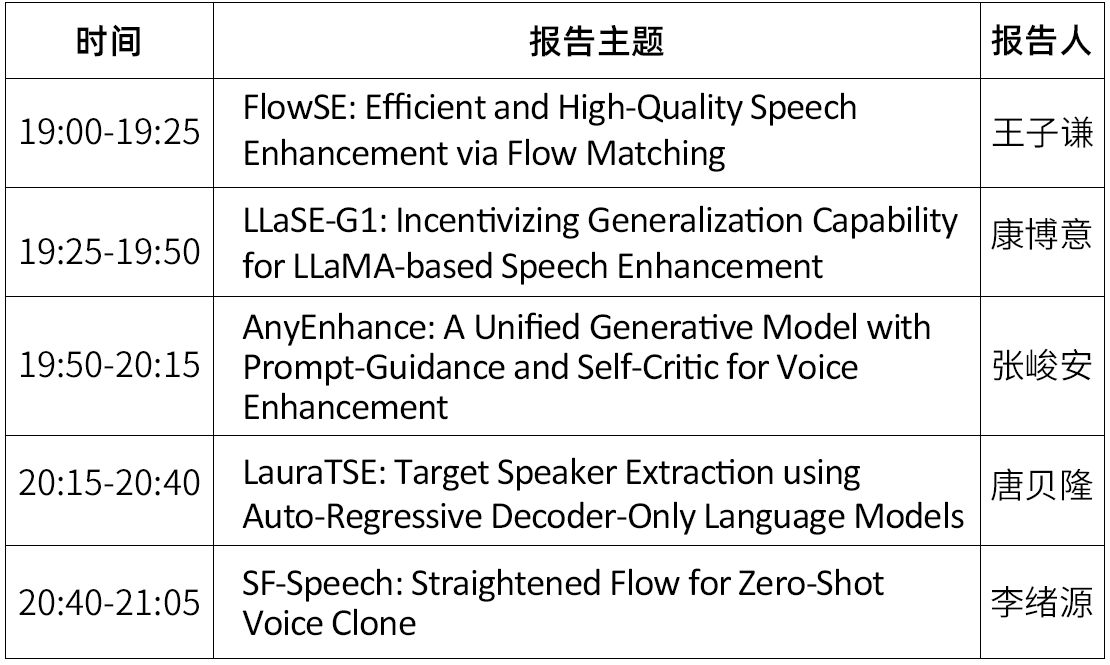
时间:6月11日(周三)19:00 ~ 21:05
形式:线上
议程:每位嘉宾分享25分钟(含5分钟QA)
嘉宾简介:王子谦,西北工业大学音频语音与语言处理研究组二年级硕士生,研究方向为语音增强,理解与生成。在IJCAI、ICASSP、Interspeech、SLT等语音顶级会议发表一作及合作论文十数篇,国家奖学金获得者。
分享主题:FlowSE: Efficient and High-Quality Speech Enhancement via Flow Matching
摘要:本文提出了一种新型语音增强模型FlowSE,基于流匹配(Flow Matching)框架,旨在解决当前生成式语音增强方法中的两大挑战:语言模型方法存在量化损失,影响语音的自然度与可懂度;扩散模型则训练与推理过程复杂,延迟高,难以实时应用。FlowSE通过学习噪声语音到干净语音的连续映射,实现在mel频谱域上的高质量增强,显著降低推理延迟。模型核心采用基于DiT(Diffusion Transformer)的速度场预测网络,可选地结合文本信息辅助建模,增强模型在低信噪比条件下的表现。实验在DNS Challenge和仿真数据集上验证了其优越性:FlowSE不仅在语音质量、说话人相似度和识别准确率方面超过现有主流方法,还在推理速度上具备显著优势(实时因子RTF低至0.31)。
论文链接:https://arxiv.org/abs/2505.19476
代码链接:https://github.com/Honee-W/FlowSE
Demo链接:https://honee-w.github.io/FlowSE/
嘉宾简介:康博意,西北工业大学音频语音与语言处理研究组一年级硕士生,研究方向为语音增强与理解。
分享主题:LLaSE-G1: Incentivizing Generalization Capability for LLaMA-based Speech Enhancement
摘要:语言模型 (LM) 的最新进展已展示出强大的语义理解和上下文建模能力,并在生成式语音增强 (SE) 中蓬勃发展。然而,许多基于 LM 的 SE 方法主要关注语义信息,往往忽略了声学信息的关键作用,这导致增强后的声学不一致,并且在各种 SE 任务中的泛化有限。在本文中,我们介绍了 LLaSE-G1,这是一种基于 LLaMA 的语言模型,旨在激励语音增强的泛化能力。LLaSE-G1 提供了以下关键贡献:首先,为了减轻声学不一致,LLaSE-G1 采用来自 WavLM 的连续表示作为输入,并预测来自 X-Codec2 的语音标记,从而最大限度地保留声学信息。其次,为了提高泛化能力,LLaSE-G1 引入了双通道输入和输出,统一了多个 SE 任务,且无需任务ID。第三,LLaSE-G1优于之前特定于任务的判别和生成 SE 模型,并展示了扩展效果以及针对未见过的 SE 任务的涌现能力。
论文链接:https://arxiv.org/pdf/2503.00493
代码链接:https://github.com/Kevin-naticl/LLaSE-G1
模型链接:https://huggingface.co/ASLP-lab/LLaSE-G1
Demo链接:https://submission-papers.github.io/LLaSE-G1-demo-page/
嘉宾简介:张峻安,香港中文大学(深圳)的一年级博士生,导师为武执政教授。本科毕业于复旦大学,研究方向主要为声音增强和音乐生成。他也是开源音频生成工具仓库Amphion的主要贡献者之一(github 9k+ stars)。他开发了用于语音和歌声增强的统一生成模型AnyEnhance,并且是LOKI(多模态大模型合成数据检测benchmark, ICLR2025 Spotlight)的核心贡献者。他的研究成果已发表在ICLR、TOSEM、SLT等顶级学术会议和期刊上。个人主页:https://github.com/viewfinder-annn
分享主题:AnyEnhance: A Unified Generative Model with Prompt-Guidance and Self-Critic for Voice Enhancement
摘要:我们提出了AnyEnhance,一个统一的人声增强生成模型,能够同时处理语音和歌声。AnyEnhance基于掩码生成模型(masked generative model),无需微调即可同时支持多种增强任务,包括去噪、去混响、去削波、超分辨率和目标说话人提取。模型引入了一种用于上下文学习(in-context learning)的提示引导机制,该机制允许模型直接利用参考说话人的音色,从而在有参考音频时提升增强效果,并在不改变底层架构的情况下实现目标说话人提取。此外,我们还在模型的生成过程中引入了self-critic训练,通过学习一个辨别真假audio token的critic头,在推理时即可迭代使用critic头来采样masked generative model输出,得到更高质量的输出。
论文链接:https://arxiv.org/abs/2501.15417
演示音频:https://amphionspace.github.io/anyenhance/
嘉宾简介:唐贝隆,2025 年 5 月毕业于昆山杜克大学, 即将攻读北卡罗来纳州立大学(NCSU)电子与计算机工程系(ECE)博士学位,我的研究方向将聚焦于扩散模型以及其他生成模型。我的研究兴趣包括:深度学习、统计机器学习与信号处理。
分享主题:LauraTSE: Target Speaker Extraction using Auto-Regressive Decoder-Only Language Models
摘要:我们提出了LauraTSE,一种基于LauraGPT 架构的自回归Decoder-only语言模型,用于目标说话人提取。LauraTSE 利用一个小规模的自回归decoder-only模型,从混合语音和参考语音的连续特征中生成目标语音离散编码表示的初始层,作为初始预测结果。随后,我们使用一个一步式的encoder-only语言模型,通过整合混合语音和参考语音的信息,对初始结果进行重构,以添加音色等细粒度细节。我们的方法在多个指标上实现了优于或可比主流目标说话人提取模型的性能。我们还进行了消融实验,探讨数据扩展性以及encoder-only模型在整体系统中的作用。
论文链接:https://arxiv.org/abs/2504.07402
代码链接:https://github.com/Beilong-Tang/lauraTSE_code
Demo链接:https://beilong-tang.github.io/lauraTSE.demo/
嘉宾简介:李绪源,中科院声学研究所在读博士。研究方向为语音合成,音频生成等。曾在InterSpeech,TASLP等会议和期刊上发表多篇论文。最近工作关注于高临场感的多模态语音合成。
分享主题:SF-Speech: Straightened Flow for Zero-Shot Voice Clone
摘要:近年来,利用流匹配训练的神经常微分方程(ODE) 模型在零样本语音克隆任务中取得了令人瞩目的表现。然而,将标准高斯噪声假设为 ODE 的初始分布会导致流匹配拟合路径之间存在大量交叉。增加建模复杂度的同时,同样增加了网络学习到的生成轨迹的曲率。这些弯曲的轨迹限制了 ODE 模型仅用几步即可生成理想样本的能力。本文提出了一种基于 ODE 和上下文学习的新型语音克隆模型 SF-Speech。与之前的研究不同,SF-Speech 采用轻量级多阶段模块来为 ODE 生成更确定性的初始分布。在不引入任何额外损失函数的情况下,我们通过与所提出的模块联合训练 ODE 模型,有效地拉直了 ODE 模型的弯曲反向轨迹。在不同规模的数据集上进行的实验结果表明,SF-Speech 的性能优于最先进的零样本语音合成方法,且生成速度约为 Voicebox 和 E2 TTS 的 3.7 倍。
论文链接:https://arxiv.org/abs/2410.12399
参与方式
直播将通过语音之家微信视频号进行直播
手机端、PC端可同步观看
👇👇👇