为了更好地推动语音对话与听觉处理领域的深入交流与前沿研究,由中国计算机学会(CCF)语音对话与听觉专委会主办,武汉大学计算机学院及语音之家联合承办的第二届语音对话与听觉处理前沿进展研讨会(RASDAP2025, Recent Advances on Speech Dialogue and Auditory Processing)将于2025年6月14日在武汉大学计算机学院召开。
线上论坛
在研讨会开展前,为方便大家交流学习,将于6月11日、12日举办两场线上论坛,以下是第一场的相关议程:
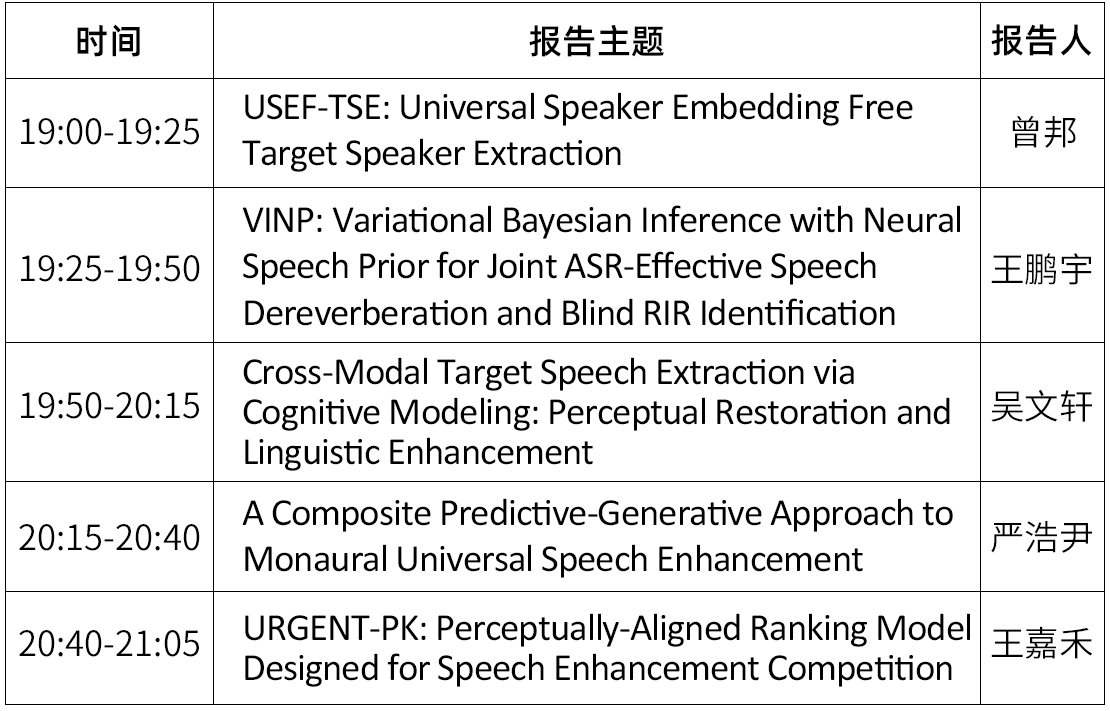
时间:6月12日(周三)19:00 ~ 21:05
形式:线上
议程:每位嘉宾分享25分钟(含5分钟QA)
嘉宾简介:曾邦,武汉大学计算机科学与技术专业博士生,昆山杜克大学语音及多模态智能信息处理实验室研究实习生, 主要研究方向为特定人语音分离、特定人语音活动监测。
分享主题:USEF-TSE: Universal Speaker Embedding Free Target Speaker Extraction
摘要:目标说话人提取旨在从混合语音中分离出特定说话人的声音。传统方法通常依赖于从参考语音中提取说话人嵌入向量,这一过程需要借助说话人识别模型。然而,选择合适的说话人识别模型存在一定挑战,同时,直接使用说话人嵌入作为参考信息在提取任务中并不一定是最优方案。本文提出了一种通用的、无需说话人声纹嵌入的目标说话人提取框架——USEF-TSE(Universal Speaker Embedding-Free Target Speaker Extraction)。该框架引入多头跨注意力机制作为帧级目标说话人特征提取器,在不依赖说话人嵌入的前提下,有效利用参考语音中包含的说话人特征与上下文信息。这一创新方法打破了对说话人识别模型的依赖,为主流说话人提取方案提供了更简洁高效的替代路径。此外,USEF-TSE 可无缝集成到其他时域或时频域语音分离模型中,从而实现高效的说话人提取。实验结果表明,所提出的方法在 WSJ0-2mix、WHAM! 和 WHAMR! 数据集上,在 Scale-Invariant Signal-to-Distortion Ratio(SI-SDR)指标下都取得了先进水平。在 LibriMix 数据集及 ICASSP 2023 DNS 挑战的盲测集上的结果也进一步验证了该方法在多样化与域外数据上的鲁棒性与泛化能力。
嘉宾简介:王鹏宇,浙江大学与西湖大学联合培养博士生,导师为李晓飞老师。研究兴趣包括语音增强和去混响、阵列信号处理等。个人主页:https://pengyvwang.github.io/
分享主题:VINP: Variational Bayesian Inference with Neural Speech Prior for Joint ASR-Effective Speech Dereverberation and Blind RIR Identification
摘要:混响语音包含了源语音与房间冲激响应(RIR)的关键信息。本文提出基于深度语音先验的变分贝叶斯推理框架VINP,实现语音识别(ASR)友好的语音去混响和盲RIR辨识。VINP将语音建模为随机信号,在时频域构建基于卷积传递函数的信号模型,运用深度神经网络预测源语音的先验分布,并通过变分贝叶斯推论,同步求解无混响语音和房间冲激响应。区别于多数单通道语音去混响方法,VINP 能够显著提升ASR系统性能。实验结果显示,在语音去混响任务中,VINP在多项指标达到先进或领先水平;在盲房间脉冲响应辨识任务中,VINP对混响时间(RT60)和直达混响比(DRR)的盲估计达到领先水平。相关资源已在Github开源。
嘉宾简介:吴文轩,香港中文大学博士生,研究方向为目标说话人语音提取, 曾在Interspeech, ICASSP, JSTSP等语音会议和期刊发表多篇文章。
分享主题:Cross-Modal Target Speech Extraction via Cognitive Modeling: Perceptual Restoration and Linguistic Enhancement
摘要:Humans possess the remarkable ability to unconsciously fill in unclear perceptual segments when processing speech in cocktail party environments. To endow TSE models with this cognitive capability, we address two fundamental challenges: identifying unclear extraction segments and effectively filling in the missing information. We propose "Context and Confidence-aware AV-TSE," a model-agnostic two-stage fine-tuning framework that successfully mitigates extraction inconsistencies. Additionally, to harness the potential of deeper semantic understanding beyond traditional audio-visual signals, we integrate linguistic constraints derived from large language models (LLMs) into AV-TSE architectures. Our proposed approach demonstrates consistent improvements in speech quality and intelligibility, with particularly robust performance gains in scenarios where visual cues are compromised.
嘉宾简介:严浩尹,2023年获得中国科学技术大学电子信息工程专业学士学位,目前在中国科学技术大学信息科学技术学院语音及语言信息处理国家工程研究中心攻读硕士学位,导师为张结副教授。研究方向为语音信号处理,包括单/多通道语音增强、目标说话人提取以及语音生成,已发表TASLPRO、ICASSP、Interspeech等高水平期刊和会议论文4篇,公开国家发明专利1项,作为项目骨干参与招商银行、阿里巴巴等企业横向项目2项,获得ICASSP2023三维声音事件检测与定位比赛(L3DAS23)定位赛道第2名。
分享主题:A Composite Predictive-Generative Approach to Monaural Universal Speech Enhancement
摘要:设计一种能够抑制各种失真并提升语音质量的通用模型是非常有前景的,即通用语音增强(Universal Speech Enhancement, USE)。与基于监督学习的预测方法相比,基于扩散的生成模型由于具备从信息严重受损的退化语音中进行生成的能力,展现出了更大的潜力。然而,扩散模型在高度恶劣的条件下可能会引入伪影,并且其推理过程通常需要多步采样,导致计算负担较重。为了同时利用预测和生成建模的优势,并克服各自的缺陷,本文提出了PGUSE(Predictive-Generative Universal Speech Enhancement)通用语音增强模型,该模型结合了预测与生成两种建模方式。PGUSE模型包含两个分支:(1)预测分支直接从退化的信号中预测出干净的语音样本;(2)生成分支优化扩散模型的去噪分数匹配目标。我们采用了输出融合与截断扩散策略来有效整合预测与生成建模:前者将两个分支的结果进行融合,后者则通过预测分支提供的初始估计来修改扩散模型的反向扩散过程。在多个数据集上的大量实验验证了所提出模型的优越性,展示了预测与生成建模相结合所带来的互补性和优势。
代码和Demo链接:https://hyyan2k.github.io/PGUSE
https://hyyan2k.github.io/PGUSE
嘉宾简介:王嘉禾,上海交通大学听觉认知与计算声学实验室一年级硕士生,研究方向为语音增强和提取。
分享主题:URGENT-PK: Perceptually-Aligned Ranking Model Designed for Speech Enhancement Competition
摘要:平均意见得分(MOS)是语音质量评估中至关重要。然而,获取MOS需要大量的人工标注。尽管人们已经开发了诸如DNSMOS和UTMOS等深度神经网络方法来预测MOS以规避此问题,但这些方法通常受限于训练数据不足。我们认识到语音增强(SE)系统间的比较更注重可靠的系统间排序而非绝对分数,从而提出了URGENT-PK,一种利用成对比较的新型排序方法。URGENT-PK以同源增强语音对作为输入,预测其相对质量并对所有系统进行排序。这种成对比较范式能够高效利用有限的训练数据,因为多个系统的所有成对排列都可以构成一个训练实例。在多个开放测试集上的实验表明,尽管URGENT-PK网络结构简单且训练数据有限,但其在系统级排序的性能上优于当前最先进的基线方法。
参与方式
直播将通过语音之家微信视频号进行直播
手机端、PC端可同步观看
👇👇👇