INTERSPEECH 2026 论文预讲会由中国中文信息学会、CCF语音对话与听觉专委会、深圳市人工智能学会、语音之家发起,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 INTERSPEECH 2026 录用论文的作者进行报告交流。
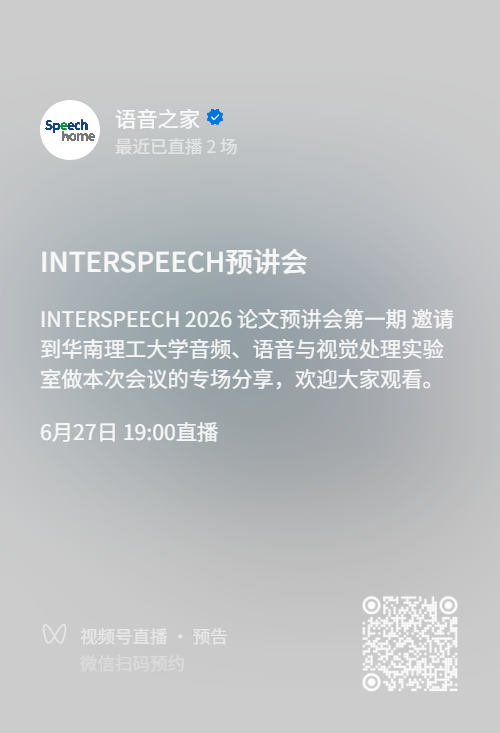
INTERSPEECH 2026 论文预讲会第一期邀请到华南理工大学音频、语音与视觉处理实验室做本次会议的专场分享,欢迎大家观看。
实验室概况
音频、语音与视觉处理实验室( Audio, Speech and Vision Processing Laboratory, ASVP Lab)成立于1993年,主要从事音频、语音与视觉信号处理技术研究及其应用开发(具体研究方向见后面的清单)。已发表高水平学术论文两百余篇;获得国家发明专利三十余件;获得多项省部级科技奖励。研究成果已被华为技术有限公司、广东省电信研究院、广州海格通信集团等企业所应用,取得了良好的社会、经济效益。
实验室注重国际学术交流,与卡耐基梅隆大学、华盛顿大学、剑桥大学、伦敦玛丽女王大学、坦佩雷大学、萨里大学、新加坡国立大学、香港城市大学等国际著名大学具有人才培养和科研合作;同时也培养了一批来自法国、多哥、喀麦隆、坦桑尼亚、巴基斯坦、斐济等国的留学生。
实验室现有教师2人,在读博/硕士生十余人。实验室已毕业硕士研究生一百余人、博士研究生二十余人,国内访问学者十余人。研究生就业单位主要为国内知名高校、研究所和IT企业。
第一期:华南理工大学音频、语音与视觉处理实验室【专场】
时间:6月27日(周六)19:00 ~ 20:00
形式:线上
议程:每位嘉宾分享20分钟(含5分钟QA)
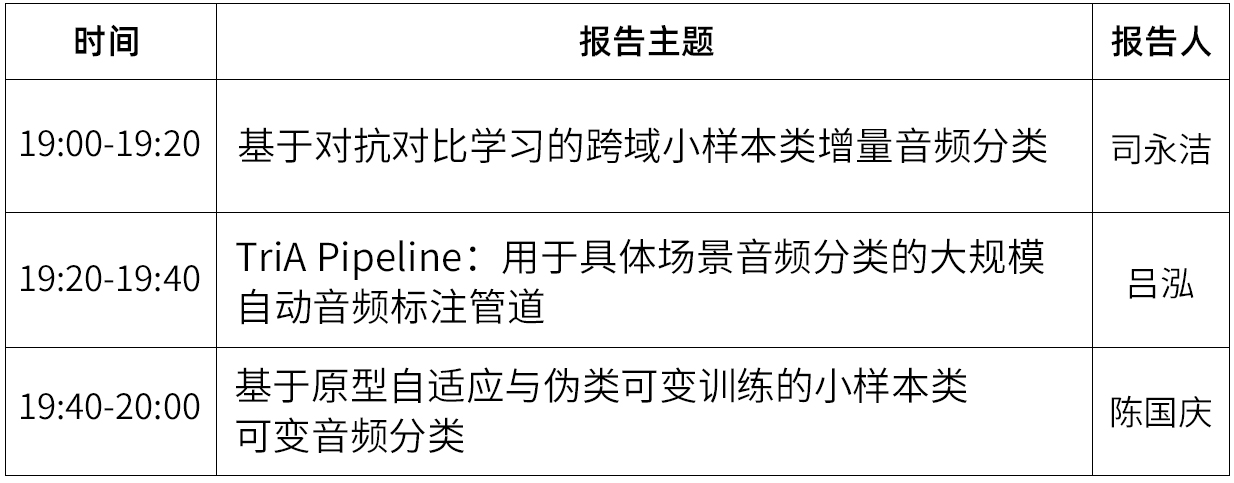
嘉宾&主题
嘉宾简介:司永洁,华南理工大学电子与信息学院四年级博士生,研究方向为音频信号处理和机器学习。
分享主题:基于对抗对比学习的跨域小样本类增量音频分类(Cross Domain Few-Shot Class-Incremental Audio Classification Via Adversarial Contrastive Learning)
摘要:当前的小样本类增量音频分类方法假设基础环节的音频类别和增量环节的音频类别样本属于同一域(遵循相同的分布)。然而,上述两种类型的样本之间通常存在域偏移。本文探讨了基类和增量类样本具有域偏移的跨域小样本类增量音频分类问题。论文提出一种对抗对比训练策略,使模型能够有效地对来自未知领域的不同类别样本进行分类。该模型由编码器和分类器组成。编码器在基础环节中训练,但在增量环节中冻结,而分类器在所有环节中训练。实验在六对跨域数据集上进行。结果表明,论文方法在平均准确率上超过了最先进的方法。
代码链接:hhttps://github.com/YongjieSi/ACL
嘉宾简介:吕泓,华南理工大学电子与信息学院二年级硕士生,研究方向为音频信号处理和机器学习。
分享主题:TriA Pipeline:用于具体场景音频分类的大规模自动音频标注管道(TriA Pipeline: A Large-Scale Automatic Audio Annotation Pipeline For Audio Classification In Specific Scenarios)
摘要:音频分类存在各种规模的数据集,被应用于各种场景下的分类任务。然而,仍有部分场景缺乏标注数据,例如家庭环境。为了应对这一挑战,我们提出了TriA Pipeline,这是一个自动音频标注管道,可以高效地将来自各种场景的音频转换为带音频事件标注的高质量训练数据。基于TriA Pipeline构建了TriA数据集,这是一个包含超过2130小时、涵盖431类事件的音频数据集。此外,我们从TriA中划分出一个先验知识指导的子集(),并且在三个家庭音频分类任务上进行了对比实验。将仅使用人工标注数据的结果与同时使用人工标注数据和的结果进行比较,能够在准确率上获得3.97%,以及在Macro-F1上获得3.35%的平均相对提升,验证了和TriA Pipeline的有效性。
代码链接:https://github.com/huanxian/TriA
嘉宾简介:陈国庆,华南理工大学电子与信息学院二年级硕士生,研究方向为音频信号处理和机器学习。
分享主题:基于原型自适应与伪类可变训练的小样本类可变音频分类(Few-shot Class-variable Incremental Audio Classification via Prototype Adaptation and Pseudo Class-variable Training)
摘要:在小样本类增量音频分类任务中,通常假设类别数量逐渐增加,而未考虑类别数量减少的可能性。然而,在实际应用中,类别数量往往既可能增加,也可能减少。本文研究了小样本类可变增量音频分类问题,其中类别数量可以动态增加或减少。我们提出了一种基于原型自适应和伪类可变训练的方法。该方法中的模型由编码器和分类器组成。分类器通过一个类别可变原型自适应网络进行初始化,该网络能够随着类别变化而动态调整分类器。此外,我们设计了一种伪类可变训练策略,以增强模型对类别变化的适应能力。在三个公开数据集上的实验结果表明,我们的方法在平均准确率上优于以往方法。
论文链接:https://arxiv.org/abs/2606.08898
参与方式
直播将通过语音之家微信视频号进行直播
手机端、PC端可同步观看
👇👇👇
预讲会征集
INTERSPEECH 2026 论文预讲会面向全球线上招募,结合定向邀请与征集报名的方式,来选择预讲会的嘉宾。
为了共创高质量的论文预讲会,我们诚挚邀请所有 INTERSPEECH 2026 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。