
 语音小管家
过去两年,TTS(文本转语音)赛道的竞争焦点发生了一次微妙的转移。
早期大家比的是“像不像真人”——音色克隆、自然度、音质MOS分。但当ElevenLabs把Voice Design的概念带火之后,一个新的问题浮出水面:一个声音“好听”,不等于它能“演”好一个角色。
在短剧、游戏NPC、AI Companion、实时语音对话这些场景里,用户要的不是一段标准播音腔,而是一个有性格、有情绪、有细节的“人”——他会呛到咳嗽、会嘴硬、会叹气、会在句子中间笑场。这些“文字里没写,但人一定会说出来”的东西,才是Voice Design TTS真正要解决的问题。
近日,清华黄民烈教授创立的聆芯智语发布了LingX-TTS,一款定位Voice Design的高表现力语音生成模型。我们通读了他们的技术博客,结合公开评测数据,从技术视角拆解一下:这款模型在Voice Design赛道里到底处于什么位置,技术路线有哪些值得关注的地方,以及当前方案的边界在哪里。
关于团队
聆芯智语创始人黄民烈是清华大学长聘教授、博士生导师,国家杰出青年基金获得者,清华大学基础模型中心副主任,同时也是智谱AI的科学家。团队在对话系统、情感计算和大语言模型方向有长期积累,LingX-TTS是他们在语音交互方向的首个模型产品。
⏩三个评测基准:LingX-TTS在Voice Design赛道的位置
看一个TTS模型强不强,不能只听Demo。LingX-TTS团队自建了三个评测基准,我们逐个来看:
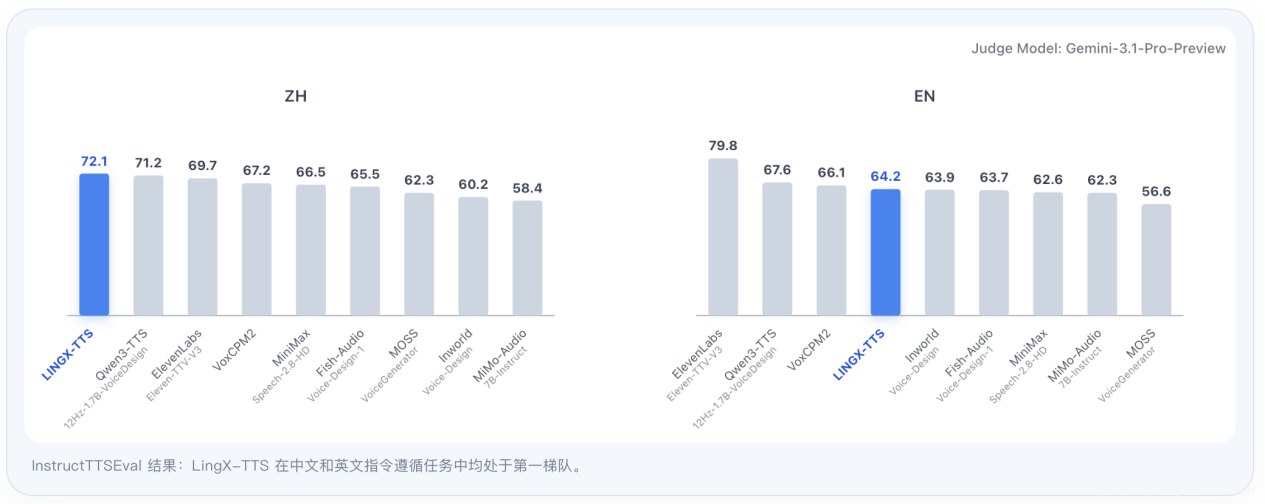
1、InstructTTSEval:指令遵循能力——中文72.1分,显著领先
指令遵循(Instruction Following)是Voice Design TTS的基本功。用户说“温柔地说”“语速快一点”“换成一个愤怒的男性”,模型能不能准确执行?这直接决定了Voice Design是“可玩的玩具”还是“可用的工具”。
InstructTTSEval覆盖三类任务:声学参数指定(音调、语速、音量等底层控制)、描述性风格指令(温柔、严肃、活泼等高层风格)、角色扮演(特定身份和场景的演绎)。
公开结果显示,LingX-TTS在中文任务上取得72.1分,显著领先同类模型;英文64.2分,处于第一梯队。这意味着团队在中文语音指令遵循上做了大量针对性优化,中文场景下的控制精度是其核心优势之一。
2、ExpressTTS-Bench:场景化表现力——中文四项全部第一
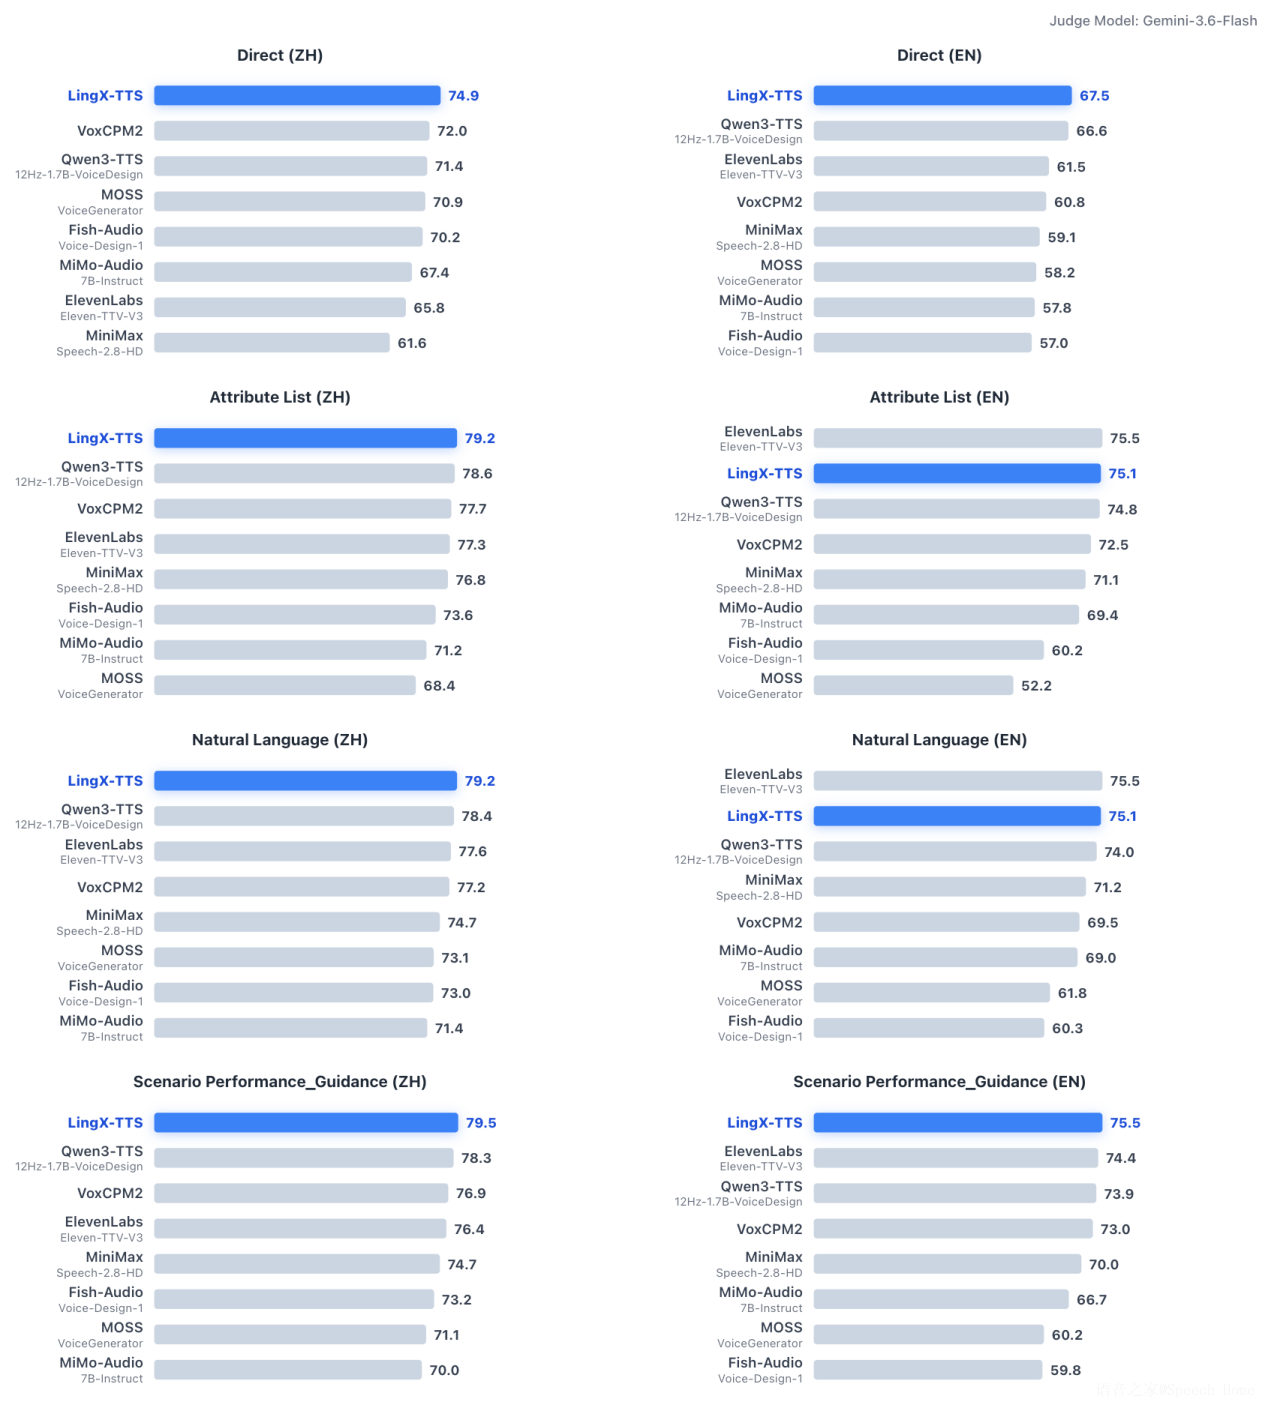
这是团队自建的表现力评测基准,从情感、韵律、副语言三个维度拆解表现力,并用四种不同提示方式检验模型泛化性:
- 空指令(默认风格)
- 属性列表(音色、年龄、情绪等参数化描述)
- 自然语言指令(用日常语言描述想要的效果)
- 场景化表演指导(给一段场景描述和角色设定,让模型自由发挥)
从公开结果看,LingX-TTS在中文四种提示方式下全部第一;英文两种设置也拿到最高分。
技术点评
场景化表演指导这一项最能体现Voice Design能力——用户不给具体参数,只给一段场景描述,模型能不能自己理解这个角色在这个情境下应该怎么说话。LingX-TTS在这项上的领先,说明它不是靠参数堆砌出来的效果,而是真的理解了场景和情绪的关系。
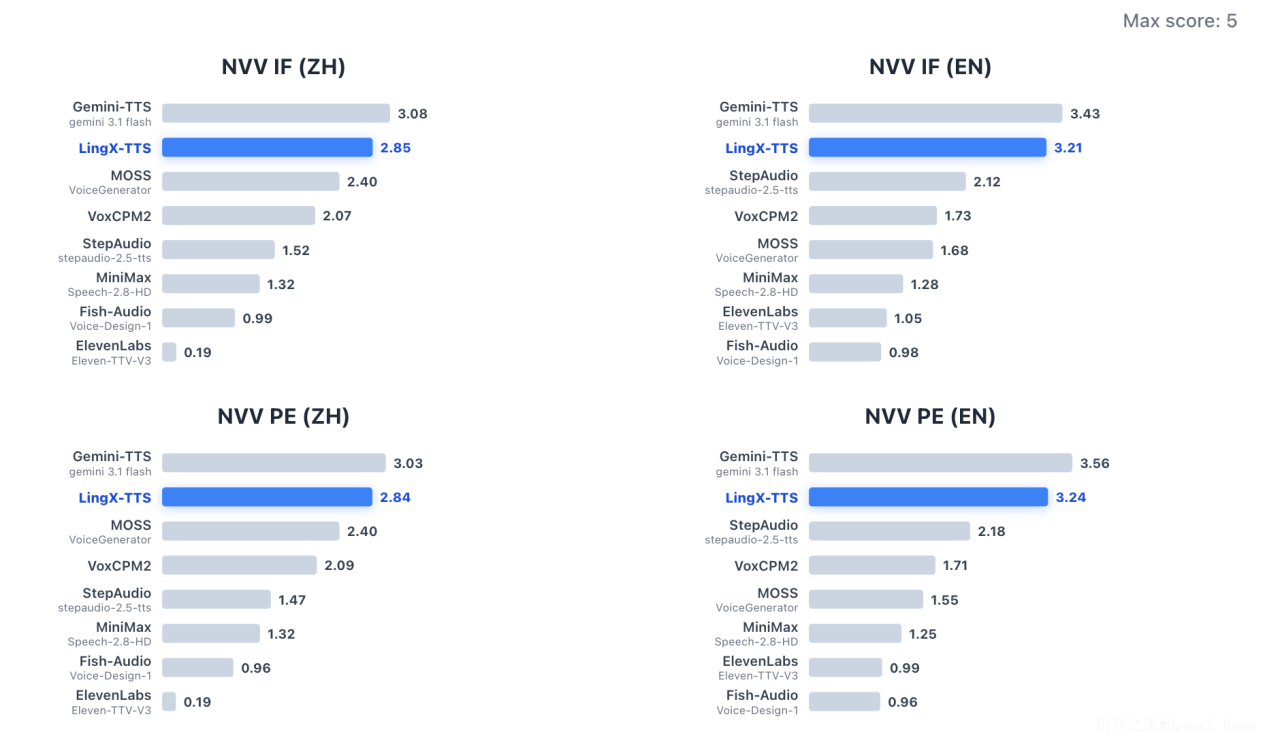
3、 NVV-SuperBench:副语言生成——仅次于Gemini-TTS
副语言(Paralanguage)是指咳嗽、叹气、哈欠、笑声、呼吸声这些非词汇性发声。人类交流中大量信息其实不靠词语,而是靠这些声音里的细节传递的。
在NVV-SuperBench基准上,LingX-TTS在副语言指令遵循(NVV-IF)和感知效果(NVV-PE)两个维度、中英双语四个测试项中,全部排名第二,仅次于Gemini-TTS,大幅领先其余模型。
这个结果很值得关注:副语言生成长期是TTS的盲区——大多数模型要么不支持,要么随机生成不可控。LingX-TTS把副语言从随机彩蛋变成了可按指令生成的Voice Design组件,这是真正的差异化。
⏩技术深度:高表现力TTS到底难在哪?
评测数据好看只是表面,真正的问题是:为什么大多数TTS模型做不到高表现力?LingX-TTS的技术路线解决了什么核心问题?
1、数据问题:为什么“多采情绪语音”不够?
直觉上,要做高表现力TTS,是不是多收集一些带情绪的语音数据就行了?团队在技术博客里明确否定了这个思路:
“大规模语音数据通常能很好地覆盖语言内容、说话人和基础音色,但真正强烈、细腻且具有明确场景动机的表达,在自然数据中往往既稀缺又高度不均衡。更重要的是,高表现力并不是一个可以独立于场景存在的标签。”
这句话点到了问题的本质。同一个“愤怒”标签,在“争吵”和“压抑地质问”两种场景下,音高变化、语速、停顿、呼吸方式完全不同。如果只给数据打“愤怒”这个标签,模型学到的只是“愤怒=大声+快语速”,而不是“在这个场景下,这个角色应该怎么愤怒”。
所以LingX-TTS团队的做法是:把高表现力数据构造从“增加更多情绪语音”升级为“场景化表达空间的系统构造”。他们构建了大规模私有的场景化高表现力语音训练样本数据,不只是扩大样本数量,更让场景、身份、情感等不同能力以足够丰富的组合形式共同出现。
2、数据合成Pipeline:全自动、可扩展
光靠人工标注场景化数据,成本太高、覆盖不够。团队还搭建了一套全自动、可扩展的数据合成pipeline,实现对场景、身份、情感等复杂元素的组合式覆盖,并特别强调基于情景上下文的情感、韵律、副语言协同生成。
这个思路和大语言模型里的“数据引擎”异曲同工——靠人工标注做到一定规模后,必须用合成数据来扩展覆盖度,尤其是长尾场景。对TTS来说,合成数据的难点在于:不能只是换个情绪标签重新合成一遍,而是要保证场景、角色、情绪之间的逻辑一致性。
3、训练范式:预训练 → SFT → 强化学习
模型训练沿用了“预训练 → 监督微调 → 强化学习”的标准三段式范式,但在强化学习阶段做了针对性设计。团队用了四个互补的奖励信号做联合优化:
| 奖励信号 | 衡量什么 | 作用 |
| 内容准确性 | 生成语音和文本的匹配度 | 防止为了表现力牺牲可懂度 |
| 音频质量 | 音质自然度、清晰度 | 防止出现噪音、金属音等问题 |
| 指令遵循 | 是否准确执行用户指令 | 保证Voice Design的可控性 |
| 表现力 | 语音的情感丰富度和自然度 | 核心优化目标——让声音“演”起来 |
技术点评
四个奖励信号之间是有张力的——比如追求表现力,可能会牺牲内容准确性(念错字);追求音质,可能会让情绪变“平”。怎么平衡这四个目标,是RL阶段最考验工程能力的地方。团队没有公开具体的奖励权重和调参策略,但从评测结果看,他们在表现力和可懂度之间找到了不错的平衡点。
⏩当前方案的边界和局限
说了这么多优点,我们也客观看一下LingX-TTS当前待验证的问题:
1、长文本一致性
公开Demo大多是短句子(10-30秒),在长段落、多轮对话场景下,角色风格和情绪状态能不能保持一致?比如一个5分钟的有声书片段,开头是愤怒,中间是悲伤,结尾是释然——模型能不能做到情绪的自然过渡,而不是每句话都演得很用力?这是长文本场景下必须验证的问题。
2、 英文表现力
从ExpressTTS-Bench结果看,英文两项虽然也是最高分,但分数和中文的差距有多大?在NVV-SuperBench上,LingX-TTS英文也是第二,仅次于Gemini-TTS;Gemini本身是英文优先的模型,LingX-TTS在英文上和它的差距,比在中文上的差距大吗?这个对出海场景很关键。
3、实时性和延迟
目前公开信息里没有提到流式合成延迟、首字响应时间等工程指标。对实时语音对话场景来说,这些指标和模型质量同等重要。希望后续团队能公布更详细的工程性能数据。
⏩开发者视角:怎么用?
对技术开发者和企业用户来说,大家最关心的是怎么接入:
- 技术博客完整版:https://lingx.cn/tts.html
- Playground体验:LingX-TTS已开放在线Playground,可以直接在浏览器里体验语音合成、声音设计、智能配音等功能。
具体的API、调用配额、支持的语言和音频格式等细节,建议直接联系团队获取最新信息。
⏩总结:Voice Design赛道到了什么阶段?
回到开头的问题——当TTS开始“演”角色,这个赛道的技术拐点到了吗?
从LingX-TTS的发布来看,至少可以确认三件事:
第一,Voice Design已经从“参数旋钮”进化到“场景理解”。 早期的Voice Design工具是给你一堆滑块——音调、语速、情绪强度,你自己调。现在的方向是:你给一段场景描述,模型自己理解这个场景应该用什么声音。这是从工具到助手的变化。
第二,数据+RL的技术路线正在成为行业共识。 不管是ElevenLabs还是LingX-TTS,高表现力TTS的突破都不是靠更大的模型,而是靠更精细的场景化数据和更聪明的训练范式。数据质量和训练方法,比单纯堆参数重要得多。
当然,Voice Design TTS还远没到终点。长文本一致性、实时对话中的表现力保持、多角色对话的声线管理、更自然的副语言生成……这些问题都还需要时间解决。但至少,LingX-TTS证明了:让AI像人一样自然地说话,不再只是科幻电影里的画面。
资料来源:聆芯智语官方LingX-TTS技术报告。本文为语音之家三方技术解读,观点仅供参考。
