
 语音小管家
以下文章来源于SIGCHI XI AN
当一个人说“我很好”时,文本传递着积极含义,语调却逐渐低沉,面部表情又在某个瞬间短暂僵住——模型究竟应该相信哪一种信号?
核心观点 情绪并非静态峰值的集合;可靠的多模态理解,需要先读懂变化的过程,再决定融合的方式。
传统多模态情感分析往往把重点放在“如何把文本、语音和视觉融合得更深”。但真正棘手的问题可能发生得更早:三种模态的可靠性并不是固定不变的,情绪的关键证据,也常常隐藏在转折、迟滞与不同步出现的瞬间。
Temporal Calibration Network(TCaN)由此提出一个更本质的问题:在让模态彼此交互之前,模型能否先判断“此时此刻谁更可信”?它并不把时间仅仅当作特征编码的附加维度,而是把时变模态显著性提升为一个需要被显式估计、校准并用于指导融合的中间决策变量。
| 论文题目 | TCaN: Temporal Calibration Network for Dynamic Multimodal Sentiment Analysis with Adaptive Modality Fusion |
| 作者 | Yuxuan Hu, Yushan Pan*, Xiaojiang He, Xinfei Guo, Hao Wang, Kaiwei Wang, Yanlong Cao, Zhijie Xu |
| 发表信息 | Accepted for publication in IEEE Transactions on Affective Computing |
| DOI | 10.1109/TAFFC.2026.3726067 |
问题不在“看不到时间”,而在“融合决策仍然静态”
近年来,LSTM、Transformer和跨模态注意力已经让模型能够编码长短期依赖。换句话说,许多方法并不缺少时序特征。问题在于,承载这些特征的融合逻辑仍可能停留在静态世界:有的方法为整段话分配一次模态权重,有的方法则把“谁重要”和“如何交互”混在同一个注意力或门控操作里。即使输入特征足够丰富,一个不合时宜的权重仍可能让模型在关键瞬间做出错误判断。
这种矛盾具体表现为三条相互关联的错位。第一,文本、声音和表情的贡献会随时间转移,固定权重无法跟上这种变化;第二,微表情先于话语、语调滞后于词义等跨模态异步,常被当作需要消除的噪声,但它们恰恰可能是反讽、迟疑或情绪转折的证据;第三,不同模态有不同的节奏——语言语义是离散且上下文驱动的,声学信号变化更快,视觉表情通常更平滑——用同一个时间窗口处理三者,容易把各自独特的动态模式抹平。
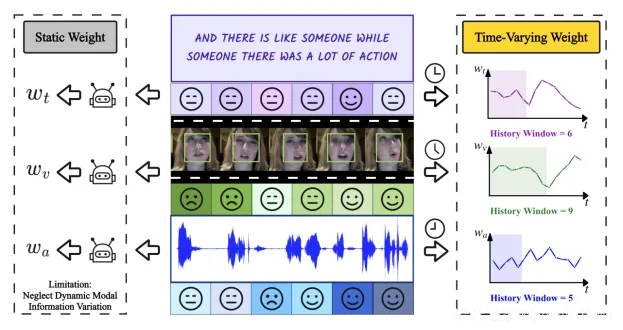
【图 1|静态权重与时变权重范式对比(原论文 Figure 1)】
TCaN背后的设计哲学可以概括为“process over apex”:情绪的真实性不只存在于某个峰值时刻,更存在于它如何形成、转折和消退的过程中。因此,模型不仅要观察“这一帧表达了什么”,还要追踪“它是怎样走到这一帧的”。
先校准“该相信谁”,再决定“如何融合”
TCaN的关键并不是并排放置三个功能模块,而是重新安排多模态推理的先后顺序:先保留各模态的时间证据,再形成初始显著性判断;随后检验这一判断是否得到情绪转折与时序关系的支持;最后才把经过校准的指导信号注入跨模态交互。表示信号与融合指导信号沿两条路径同步推进,并始终保持同一时间分辨率。
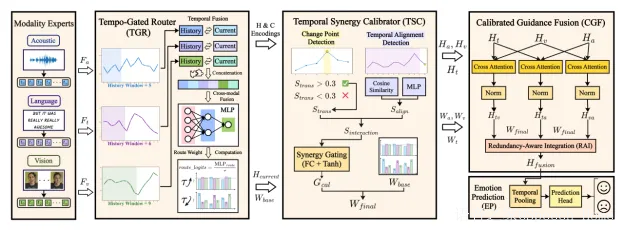
【图 2|TCaN 整体架构(原论文 Figure 2)】
先让每种模态按照自己的节奏回看历史
在每个时间步,模型首先需要回答:当前信号放在它自己的历史中,究竟有多重要?Tempo-Gated Router(TGR)没有强迫三种模态共享同一感受野,而是为文本、音频和视觉设置独立的历史窗口。论文在验证集上得到的窗口分别为6、5和9:文本使用适中的上下文,音频用更短的窗口跟踪快速韵律变化,视觉则用更长的窗口捕捉缓慢连续的表情演化。
历史状态与当前状态被分别编码后,模型通过轻量级跨模态汇聚形成全局上下文,再用温度缩放的Softmax输出逐时间步的模态显著性。这里得到的权重不是最终分类分数,也不是新的特征表示,而是一个明确的融合指导信号:它告诉后续交互,在这一时刻应当给每种模态多少信任。
再问:这个变化是真正的情绪转折,还是随机抖动?
仅仅发现“变化很大”还不够。一次声学突变可能来自情绪爆发,也可能只是背景噪声;一帧面部变化可能是有意义的微表情,也可能是偶然运动。因此,Temporal Synergy Calibrator(TSC)进一步从两个互补角度检查初始权重:一方面利用潜在表示的一阶变化刻画情绪转折强度,另一方面结合历史—当前的时序一致性与跨模态上下文估计相对对齐关系。
TCaN并没有把两种证据简单相加,而是显式建模它们的交互。直观地说,变化强度回答“发生了多大变化”,时序关系回答“这次变化是否具有可用的结构性证据”。只有两者共同支持时,相关模态才更有理由在当前时刻被放大;缺乏时序支撑的剧烈波动则会被抑制。由此,跨模态异步不再只是等待被校正的误差,也可以成为判断模态可靠性的线索。
最后,才让校准后的判断进入跨模态交互
Calibrated Guidance Fusion(CGF)负责把上一步得到的全局时间先验,注入文本—视觉、文本—音频和视觉—音频的双向交互。局部跨注意力继续负责发现内容相关性,而外部校准信号负责规定不同交互在每个时刻应被强调到什么程度。二者分工明确:注意力回答“信息之间有什么关系”,时间指导回答“此刻哪些关系更值得信任”。
对于每一对模态,TCaN依据两者联合的重要性调节交互强度,随后采用“先充分构造、再冗余压缩”的方式整合三组关系。这样既避免某一个单模态权重独占融合,也避免把全部交互粗暴拼接后交给下游自行消化。更重要的是,TGR、TSC与CGF并非彼此独立的功能拼盘:前一步产生的判断,正是后一步能够可靠工作的前提。
“相信谁”不能只靠模型的自我感觉
为了让显著性权重具有可验证的学习依据,TCaN还在训练阶段引入可靠性感知的联合约束。模型根据各单模态预测残差构造经验可靠性目标,使学习到的指导权重与真实预测能力保持一致;同时使用多层语义监督避免融合退化为“只靠一个模态”,用熵正则抑制权重塌缩,并通过教师辅助蒸馏让融合表示靠近更可靠的单模态流形。于是,“谁更可信”不再是一个完全自由的注意力结果,而是受到预测可靠性约束的结构化判断。
实验真正验证了什么?
论文在CMU-MOSI、CMU-MOSEI、CH-SIMS和MIntRec四个基准上进行评估,覆盖英语与中文情感分析以及细粒度意图识别。TCaN在多个关键指标上取得领先或具有竞争力的结果:在CMU-MOSI上,Acc-7达到52.39,二分类准确率(NP设置)达到88.16%,Corr为0.858;在CMU-MOSEI上,Acc-7达到56.15,二分类准确率(NP设置)达到88.94%,F1(NP设置)达到88.73%;在CH-SIMS上,Acc-5、Acc-3和Acc-2分别达到47.29%、70.61%和84.92%。
在MIntRec上,模型还在“抱怨、同意、建议、安排、安慰、离开”等多个类别中取得最优结果。值得注意的是,这些类别通常具有较强的语用歧义,仅依赖字面信息并不总是足够,这也与 TCaN 强调动态多模态线索的设计动机具有一定一致性。
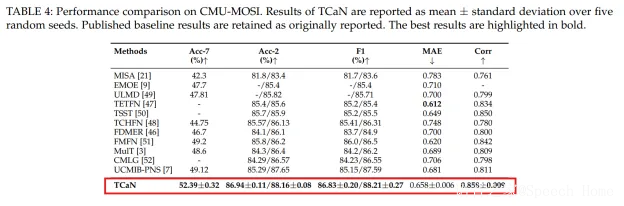
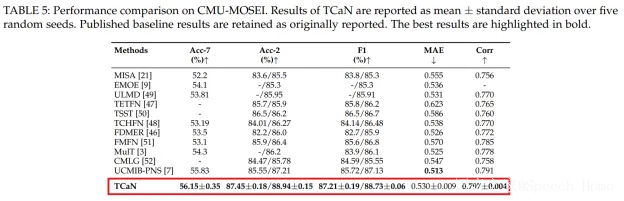
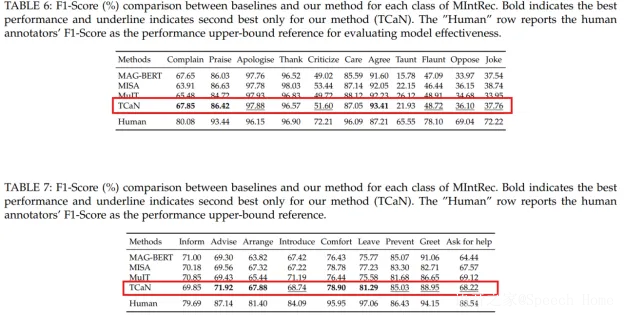
【图 3|TCaN 在多模态情感与意图识别任务上的主要实验结果(原论文 Table 4–7)】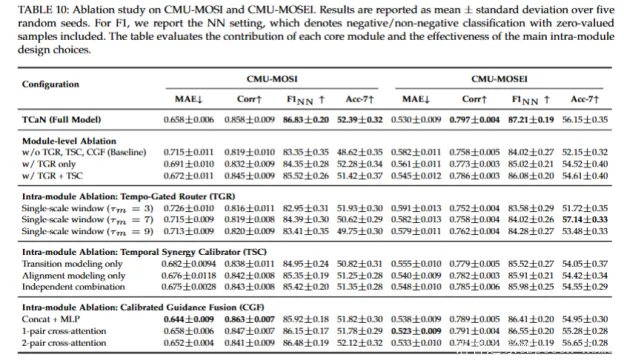
图5|不同时间步的模态重要性变化(原论文 Figure 4)
值得注意的是,完整模型并非在每个单独指标上都绝对占优:例如,Concat+MLP在MOSI的部分回归指标上更好,单尺度窗口 τ=7 在 MOSEI 的 Acc-7 上达到 57.14,高于完整模型的 56.15。因而,TCaN更准确的优势是跨数据集、跨指标的均衡性,以及从问题定义到实验现象的一致性,而不是把每一个子结构包装成“全指标通吃”的性能模块。
可视化进一步回答了“动态权重是否真的在工作”。在Figure 5的正向情感样本中,当“friends”“have a good time”等词语与明显面部行为共同出现时,文本和视觉权重在对应时刻产生局部上升;在信息较弱的区间,相关权重则被压低。最终预测值2.011与真实标注2非常接近。Figure 6的窗口敏感性分析还显示,文本6、音频5、视觉9附近形成平滑而稳定的最优区域,说明异质时间窗口并非依赖某个脆弱的偶然取值。
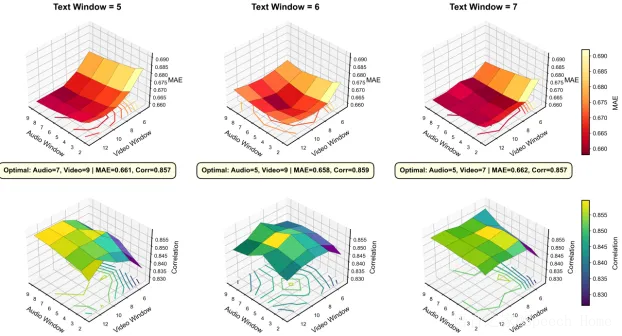
图6|不同模态时间窗口的敏感性分析(原论文 Figure 5)
TCaN的优势,不只是更高的分数
第一,问题定义更靠前。TCaN没有把动态性局限在编码器内部,而是把“时变模态显著性”定义为跨模态交互前必须求解的指导变量。这一改写直接触及静态融合的根源:不是等预测出错后再校准结果,而是在信息真正发生交互之前校准信任关系。
第二,动态权重背后有一条可解释的证据链。不同时间窗口解释了模态为何拥有不同节奏,转折强度与时序关系解释了权重为何在某个时刻变化,可靠性约束又解释了模型凭什么学会“相信谁”。因此,最终权重不是一个难以追溯的黑箱分数,而是与情绪形成过程对应的中间判断。
第三,提升并不依赖大规模参数堆砌。排除预训练BERT后,TCaN包含13.11M可训练参数,其中TGR仅新增0.51M参数;FLOPs由9.690G小幅增加到9.723G。这说明主要增益来自架构中的决策顺序与归纳偏置,而非简单扩大模型容量。与此同时,逐时间步路由也带来了明显的实际运行开销,论文对此保持透明,并把并行化路由与更高效的时间建模作为后续优化方向。
结语:在正确的时间,相信正确的模态
TCaN真正值得关注的地方,不是又为多模态模型增加了几个带缩写的组件,而是改变了融合发生的逻辑:先让每种模态保留自己的时间节奏,再判断当前变化是否可信,最后才让校准后的信任关系指导信息交互。这条链路把“情绪是一段形成过程”落实为可计算的模型结构。
从这个角度看,多模态情感分析的下一步或许不只是融合更多信息,而是学会在正确的时刻相信正确的信息。未来,TCaN还计划进一步探索可自适应调整的时间窗口,以及跨模态情绪转折中的因果方向,让时间校准从经验有效走向更具解释力的动态多模态推理。
