
 语音小管家
实时语音交互最怕的,不只是“没听懂”。
更危险的是:话音刚落,系统已经执行了错误指令;几百毫秒后识别结果又改了,但动作无法撤回。
当 Voice Agent 开始控制设备、调用 API、触发工作流,ASR 输出就不能再“边猜边改”。它既要足够快,也要做到:一旦提交,绝不回退。
自变量机器人推出并开源 X2Streaming-ASR:模型不再按固定窗口机械等待,而是自己判断——
不确定时继续听,准备好时立即说。在不可回退的流式设定下,中文平均发射延迟为 32–109 ms,英文为 12–85 ms;同时在多个中英文测试集上取得最优或次优 CER/WER。
这背后真正解决的,不只是“识别什么”,而是一个长期被低估的问题:什么时候,模型才应该把结果交出去?
论文:X2Streaming-ASR: wait when uncertain, emit when ready for streaming ASR作者:Zhiwei Lin, Kaiqi Fu, Rime Wen, Zehan Liu, Shawn Qin, Roy Gan, Hao Wang, Qian Wang单位:自变量机器人(XSquare Robot)论文链接:https://arxiv.org/abs/2609.08672开源代码:https://github.com/X-Square-Robot/X2Streaming-ASRHugging Face:https://huggingface.co/x-square-robot/X2Streaming-ASR-4B-1009
01|先看 Demo:谁更早交出可靠结果?
看 Demo 时,只需要关注一件事:哪个模型最早提交了不会再修改的正确文本?
参考字幕中的彩色字块,表示最先可靠提交该字或词的模型:X2Streaming-ASR 为青色、Qwen 为蓝色、R2T2 为橙色、X-ASR 为紫色。颜色一旦确定,就不再改变。
右侧错误率只统计播放时间 1.5 秒前已经结束的字幕,并与各模型当前已提交文本的对应前缀比较,避免把“还没来得及说完”误算成错误。显而易见的是,X2Streaming-ASR出字速度最快,同时保持优秀的识别性能。
02|为什么“不可回退”比“看起来很快”更重要?
不少流式 ASR 会先输出一个猜测,再随着新语音到来不断改写。做实时字幕时,这只是文字闪烁;但当识别结果直接驱动 Agent 和工具调用时,代价完全不同。
- 字幕可以改,已经发出的 API 请求不能改;
- 文本可以回滚,已经执行的设备动作不能回滚;
- 多等几百毫秒影响体验,过早提交错误结果则可能影响安全。
X2Streaming-ASR 因此采用 append-only 输出:只追加,不改写。每次提交都相当于一次“硬承诺”。
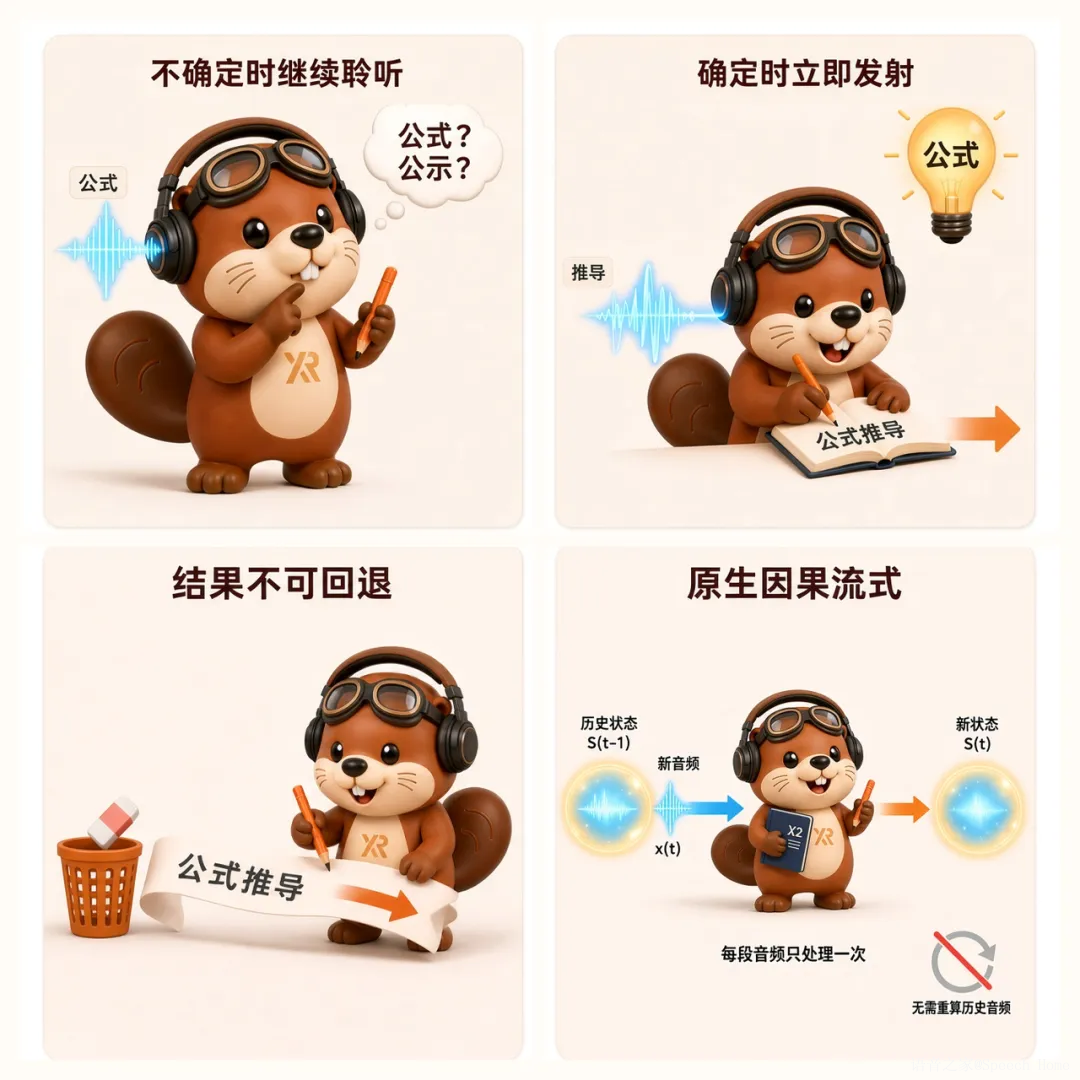
它有四个关键特点:
- 犹豫时多听一会:存在同音、歧义或上下文不足时,保持 LISTEN。
- 确定时立即发射:信息充分后立刻进入 DECODE,不死等固定窗口。
- 提交后绝不回退:已输出文本保持不变,可以直接交给下游系统。
- 只计算新增音频:通过因果流式编码和 KV Cache 复用历史状态,无需反复计算完整音频。
一句话概括:X2 追求的不是“最早出字”,而是“最早给出可以放心使用的字”。
03|核心机制:把流式识别拆成两个问题
传统流式 ASR 常见两种选择:
- 为了快,边猜边改;
- 为了稳,所有位置都等待同样长的固定窗口。
X2Streaming-ASR 换了一种思路,把任务拆成:
- 何时提交:当前信息够不够?继续 LISTEN,还是切换到 DECODE?
- 提交什么:进入 DECODE 后,把新增音频识别成什么文本?
模型每隔 80 ms 做一次 Wait/Emit 决策。信息不足就继续听;信息充分就立即识别新增内容,然后回到监听状态。
“提交什么”是监督学习擅长的识别问题。真正困难的,是让模型学会“何时提交”。
04|为什么不能直接用 SFT 学提交时刻?
直觉上,只要给每个字标一个“正确提交时间”,再做 SFT 就可以了。但这个方案有三个根本问题。
声学边界,不等于最佳提交时刻
强制对齐只能告诉我们一个字何时发音结束,却不能说明模型何时已经听明白。简单位置可能刚结束就能提交;同音或上下文有歧义的位置,则需要再听一小段。
搜索出来的时间,也不是唯一答案
可以借助 ASR 模型遍历探索每个字首次识别正确的时间,但结果会受到模型语言先验和搜索方式影响。它适合热启动,却不是唯一最优策略。
SFT 模仿标签,却不直接优化“准与快”
比标签更早且识别正确,本应得到奖励;稍晚一点但避免错字,也可能是更好的决策。SFT 只会惩罚“偏离标签”,无法直接衡量这两种价值。
所以,SFT 能教会模型模仿时间点,却很难教会它根据上下文权衡准确率与延迟。
05|三阶段训练:先会听,再会判断
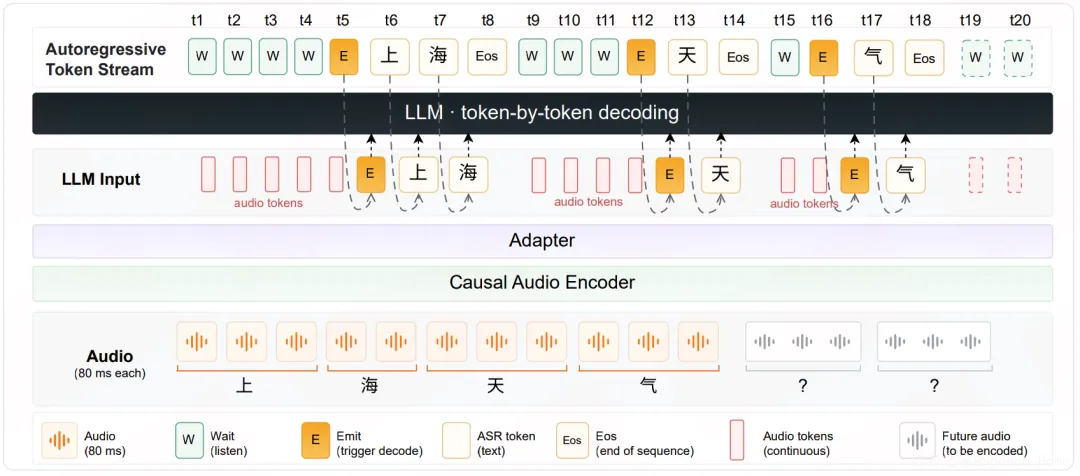
X2Streaming-ASR 模型图
X2Streaming-ASR 基于 Voxtral Realtime 改造,训练分为三个阶段。
第一阶段:建立增量识别能力
使用 Qwen3-ForceAligner 获取字级起止时间,再按 1–6 字随机切分句子与音频块,让模型先学会:给定新增音频,正确识别对应文本。
第二阶段:热启动 Wait/Emit 决策
用第一阶段模型遍历每个参考字,将“首次成功预测”的时间作为初始提交时刻,再通过 SFT 建立基础决策能力。
第三阶段:用 GRPO 真正学习“准与快”
同一句语音采样多条 Wait/Emit 轨迹,以准确率优先、时延次之为目标优化策略。发射延迟定义为:
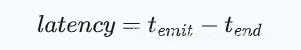
关键设计是按参考字做组内信用分配:为消除歧义而等待的决策得到正向反馈;信息已经足够却继续等待,或过早提交导致错字的决策,则相对更差。
这样,奖励才能落到真正负责某次提交的那串决策上,而不是粗暴地鼓励整句“多等一点”。
06|效果:不是全局少等一点,而是少等一个数量级
X2Streaming-ASR 与 X-ASR、Confucius4-R2T2、Zipformer、Paraformer 等开源流式方案,在公开流式配置下进行了中英文对比。
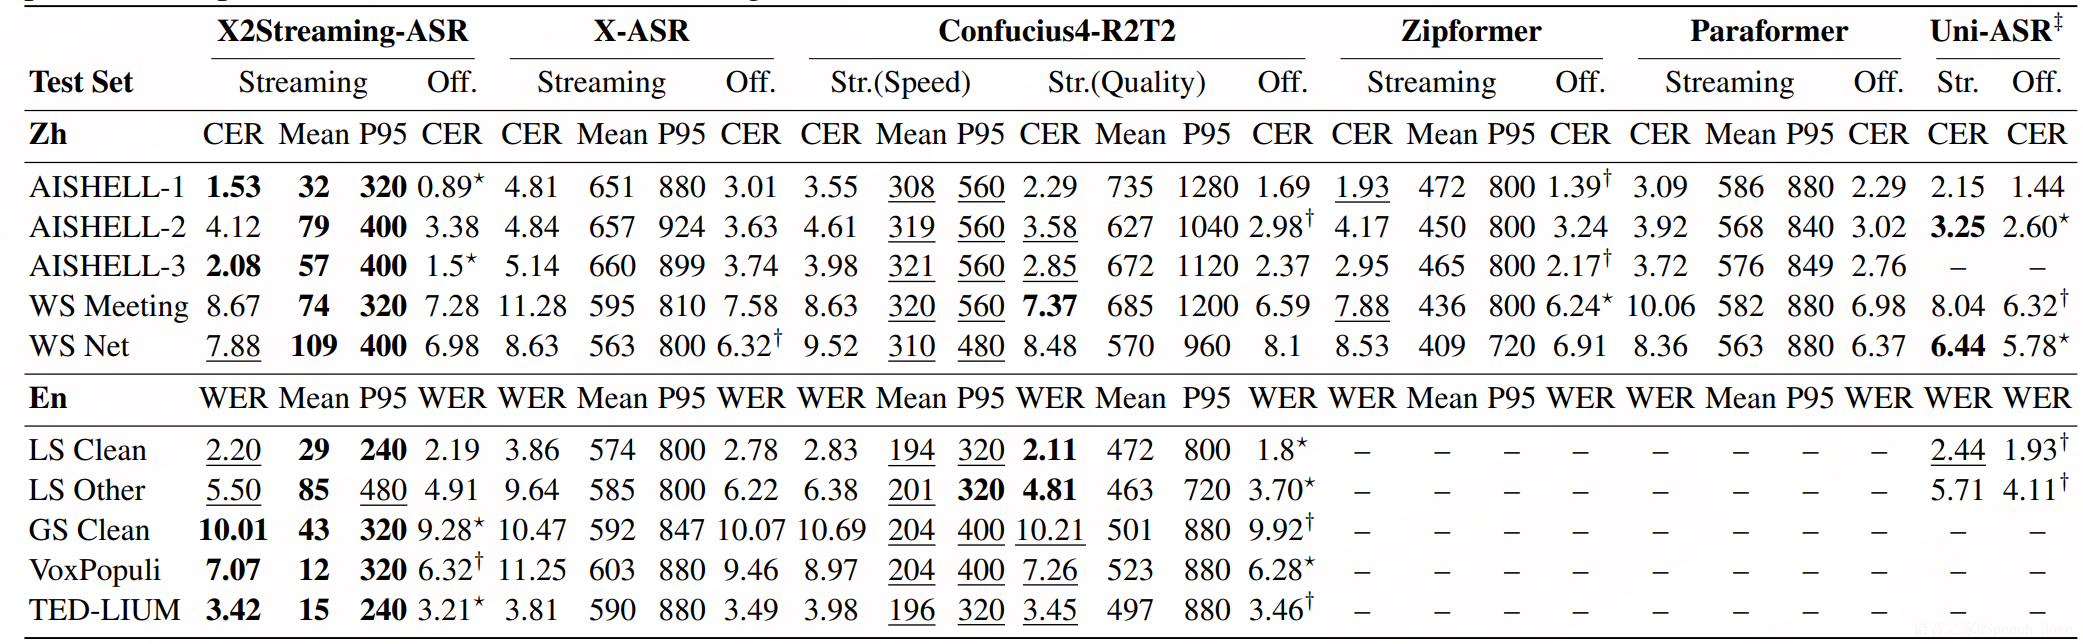
中英文测试对比
延迟:平均仅 12–109 ms
表中的 Mean / P95,统计的是参考字或词到达声学终点后,模型还需要等待多久才提交。
- 中文 AISHELL-1:平均约 32 ms
- 英文 VoxPopuli:平均低至 12 ms
- 更具挑战的 WenetSpeech Net:平均约 109 ms
- 同表流式基线:多数处于 400–650 ms
这意味着,下游 Voice Agent 可以更早拿到不可撤回、可直接执行的识别结果。
准确率:低延迟没有靠牺牲识别换来
在中文 AISHELL-1、AISHELL-3、WenetSpeech Net 上,X2Streaming-ASR 取得最优识别结果(未开源方案 Uni-ASR 除外);在英文 GigaSpeech Clean、VoxPopuli、TED-LIUM 上取得最优结果,在 LibriSpeech Clean 与 Other 上取得次优结果。
快,不是因为更敢猜;准,也不是因为统一多等。
07|模型真的学会“该等才等”了吗?
为了排除“模型只是学会了一个全局准确率—延迟折中”的可能,研究团队在 AISHELL-1 上做了固定前瞻实验:把每次提交强制设为参考字结束时间再加一段固定等待。
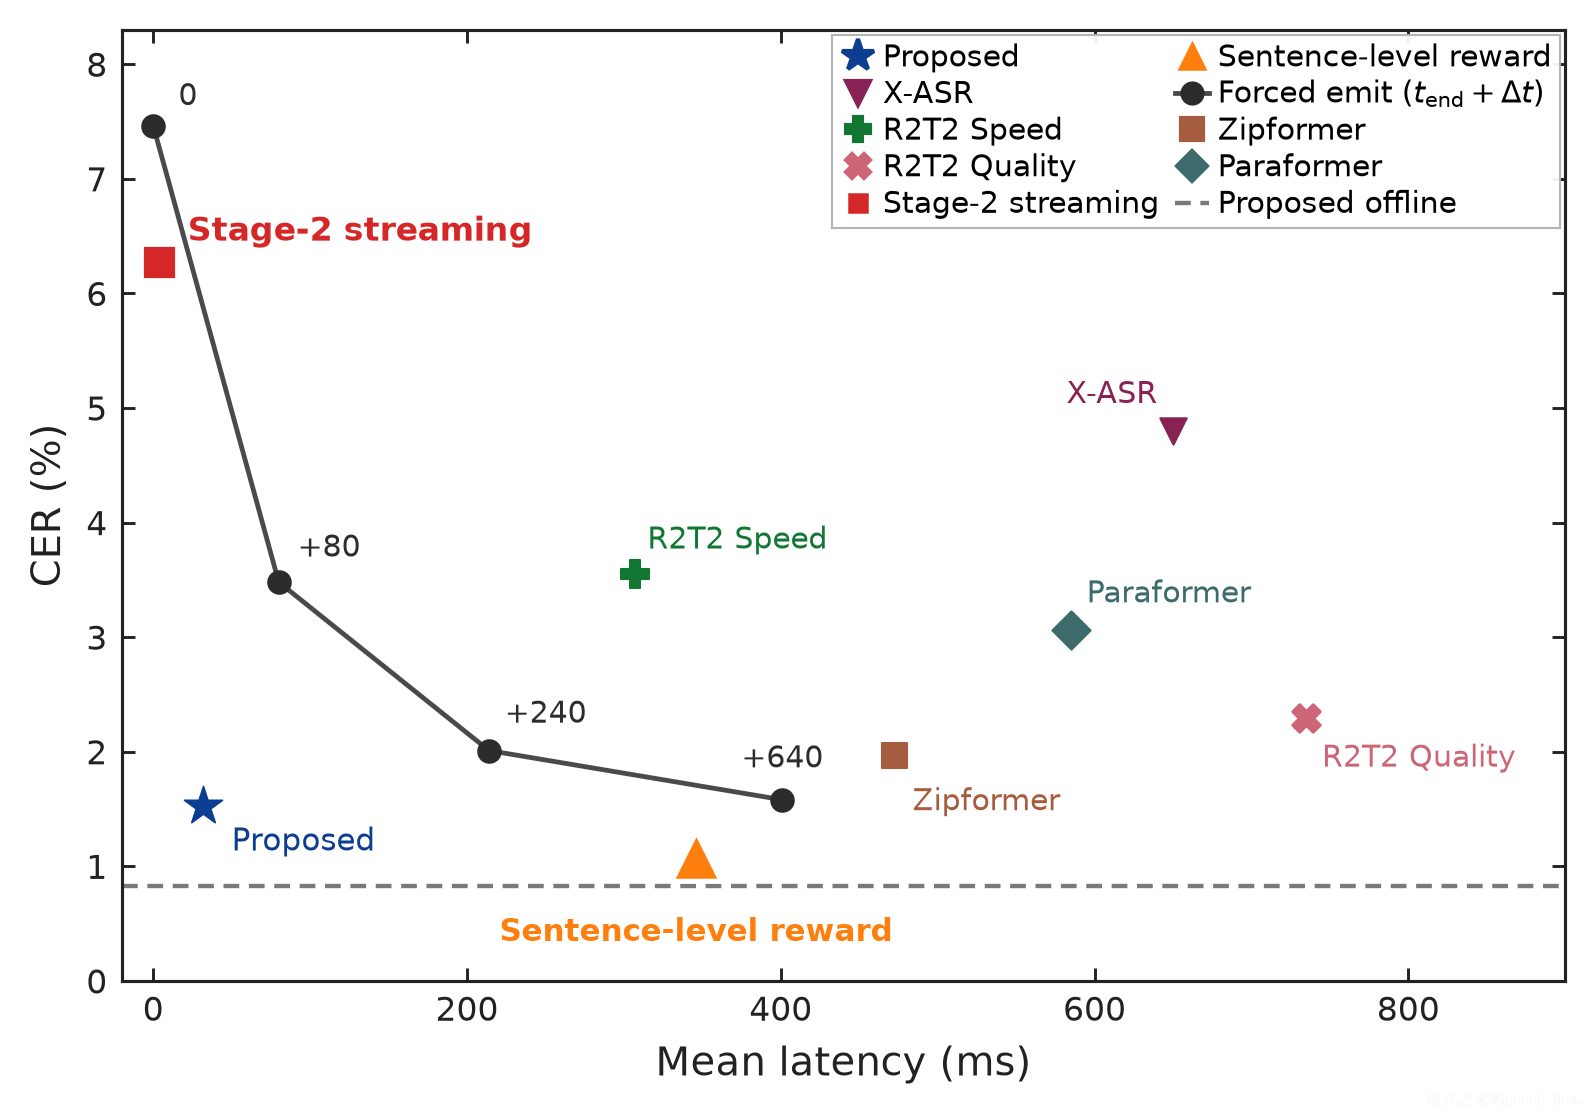
AISHELL-1 测试集上的时延-CER 曲线
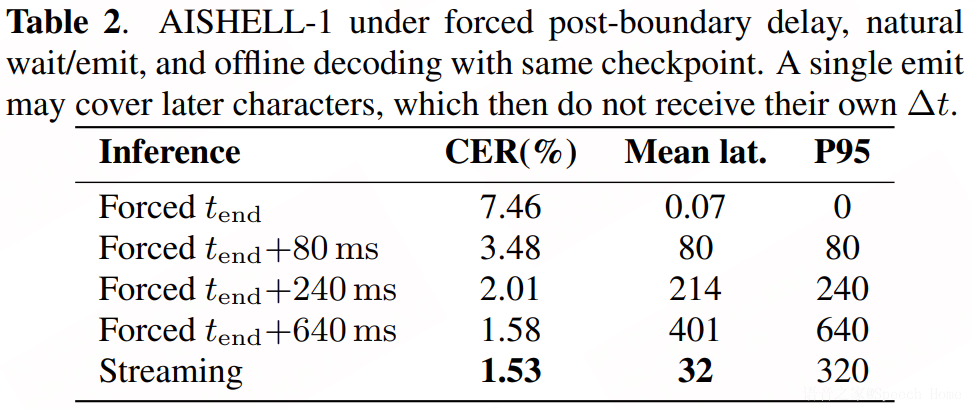
AISHELL-1 固定前瞻强制识别结果
结果很直观:
- 自然流式解码:1.53% CER,平均延迟 32 ms;
- 固定增加 640 ms 前瞻:1.58% CER,平均延迟 396 ms。
为了达到相近准确率,固定前瞻付出了约 13 倍的平均等待。
更关键的是,自然解码结果并不落在固定前瞻形成的折线上。说明模型学到的不是“所有位置统一多等或少等”,而是:简单处尽快提交,歧义处多听一点。
08|消融告诉我们:提升主要来自提交策略
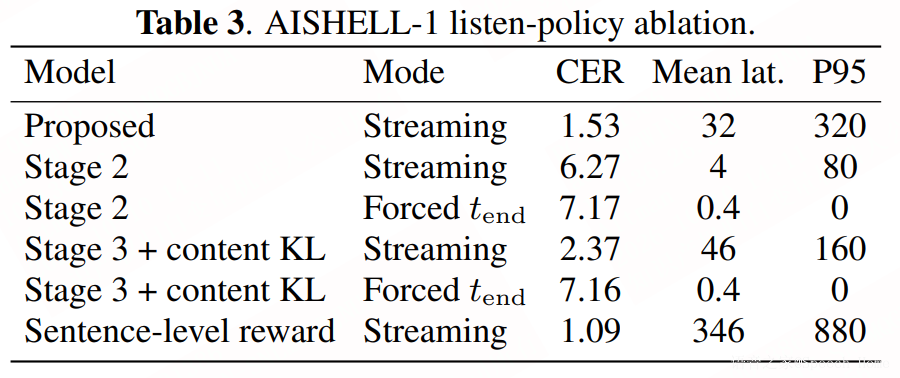
消融实验
两个结果最值得关注。
句级奖励会把模型推向“整句多等”
句级信用分配能把 CER 降至 1.09%,但平均延迟升至 346 ms、P95 达到 880 ms;同一消融设置下,字级信用分配模型为 1.53% CER、32 ms 平均延迟。
原因是句级奖励无法区分“为消歧而等”和“信息够了还在拖”,很容易把所有 Wait 一起加强。
主要收益来自“更会提交”
加入 content KL、把识别能力锚定在第二阶段附近后,流式 CER 仍从 6.07% 降至 2.07%;而强制在字结束处提交时,CER 与第二阶段几乎一致。
这说明第三阶段的主要收益,来自提交策略的优化。完整模型进一步达到 1.65%,则表明识别能力与提交策略协同优化还能带来额外提升。
注:本节为消融实验设置,数值不应与上一节主结果配置直接横向比较。
09|写在最后:让机器听清再行动
当语音只用于转写,“边猜边改”尚且可以接受;当语音开始驱动设备、工具和 Agent,稳定提交本身就成为一种基础能力。
X2Streaming-ASR 希望解决的,正是实时语音交互中的这一步:
不确定时等待,准备好时发射。听清再行动,确定即响应。
项目现已开源,欢迎 Star、试用和提交 Issue。
