
 语音小管家
以 GRPO、DAPO 等算法为代表的可验证奖励强化学习(RLVR)已成为提升大语言模型推理能力的主流范式之一。这类方法仅依赖最终答案是否正确来给出二元奖励,简单、可扩展、抗奖励 hacking,却在推理链越来越长的复杂任务中表现不尽如人意:整条轨迹只收到一个结果信号,难以区分哪些中间步骤有效、哪些步骤出现了偏差。
这种稀疏的奖励导致了一些结果与推理过程错配的情况。如图 1 所示,当答案错误时,也许只是最后一步失误或格式错误;当答案正确时,也可能存在冗余思考或直接猜答案。这种只看结果的奖励机制,让长链推理的信用分配问题始终存在。本文解读的 ConsensusBench 与其对应的 ConsensusPR 正是针对这一问题给出的系统性方案:把最终答案奖励“拆解”成推理路径上可验证的共识节点,让过程监督与结果监督协同工作,从而提供更细粒度的奖励。
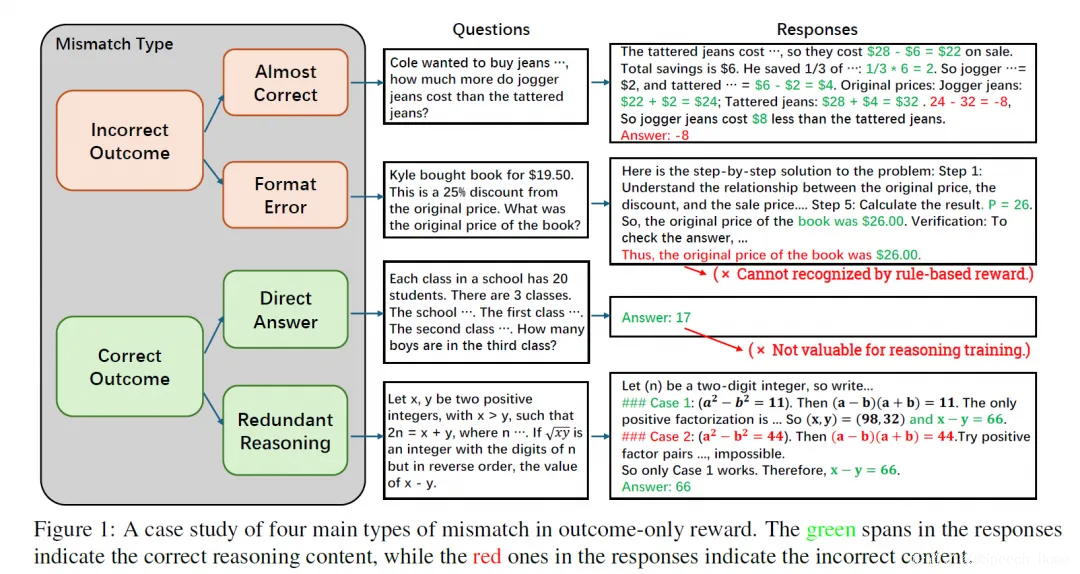
(图 1:模型推理中可能存在的几种结果与过程质量错配的情况)
▎ConsensusBench:基于共识节点的可验证过程奖励数据集
该研究提出的 ConsensusBench 建立在一个核心观察之上:任何复杂问题的正确解答,都可以分解为一组少量但关键的中间结论;不同正确轨迹虽然在表述风格上千差万别,却往往会经过共同的中间步骤。 这些高共识的中间结论被称为共识节点(Consensus Nodes)。
与需要人类或模型逐 step 打分的传统过程奖励模型(PRM)不同,共识节点继承了结果奖励的核心优势——二元、可验证、目标导向。它既不做风格判断,也不强制单一路径,而是把“是否到达关键子结论”作为与最终答案奖励方向一致的细粒度信号。
共识节点如何构造?
ConsensusBench 的节点构建不依赖逐步人工标注,主要分为三个阶段:
- 阶段一:采样与过滤。 对每个问题采样 N 条轨迹,只保留最终答案正确的轨迹;
- 阶段二:节点抽取与表达式扩展。 使用开放模型从正确轨迹中抽取反复出现的关键概念、公式或命题,并将其改写为多种等价表达式,提升后续规则匹配的鲁棒性;
- 阶段三:节点精炼。 剔除复述题目或回顾定义等弱监督的节点,优先保留包含数值与公式的高可验证性、高监督价值节点。
最终,每个问题 q 对应一个有序的共识节点集合 Node(q) = {node₁, ..., nodeₖ}。
数据集与评测指标
ConsensusBench 基于多个公开数学数据源,其中 MATH-500、GSM8K、AIME-2024、AIME-2025 作为测试集,部分 DAPO-Math-17K 作为训练集,并在这些问题的基础之上,构建了对应的共识节点数据,提供相应的过程监督信号。
为综合"最终答案"与"中间过程"两个层面诊断模型表现,研究提出了三个核心指标:
- Acc(Final Answer Accuracy): 传统最终答案的回答准确率;
- NCR(Node Coverage Rate): 模型轨迹覆盖到的共识节点比例,是结果准确率落实到过程子结论层面的直接映射;
- TPN(Tokens per Node): 到达下一个共识节点平均需要的 token 数,衡量模型的推理效率。
▎ConsensusPR:把共识节点信号嵌入 RLVR
共识节点作为过程的标签,可以用来评估模型的推理质量,那能否用于模型的训练阶段?作者针对这一问题进一步提出 ConsensusPR,在不改变现有 RLVR 框架基础上把节点监督信号直接融入奖励设计。
训练时如何匹配节点?
在 RL 训练过程中,对每条采样轨迹,使用基于规则的软匹配策略判断其回复是否涉及了每个共识节点。由于节点主要由公式、方程、关键数值和命题构成,研究对文本进行规则化归一(统一乘号、分数格式、变量命名等),从而快速、稳定地计算 Node Coverage Rate(NCR),并直接作为过程奖励分数。
三种奖励融合策略
为系统性比较和验证过程奖励与结果奖励的融合效果,研究设计了三种 ConsensusPR 形式:
1. Linear 线性融合
r_linear = α · Acc + (1 − α) · NCR
用超参数 α 直接线性平衡最终答案准确率与节点覆盖率。α=0.5 为默认设置。
2. Max 结果优先
r_max = max{Acc, NCR}
当最终答案正确时直接获得满分;仅当答案错误时才回退到节点匹配奖励。这种设计防止模型在难题难以答对的条件下,为了刷节点分而故意拖延给出最终答案。
3. CL 课程学习
第一阶段仅使用节点覆盖奖励,让模型先专注于中间推理质量;固定在一个 epoch 之后,进入第二阶段切换到纯结果奖励,引导模型把中间能力收敛到正确最终答案上。
三种策略都保持了与原有 GRPO/DAPO 奖励结构的一致性,无需引入异构的 PRM 评判目标。
▎实验结果:过程信号带来了稳定的性能收益
实验在 Qwen 3 系列模型上展开,在多个数学基准上进行测试,分别对比了 Vanilla GRPO、 DAPO 与加入三种 ConsensusPR 后的效果。关键结论如下:
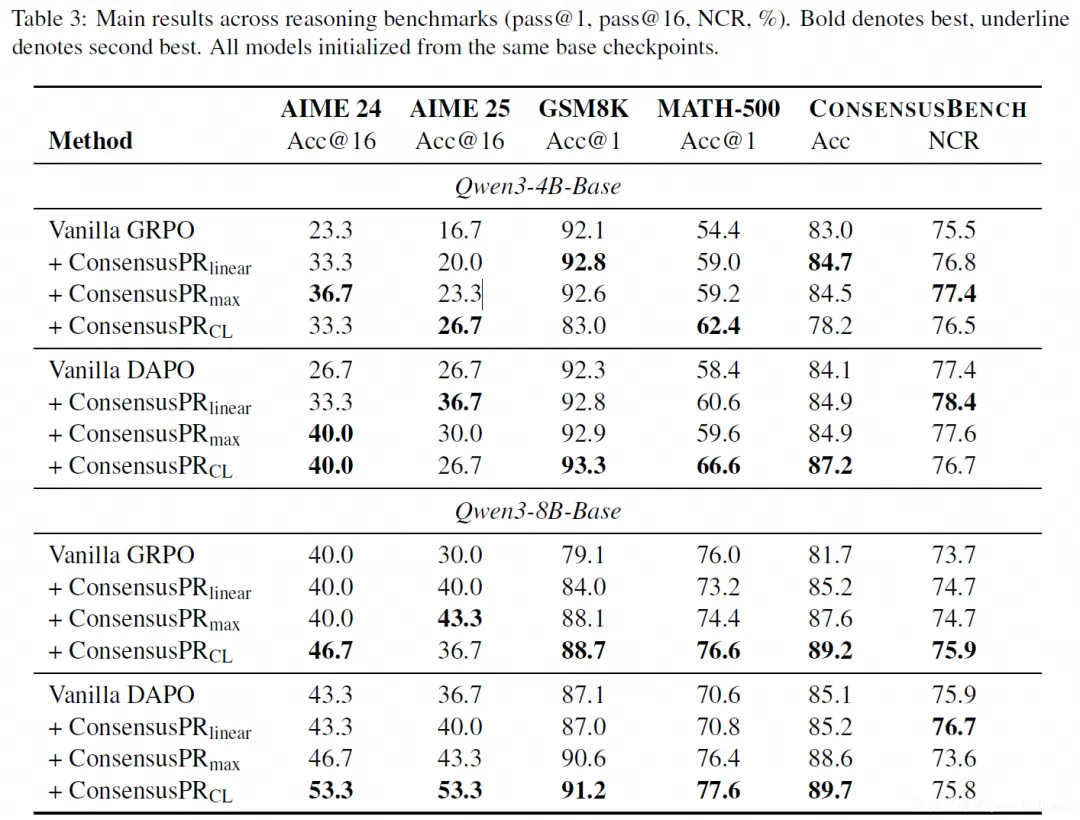
(表 1:各数学推理基准上的主要结果)过程奖励带来的稳定提升: ConsensusPR 与对应的 RL 算法相比,唯一的区别在于融合了过程奖励。不同组别中,三种融合策略在各项基准下取得了一致性的提升,验证了共识节点数据本身的可靠性。提升随难度增加而更明显:相比于简单数据集 GSM8K ,ConsensusPR 在 MATH-500 尤其是困难子集、以及 AIME 上增益更为显著。任务越难、推理链越长,结果奖励越稀疏,ConsensusPR 的过程监督价值就越突出。
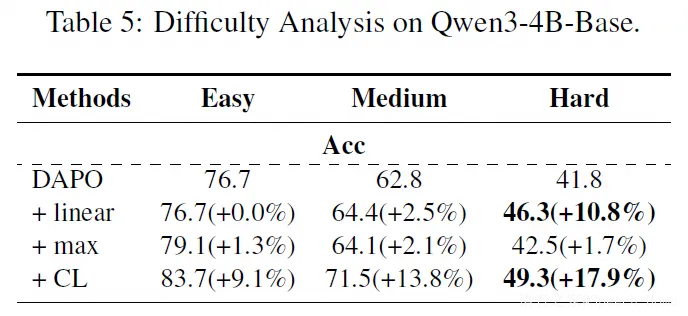
(表 2:MATH-500 不同难度子集下的提升收益)提升收益随模型规模扩大:不同规模的模型对比下, ConsensusPR 在 8B 模型上面提升收益更为清晰一致,在兼顾过程与结果上表现更加出色。▎结语大模型推理训练的未来,不只是让模型"碰巧答对",而是让它们在漫长的思考链条中,清晰地知道自己在哪一步偏离了正轨、哪一步走在了正确的共识路径上。ConsensusBench 想做的,正是为长链推理搭建一组可靠的“路标”:不强制唯一路线,只标注所有正确 trajectory 普遍会经过的关键 checkpoint;不给模型增加额外的风格偏好,只保留与最终答案同样可验证的子目标。配合 ConsensusPR,这些“路标”被转化为训练信号,让模型在复杂推理中走得更稳、更远。
相关文献参考:
[1] Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu, Junxiao Song, Mingchuan Zhang, Y. K. Li, Y. Wu, and Daya Guo. 2024. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. arXiv preprint arXiv:2402.03300.
[2] Qiying Yu, Zheng Zhang, Ruofei Zhu, Yufeng Yuan, Xiaochen Zuo, Yu Yue, Tiantian Fan, Gaohong Liu, Lingjun Liu, Xin Liu, Haibin Lin, Zhiqi Lin, Bole Ma, Guangming Sheng, Yuxuan Tong, Chi Zhang, Mofan Zhang, Wang Zhang, Hang Zhu, and 16 others. 2025. DAPO: An Open-Source LLM Reinforcement Learning System at Scale. arXiv preprint arXiv:2503.14476.
[3] Hunter Lightman, Vineet Kosaraju, Yuri Burda, Harrison Edwards, Bowen Baker, Teddy Lee, Jan Leike, John Schulman, Ilya Sutskever, and Karl Cobbe. 2024. Let's Verify Step by Step. In The Twelfth International Conference on Learning Representations, ICLR 2024, Vienna, Austria, May 7-11, 2024.
