
 新一代Kaldi
小步快走,早日美美与共!
一、k2 终于有 Pre-compiled Wheels了
你还在为安装 k2 而烦恼吗?你的朋友还在为安装 k2 而烦恼吗?预编译的 k2 Wheels 它终于来了!!!
以后安装 k2 就只需要 3 步了:
第一步确定 pytorch 版本。
>>> import torch
>>> torch.__version__
'2.0.0+cu117'
找到对应的 k2 wheel。
CPU 版本的在这里(https://k2-fsa.github.io/k2/installation/pre-compiled-cpu-wheels-linux/index.html)CUDA版本的在这里(https://k2-fsa.github.io/k2/installation/pre-compiled-cuda-wheels-linux/index.html)。
安装 k2。
# pytorch 2.0, cuda 11.7, python=3.8 的wheel
pip install https://huggingface.co/csukuangfj/k2/resolve/main/cuda/k2-1.23.4.dev20230318+cuda11.7.torch2.0.0-cp38-cp38-linux_x86_64.whl
感谢 huggingface 提供存储空间,感谢军哥为我们赋能!
二、zipformer 可以部署了
Zipformer 的威力试过的朋友们应该了解到了,训练速度和准确率都有了极大的提升,经过团 (jun)队(ge)的不懈努力,zipformer 终于导出到 onnx 和 ncnn,支持高性能部署了!!!
Ncnn 的模型在这里:https://k2-fsa.github.io/sherpa/ncnn/pretrained_models/index.html
Onnx 的模型在这里:https://k2-fsa.github.io/sherpa/onnx/pretrained_models/index.html
带 zipformer 字样的都是!
流式支持
另外,我们也对 zipformer 进行了流式支持,相比我们之前的流式模型,zipformer 参数量更少,效果更好。参考 librispeech 数据集下 pruned_transducer_stateless7_streaming recipe 了解更多细节。
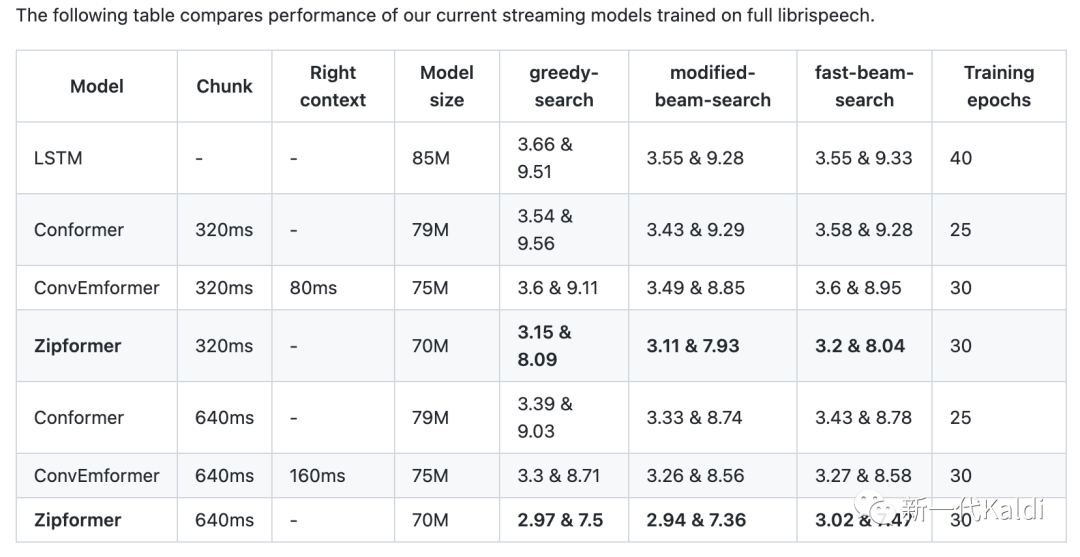
表格中 zipformer 模型在:https://huggingface.co/Zengwei/icefall-asr-librispeech-pruned-transducer-stateless7-streaming-2022-12-29
小模型
我们也尝试了 zipformer 在小模型上的性能,发现 zipformer 又小又能打。
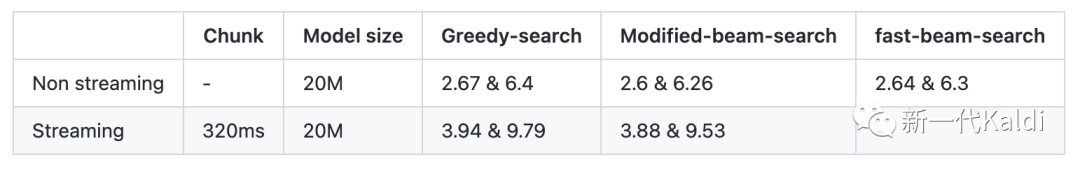
非流式模型在:https://huggingface.co/Zengwei/icefall-asr-librispeech-pruned-transducer-stateless7-20M-2023-01-28流式模型在:https://huggingface.co/desh2608/icefall-asr-librispeech-pruned-transducer-stateless7-streaming-small
三、Transducer 的跳帧解码
跳帧解码简单说就是通过 CTC 头获得的 blank 概率确定 Transducer 是否跳过当前帧。整个系统架构如下图所示:
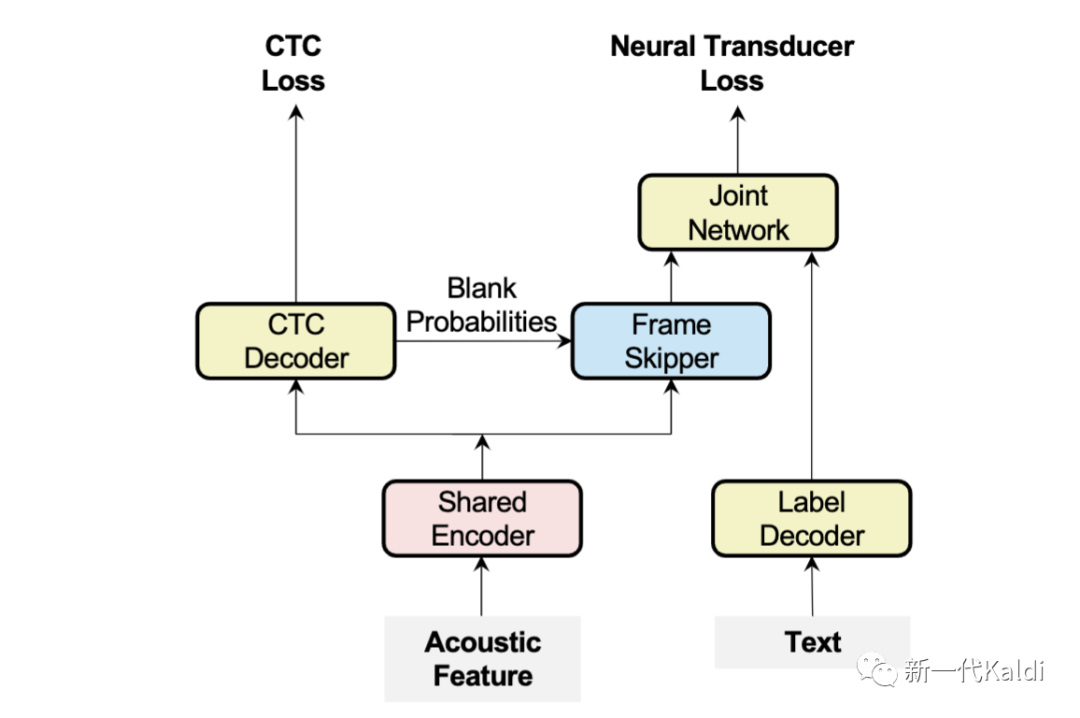
跳帧的目标是在不降低准确率的前提下,尽可能的多跳帧(跳得越多,解码越快)。我们复习一下 CTC 的准则,如下图所示,理论上红框里的 token 都可以是 blank。所以我们提升跳帧率的目标就变成了降低连续相同非 blank 的数量。
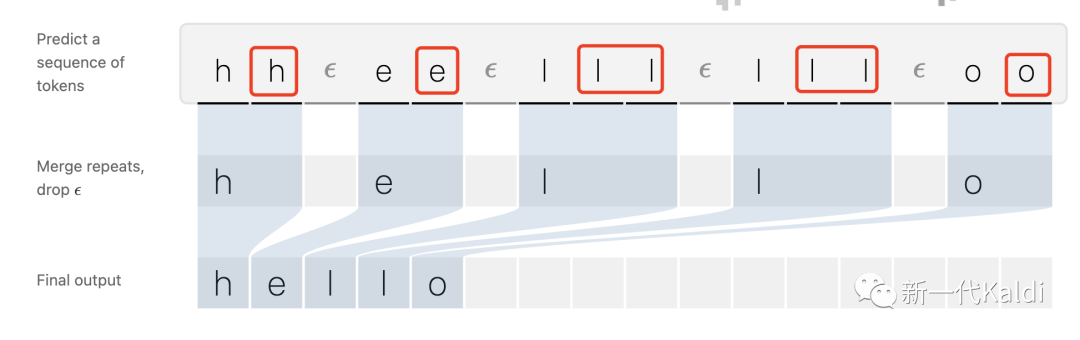
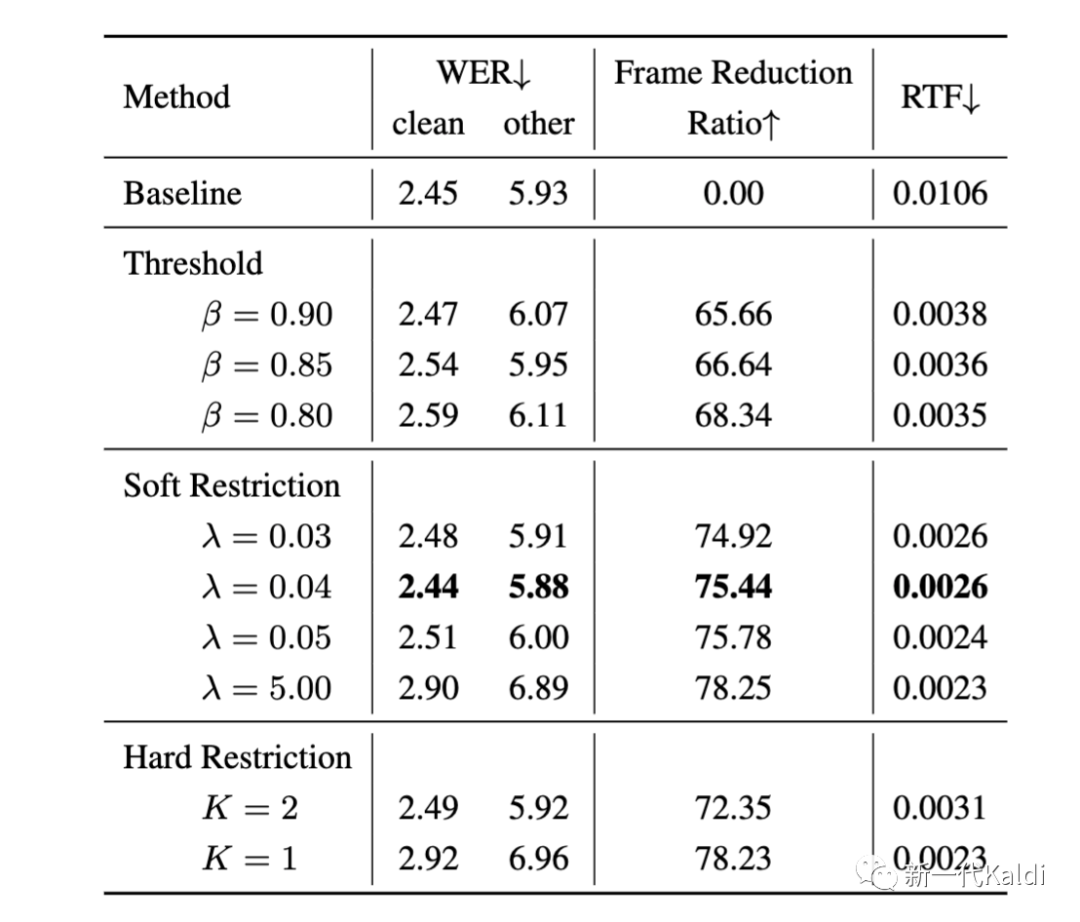
为此我们提出了两种策略,软约束和硬约束。软约束是对输出连续相同的非 blank 加惩罚,输出越多,惩罚越大。硬约束是直接限制连续相同非 blank 的 token 的输出数量。
别问我怎么实现,k2 FSA is all you need,代码请参考 PR:https://github.com/k2-fsa/icefall/pull/933如有需求,小哥哥们也可以专门出一期讲解。
下表是一些实验结果,在不加约束的情况下,跳帧率大概是 66% (尖峰效应牛!),在加入我们提出的约束的情况下,跳帧率能达到近76%(注意准确率是没有一点损失的!),也就是说解码器只需要处理 1/4 的帧了。
四、低时延 CTC 训练
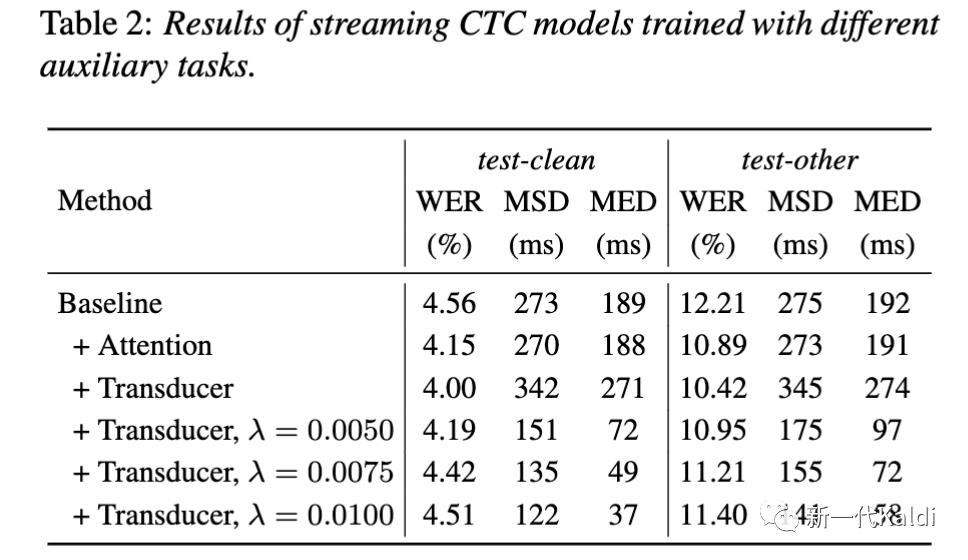
关于 CTC 模型的 delay-penalty 策略,我们之前发过一篇介绍文章Delay Penalty For RNN-T and CTC,这里主要提一点新发现,我们实验发现用 delay-penalized Transducer 替换掉 CTC-Attention 中的 Attention decoder,能实现更好的错误率和时延平衡,而且参数量更少。下表中的 MSD (Mean Start Delay) 和 MED (Mean End Delay) 表示每个词的开始时延和结束时延,越小越好。
细节可参考 PR:https://github.com/k2-fsa/icefall/pull/907
五、微调示例脚本
作为没卡的穷打工人,对微调应该是轻车熟路了,简单说就是大佬们出了一个很爆炸的模型,为了把这个模型白嫖到手在自己的数据集上跑出 SOTA,于是在这个牛X的模型的基础上用自己的数据再训训。比如,我们在 Librispeech 上训了一个好模型,然后想让它在 gigaspeech 测试集上表现好点,于是就用 gigaspeech S 数据集继续在 LibriSpeech 的模型上再训一会。下表的结果就是我刚举的例子。可以看到,微调之后效果提升还是比较明显的。
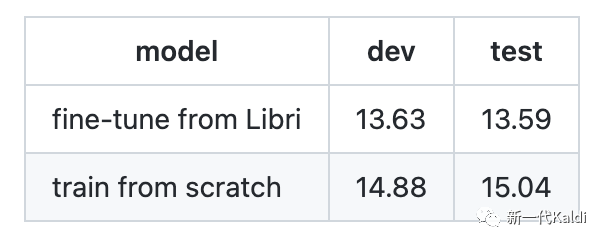
k2 中大部分是在开源数据集上的结果,为了便于大家在自己数据集上使用,我们贴心的提供了微调的程序。
具体代码参考:https://github.com/k2-fsa/icefall/pull/944
六、Sherpa is all you need
再次强烈推荐 Sherpa 给朋友们,性能强劲、模型多多、使用方便、代码漂亮、文档齐全...... 赶快告诉你们老板,你不想吃鱼,你想用 Sherpa!更多介绍请戳👇
Sherpa-ncnn:新一代 Kaldi - 嵌入式端实时语音识别
Sherpa-onnx:新一代 Kaldi 放大招啦
