
 语音小管家
上一期我们介绍了团队推出的高效零样本语音合成模型 ZipVoice,随着 notebook lm 的大火,对话语音合成(播客生成)也火了一把,本期将为你带来 ZipVoice 在零样本对话语音合成上的扩展 ZipVoice-Dialog[1]。ZipVoice-Dialog 解决了现有对话语音合成模型在稳定性和推理速度上的瓶颈,实现了又快又稳又自然的语音对话合成。
ZipVoice-Dialog 模型文件、训练代码和推理代码以及6.8k小时的语音对话数据集OpenDialog已全部开源:https://github.com/k2-fsa/ZipVoice
ZipVoice-Dialog:非自回归对话语音合成
对话语音合成模型可以根据对话文本合成双人对话语音,是AI播客等应用的核心技术,得到了业界的广泛关注。相对单说话人语音合成,对话语音合成需要在一句话中合成不同的说话人音色,且需实现自然且准确的说话人切换,因此更有挑战性。此前的对话语音合成模型均为自回归模型,面临着推理速度慢和合成稳定性差的问题。ZipVoice-Dialog 基于非自回归模型建模,借助ZipVoice 架构的建模能力和针对对话语音的技术优化,实现了又快又稳又自然的对话语音合成。
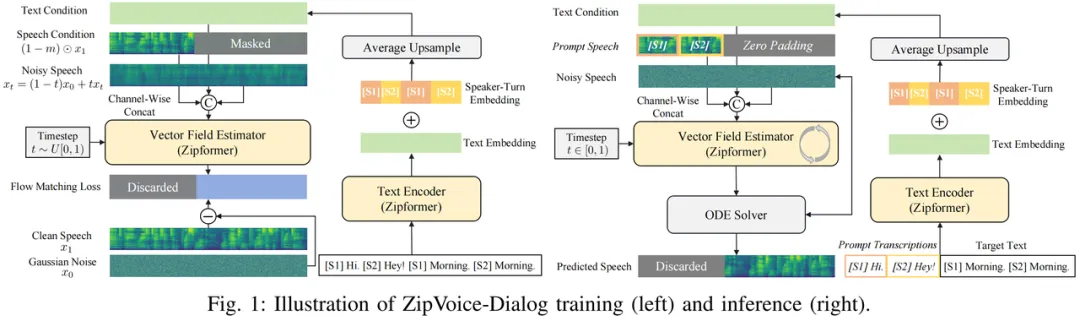
1. 方法介绍
1.1 说话人轮次嵌入向量:精准区分对话角色
对话语音合成中的一个常见的问题是说话人的语音混淆,即在某些说话人轮次中使用了错误的说话人音色,为了解决这一问题,模型引入 Speaker-Turn Embedding(说话人轮次嵌入向量)为模型提供细粒度的精准说话人身份提示,从而降低模型对说话人切换建模的难度。具体来说,首先对输入文本的每个token根据角色匹配其对应的 Speaker-Turn Embedding,然后把 Speaker-Turn Embedding 加在文本 token 的 Text Embedding 上送入主干网络。
1.2 课程学习:从单说话人到对话的稳定迁移
由于对话语音中包含两个说话人音色,其声学上的高复杂度导致文本-语音对齐关系较难学习,为了解决这一问题,ZipVoice-Dialog 采用课程学习策略,使用单说话人语音的预训练解决了对齐难题,具体训练分为两个阶段:
阶段 1(单说话人语音数据预训练):复用 ZipVoice 在 100k 小时单说话人数据集(Emilia)上的权重,夯实语音-文本对齐能力; 阶段 2(对话语音数据微调):在对话语音数据上微调,学习说话人角色切换和自然对话语音风格。
1.3 立体声扩展:双声道对话的沉浸感优化
在一些应用场景下,将双人语音分别分配到不同的声道上可以得到更好的使用体验,我们通过以下技术将 ZipVoice-Dialog 进行扩展,实现了双声道生成功能:
权重初始化:以单声道 ZipVoice-Dialog 模型的权重作为训练起点,其中单声道模型的输入输出投影层的权重通过复制和缩放以适配双声道模型的扩展维度,避免随机初始化导致的性能损失; 单声道语音正则化:训练中交替使用双声道与单声道数据,通过共享核心模型权重,防止过度遗忘单声道语音知识; 说话人互斥损失:由于角色重叠时通常带来语音质量降低,使用了说话人互斥损失惩罚两声道同时发声的帧。
2. 实验结果
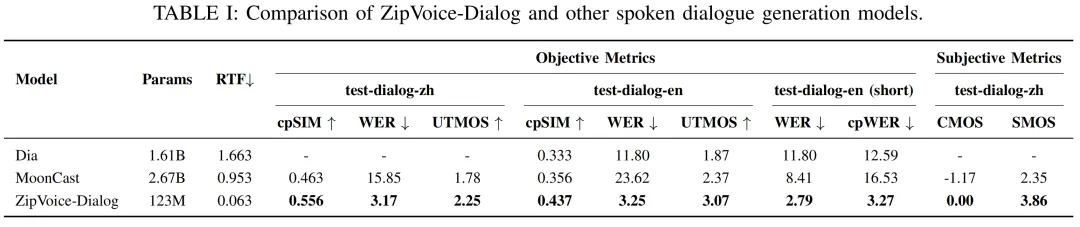
我们在由真实语音对话构建的中英文对话语音合成测试集上对比了 ZipVoice-Dialog 与其他两个对话语音合成模型 Dia [2]、MoonCast [3],实验结果表明,ZipVoice-Dialog 在参数量显著减小和推理速度显著提升的同时,实现了说话人相似度(cpSIM)、词错误率(WER)、语音质量(UTMOS)和说话人转折准确度(cpWER)的显著改善。
OpenDialog:6.8k小时开源对话语音数据集的构建
大规模高质量训练数据是强大模型性能的基础,但对话语音合成领域目前尚无大规模开源数据,极大地限制了相关技术的发展,为了填补这一空白,团队构建了6.8k小时的对话语音合成数据集:OpenDialog。其中包含了1.7k小时的中文数据和5.1k小时的英文数据。为了构建这一数据集,团队采用了如下流程:
对话语音数据挖掘:通过 VAD 过滤非语音段→说话人日志模型标注角色→ASR 转录生成文本→LLM 分类筛选对话内容,从大量音频中提取有效对话语音文件; 带角色标签的精准 ASR 转录:基于 WhisperD [4]模型实现带角色标签的转录,有效解决了传统说话人日志+ASR模型方案在短语音片段(如“嗯”、“对”)上的的识别错误和角色错配问题; 低质量样本过滤:为了保证训练数据质量,一方面采用了一系列人工设计的规则过滤掉 ASR 转写异常的语音数据,过滤规则包括异常的说话人轮次数、非预期的符号、异常的词数时长比、过多的字符重复以及过长的单词等;另一方面,使用了 DNSMOS [5]得分作为语音质量参考,过滤掉得分小于2.8的嘈杂语音。
展望
ZipVoice 系列模型为轻量化、高速度要求的语音交互应用场景提供了新的解决方案。ZipVoice 零样本语音合成模型具备了低参数量、高推理速度、高语音质量三大优点,ZipVoice-Dialog 提供了又快又稳又好的对话语音合成新方案。未来团队将持续对 ZipVoice 系列模型进行优化,致力于让每一个人都能享受到低成本高质量的语音合成技术。
参考文献
[1] H. Zhu, W. Kang, L. Guo, Z. Yao, F. Kuang, W. Zhuang, Z. Li, Z. Han, D. Zhang, X. Zhang, X. Song, L. Lin, and D. Povey, “ZipVoice-Dialog: Non-Autoregressive Spoken Dialogue Generation with Flow Matching,” arXiv preprint arXiv:2507.09318, 2025.
[2] Nari Labs, “Dia: A TTS model capable of generating ultra-realistic dialogue in one pass.,” GitHub, 2025. [Online]. Available: https://github.com/nari-labs/dia.
[3] Z. Ju, D. Yang, J. Yu, K. Shen, Y. Leng, Z. Wang, X. Tan, X. Zhou, T. Qin, and X. Li, “MoonCast: High-quality zero-shot podcast generation,” arXiv preprint arXiv:2503.14345, 2025.
[4] J. Darefsky, G. Zhu, and Z. Duan, “Parakeet: A Natural Sounding, Conversational Text-to-Speech Model,” 2024, Blog post. [Online]. Available: https://jordandarefsky.com/blog/2024/parakeet/.
[5] C. KA Reddy, V. Gopal, and R. Cutler, “DNSMOS P. 835: A non-intrusive perceptual objective speech quality metric to evaluate noise suppressors,” in ICASSP 2022-2022 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), 2022, pp. 886–890.
