
 语音小管家
相较于社区流行的 Faster Whisper 方案,NVIDIA TensorRT-LLM 能有效将推理速度提升 50% 以上; 仅用一张 A10 GPU,Whisper Turbo[1] 的中文微调模型每秒钟可以处理 500 秒的音频; 结合 Qwen2 7B 的 ASR 模型,则可实现 0.027 的 Real Time Factor (RTF) 指标。
本文是新一代 KaldiASR 大模型训练方案的续篇, 介绍新一代 Kaldi Sherpa 中的 ASR 大模型 GPU 推理方案。
方案介绍
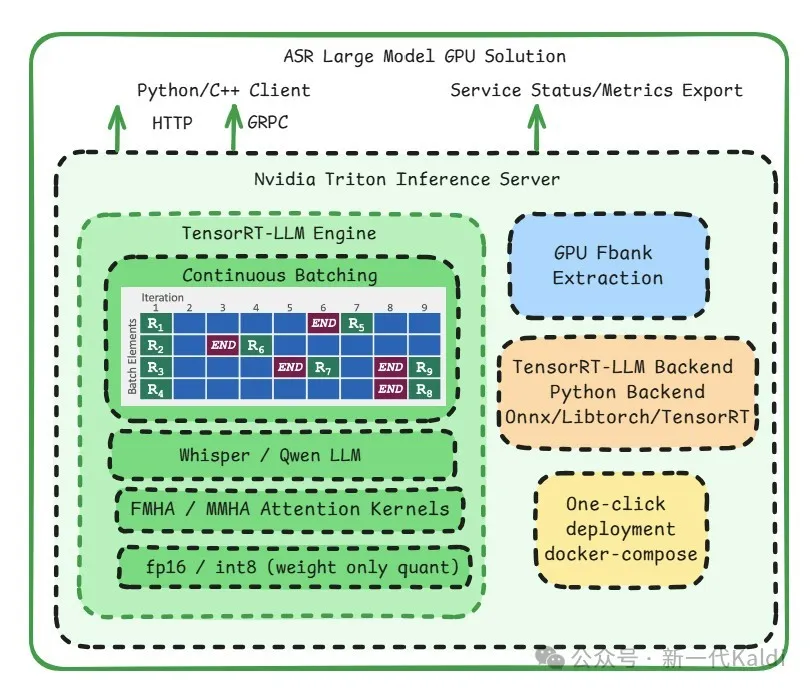
类似 Whisper 或者结合了 LLM 的 ASR 大模型逐渐流行。比起传统模型,更大的参数量和自回归解码的特点让这类模型的推理比较慢。借助NVIDIA TensorRT-LLM[2]和NVIDIA Triton[3]推理服务器,我们开发了针对此类模型的 GPU 推理加速方案。
Whisper
Speech Encoder + LLM
方案性能
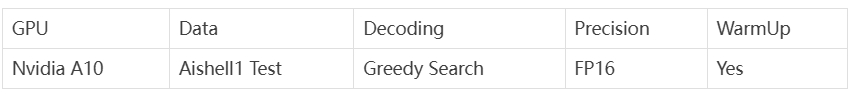
我们分别从 Offline 推理和 Client-Server 推理两种模式对部署方案的性能进行了测试。 测试细节如下表:
Offline 模式
Offline 模式指从本地直接推理音频,不涉及服务部署和请求调度,更多是为了展示推理引擎的性能。
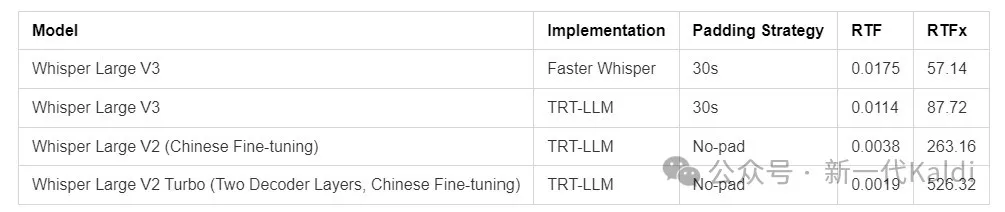 Offline 推理结果
Client-Server 模式
Client-Server 模式指通过 Client 给 Server 发送音频请求,可以展示推理服务的端到端性能。因为包含了请求调度等环节,Offline 推理性能可视为 Client-Server 模式的优化上限。
我们先用 Nvidia TensorRT-LLM 为模型生成了推理引擎,使用Nvidia Triton[8]实现了服务的 Server 端。为了更好模拟多路并发的场景,我们还基于 Python 的 asyncio 库实现了一个支持异步并发的client[9]。
服务的测试结果如下:
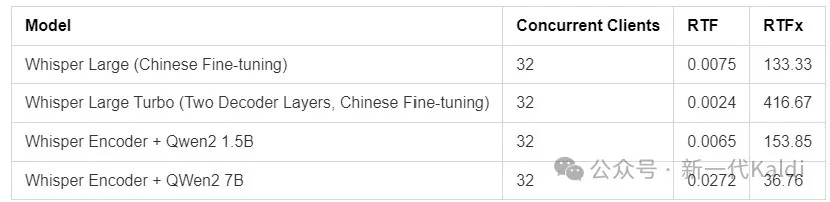
上表结果都没有对输入音频做 Padding,都默认开启 Nvidia TensorRT-LLM 的continuous batching[10]模式。为了节省显存,Whisper Encoder + Qwen2 7B 使用了Int8 Weight-only Quant[11](W8A16)。
快速上手
1. https://github.com/NVIDIA/TensorRT-LLM/tree/main/examples/whisper
2. https://github.com/triton-inference-server/tutorials
复现 Offline 解码模式测试的流程:
git clone -b sherpa https://github.com/yuekaizhang/open_asr_leaderboard.git
cd open_asr_leaderboard/tensorrtllm
bash run_whisper.sh
bash run_faster_whisper.sh
复现 Client-Server 模式测试的流程:
# grpc client
https://github.com/yuekaizhang/Triton-ASR-Client.git
cdTriton-ASR-Client
pip install -r requirements.txt

dataset_name=yuekai/aishell
subset_name=test
split_name=test
num_task=32
service_name=infer_bls
python3 client.py \
--server-addr localhost \
--model-name $service_name \
--num-tasks $num_task \
--text-prompt "<|startoftranscript|><|zh|><|transcribe|><|notimestamps|>" \
--huggingface_dataset $dataset_name \
--subset_name $subset_name \
--split_name $split_name \
--compute-cer

# server
git clone https://github.com/k2-fsa/sherpa.git
cd sherpa/triton/whisper
# MODEL_IDs=("large-v3-turbo" "large-v3" "large-v2-turbo-multi-hans" "large-v2-multi-hans")
MODEL_ID=large-v2-turbo-multi-hans docker compose up
其它方案
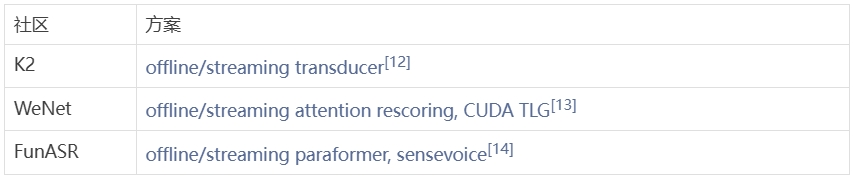
除了 ASR 大模型的部署方案,我们还针对许多社区流行的 ASR 模型开发了对应的推理方案,更多细节可以参考下表:
结语
本文介绍了 Sherpa 中的 ASR 大模型部署方案。未来,我们也会不断迭代这些部署加速方案,例如增加 Speculative Decoding 的支持、使用 CUDA Graph 加速 Transducer 解码[15]等,欢迎大家关注和交流。
