
 语音小管家
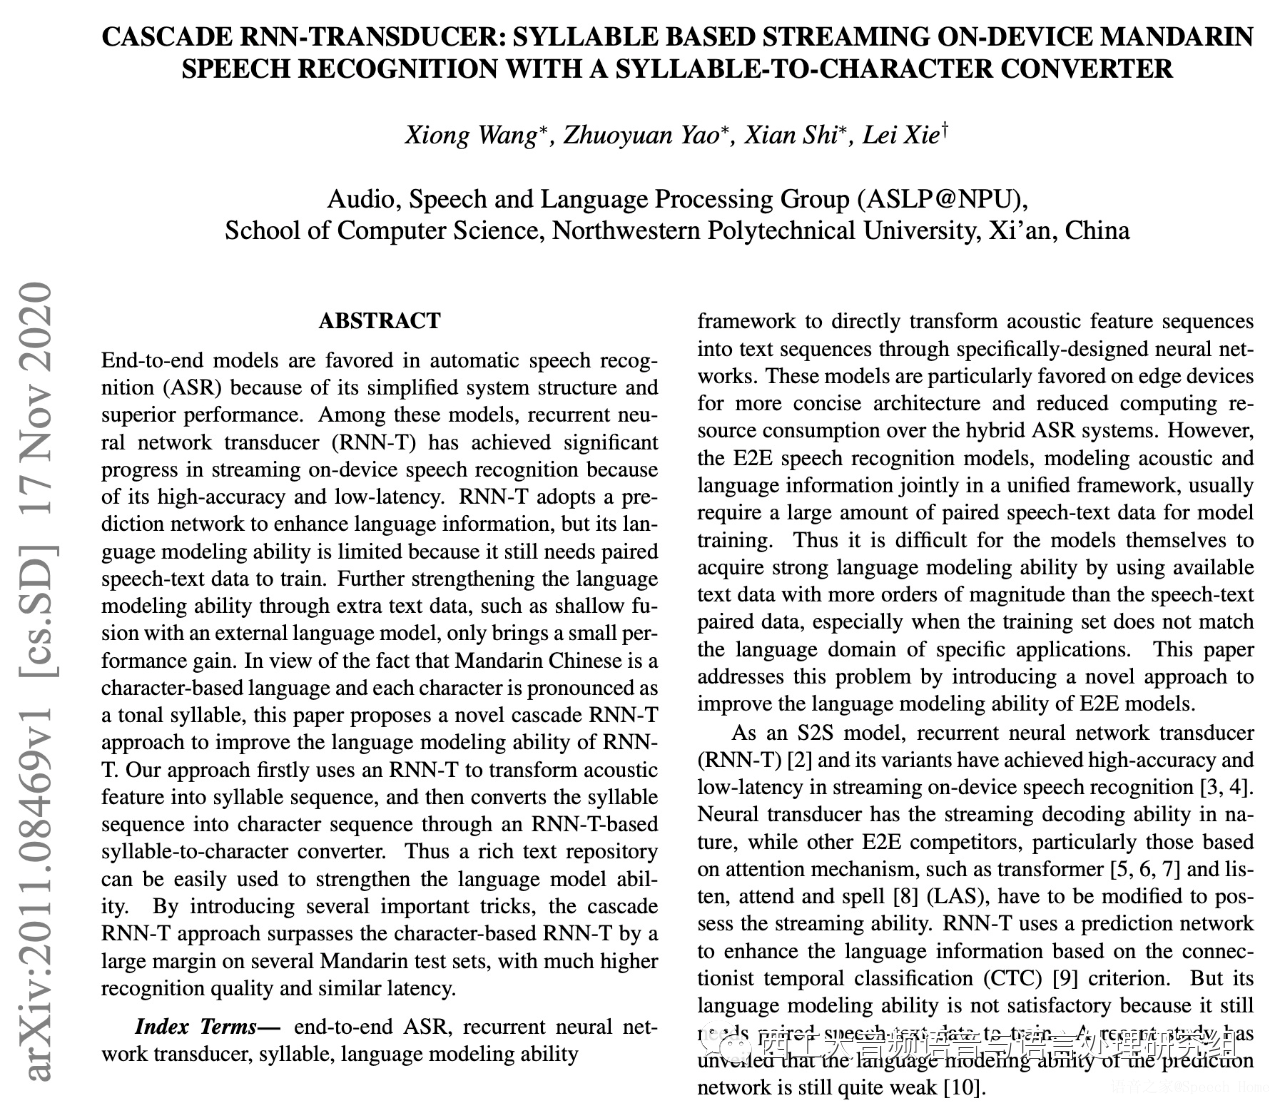
近期,实验室王雄、姚卓远、石宪同学的论文“CASCADE RNN-TRANSDUCER: SYLLABLE BASED STREAMING ON-DEVICE MANDARIN SPEECH RECOGNITION WITH A SYLLABLE-TO-CHARACTER CONVERTER”被语音研究旗舰会议IEEE Spoken Language Technology Workshop 2021(IEEE SLT2021)录用。针对离线流式语音识别任务,该论文提出了一种“级联式RNN-Transducer”(Cascade RNN-T)的方法,可以有效的利用额外的文本信息来加强模型的语言信息。现对该论文进行解读与分享。
论文题目:CASCADE RNN-TRANSDUCER: SYLLABLE BASED STREAMING ON-DEVICE MANDARIN SPEECH RECOGNITION WITH A SYLLABLE-TO-CHARACTER CONVERTER
作者列表:王雄,姚卓远,石宪,谢磊
论文原文:https://arxiv.org/abs/2011.08469
扫码直接看论文
↓↓↓
背景动机
语音识别技术(Automatic Speech Recognition,ASR)是一种将语音转化为文字的技术,语音识别是解放双手、实现自然人机交互不可或缺的技术,也是人工智能研究中举足轻重的研究方向。诸如华为、小米、百度、苹果以及谷歌亚马逊等公司所推出的语音助手、智能耳机以及智能音箱和智能家居中所具备的语音交互功能中就使用了这一核心技术。在实际应用过程中,复杂的声学条件、设备差异性、地域口音特性以及命名实体识别等都对语音识别的性能造成了极大的挑战。
传统基于声学与语言模型构图的混合(hybrid)语音识别技术由于模型结构复杂且计算量大很难在端侧(如手机、电视和音箱等)上进行离线使用,对模型进行剪裁优化后在端侧部署会有较大的精度损失。近年来,基于深度神经网络的端到端语音识别(End to End)架构大大简化了识别系统结构,能够较为便利的在端侧设备上进行部署并且具有较高的准确率,甚至超越了传统混合模型的识别精度。在众多的端到端模型中,RNN-Transducer(RNN-T)天然具有流式(streaming)语音识别的特性,同时由于具有高精度和低延迟的特点,已经在端侧上取得了显著的效果,以谷歌为首的众多研究团队也对这一模型从结构上进行了很多改良,也在端侧设备上逐步应用。
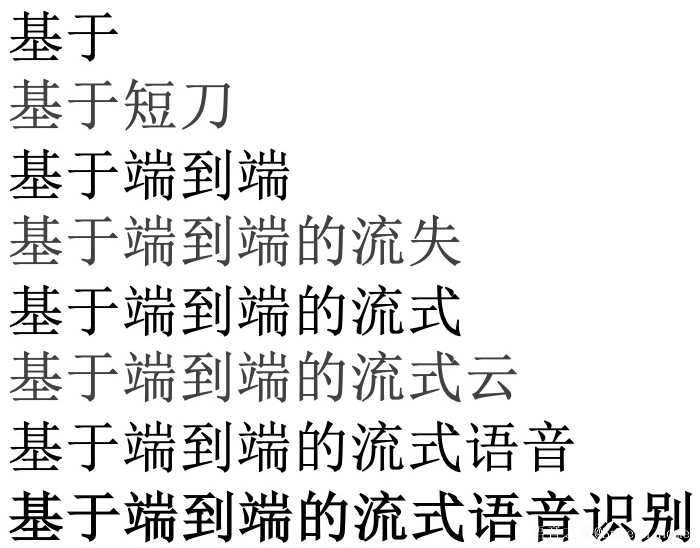
图2 流式(streaming)语音识别示意
相比CTC而言,RNN-T额外采用了一个Prediction网络来加强模型的语言信息,但事实上仍然需要语音-文本配对的数据来对模型进行训练,相比于传统模型而言语言建模能力仍然有限。许多研究者也尝试了引入额外文本信息的方法,例如使用一个RNN语言模型来帮助解码(即Shallow Fusion),以及使用语音合成(TTS)系统生成大量的生成语音-文本匹配的数据。而对于这两种方法而言,前者所带来的提升往往较小,后者则需要一个较为复杂的训练迭代过程,也依赖于多说话人的语音合成效果。
鉴于中文是一种基于音节发音的语言,本文提出了一种新颖的基于音节的级联式RNN-T模型(Cascade RNN-T),首先将语音转化为音节序列,再将音节序列转化为汉字序列,在第二个转化的过程中,所使用的模型就可以引入大量的文本数据来增强语言信息,从而提高模型的性能。该方案也是受传统hybrid方案的启发,又结合了Transducer架构和流式的优势,同时具有良好的灵活性,比如快速领域适配。
基于Cascade RNN-T的方案
如图3所示,我们提出的级联式RNN-T是将两个RNN-T级联到一起以增强语言建模能力。第一个RNN-T模型使用中文音节(syllable)进行建模,将输入的语音特征转化为音节序列,而第二个RNN-T则将前者输出的音节序列转化为汉字序列。对于第二个音节-汉字转换器而言,它在训练过程中可以引入大量的额外文本信息,从而达到增强语言建模能力的目的。除此之外,由于RNN-T具有天然流式建模不等长输入输出数据的能力,使用它作为音节-汉字转换器会比其它Sequence-to-sequence的模型更具优势。
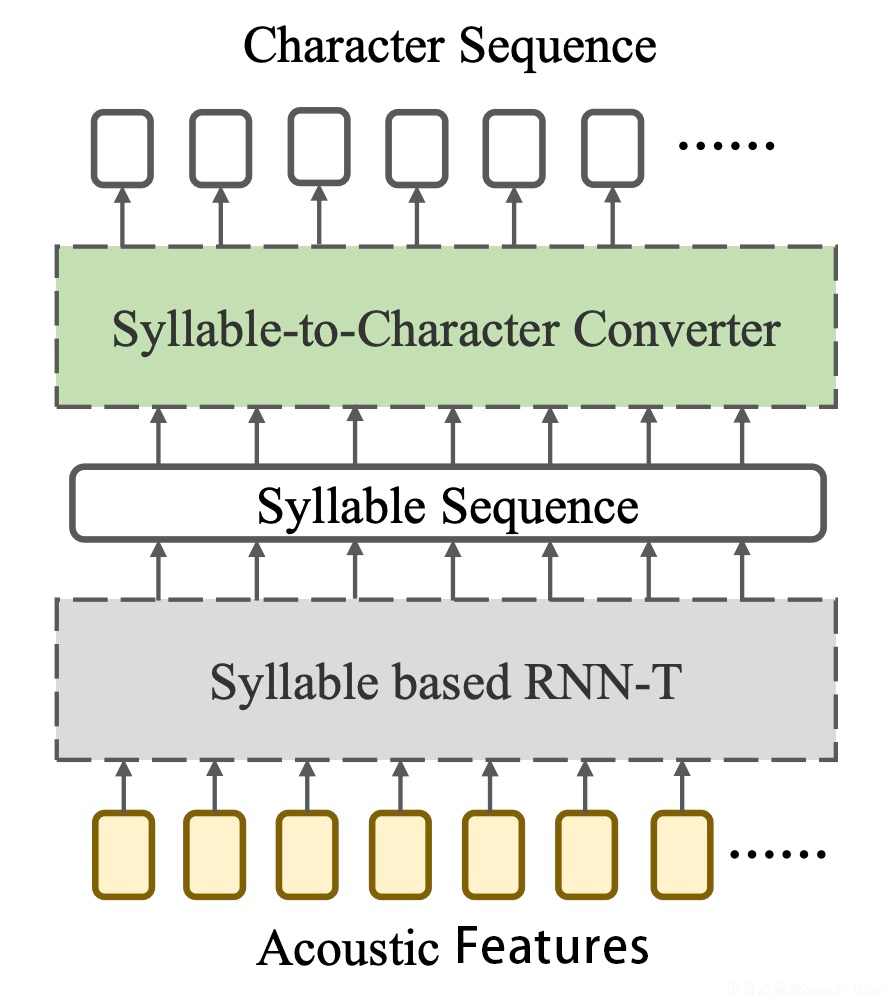
图3 级联式RNN-T结构示意图
对于具体的模型结构而言,我们首先使用音节建模的RNN-T作为第一个RNN-T。如图4所示,在编码器中我们首先加入了一维卷积来做降采样,再加入空洞一维卷积来获取额外的上下文信息,其余的网络结构均与标准的RNN-T一致。第二个用作音节-字符转换器的RNN-T如图5所示,它的编码器输入为音节序列,并且跟随了一层Embedding层来获取高维空间表示,针对这一模型,我们使用了四种方法来对其进行优化。
上文信息加强:由于直接使用LSTM对音节序列建模会损失一定的上文信息,因此我们在编码器中加入一个额外的一维卷积来获取上文信息;
Self Shallow Fusion:我们的Prediction网络中额外的引出一个全连接层,并对该层赋予RNN语言模型的任务,这样我们的模型在解码过程中就可以利用自身完成Shallow Fusion的功能,进一步加强语言信息;
数据增广:在训练过程中使用与SpecAugment类似的Text augmentation方法,在编码器输入的音节序列中进行随机替换来防止网络过拟合;
音节修正调优:为了使得第二个RNN-T更好的适应第一个RNN-T,我们使用第一个RNN-T在训练集上解码得到的音素-汉字匹配的文本数据对第二个RNN-T模型进行调优,从而进一步提高性能。
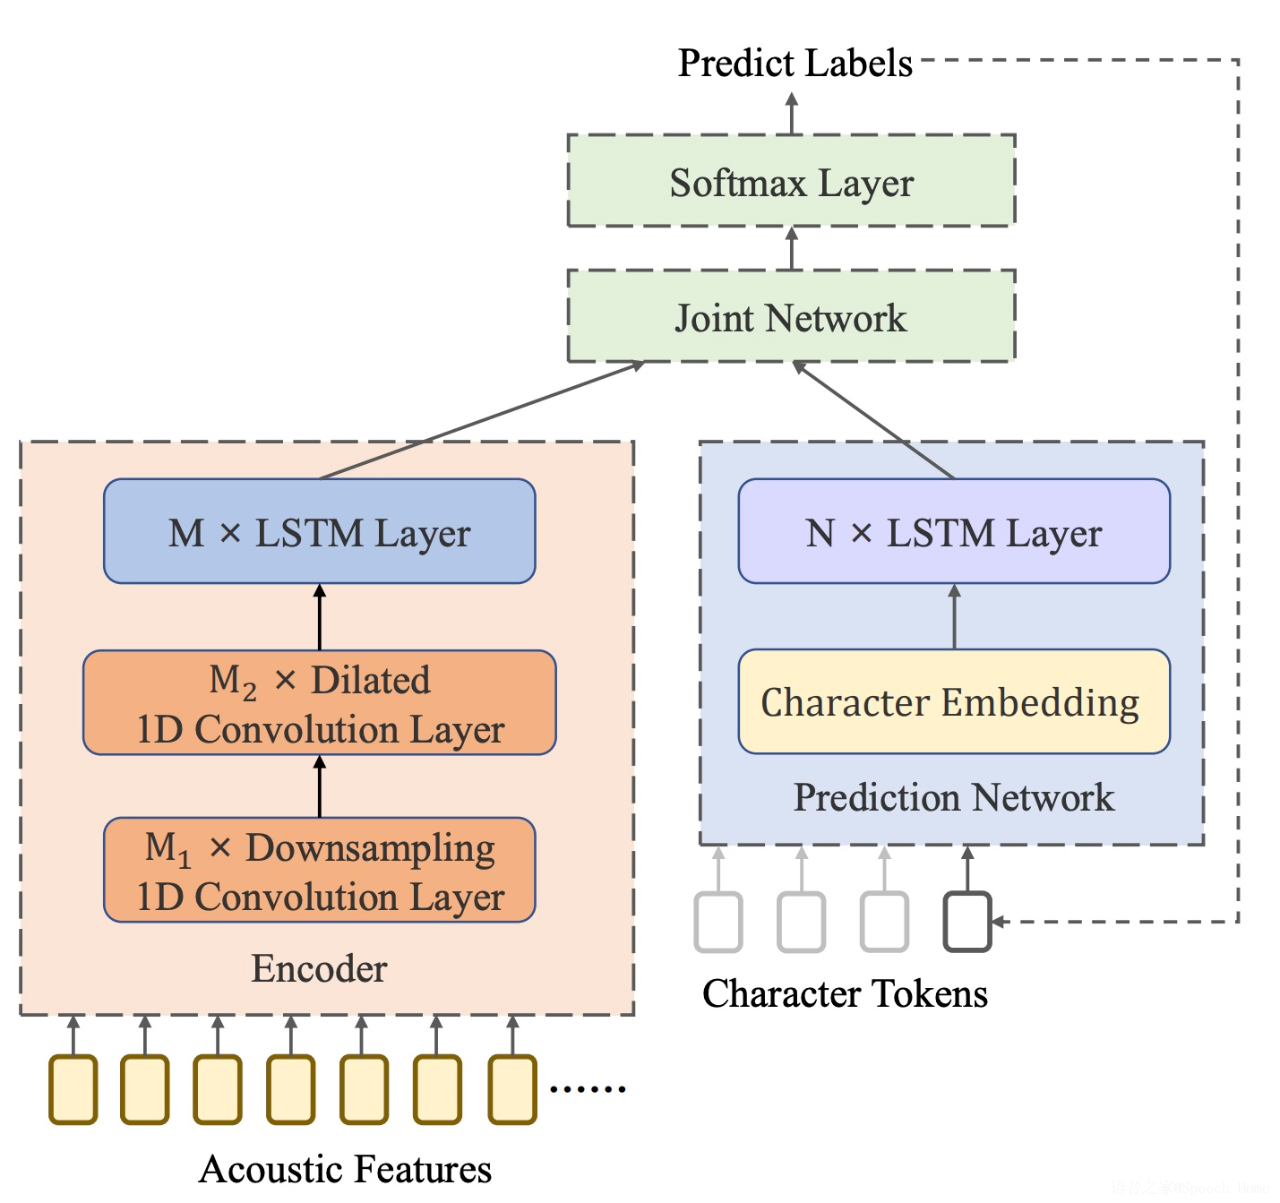
图4 基于音节的RNN-T结构示意图
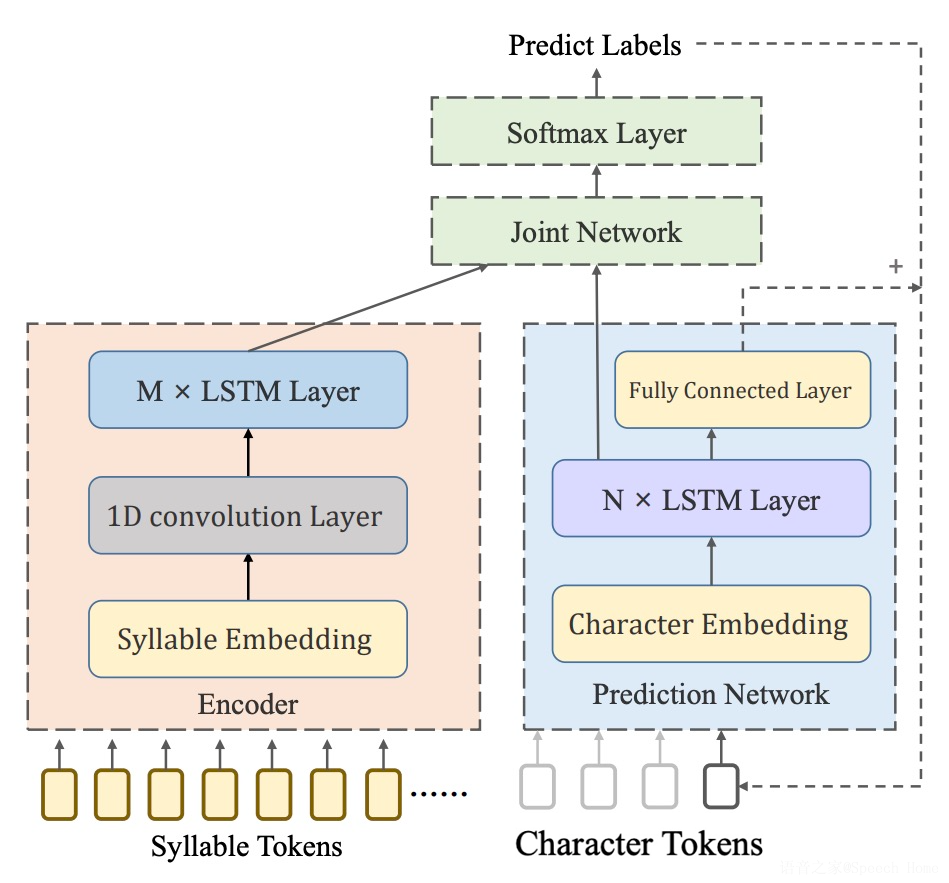
图5 基于RNN-T的音节到字符转换器
实验验证
在本文中,我们主要在公开数据集AISHELL-2和实验室内部7500小时数据集上进行验证实验,此外我们还使用了2G的中文文本数据来训练RNN语言模型和音节-字符转换器。实验中使用的四个数据集合分别为AISHELL-1测试集(TA1)、AISHELL-2测试集(TA2)、语音输入任务测试集(VI)以及语音助手任务测试集(VA),其中VI测试集由3063条句子组成,涵盖了较多的专有名词以及命名实体用于验证模型的泛化能力,VA测试集包括5000条语音助手数据,包含部分较低信噪比的数据,可以同时验证模型的语言建模能力和声学鲁棒性。
表1展示了我们在AISHELL-2数据集上对字建模的基线系统与级联式RNN-T模型的对比,其中B0为使用Greedy search解码的字建模RNN-T的结果,B1为使用了Beam Search解码方式,B2为引入了RNN语音模型做Shallow Fusion的结果,可以看到这两者都能起到正向作用。E0为我们提出的级联式RNN-T模型的结果,可以看到这一结果比基线系统要差。分析得出,音节建模的RNN-T的音节错误率是要低于字建模的RNN-T的字错误率的,由此可以确定是第二个RNN-T性能较差导致的这一结果。
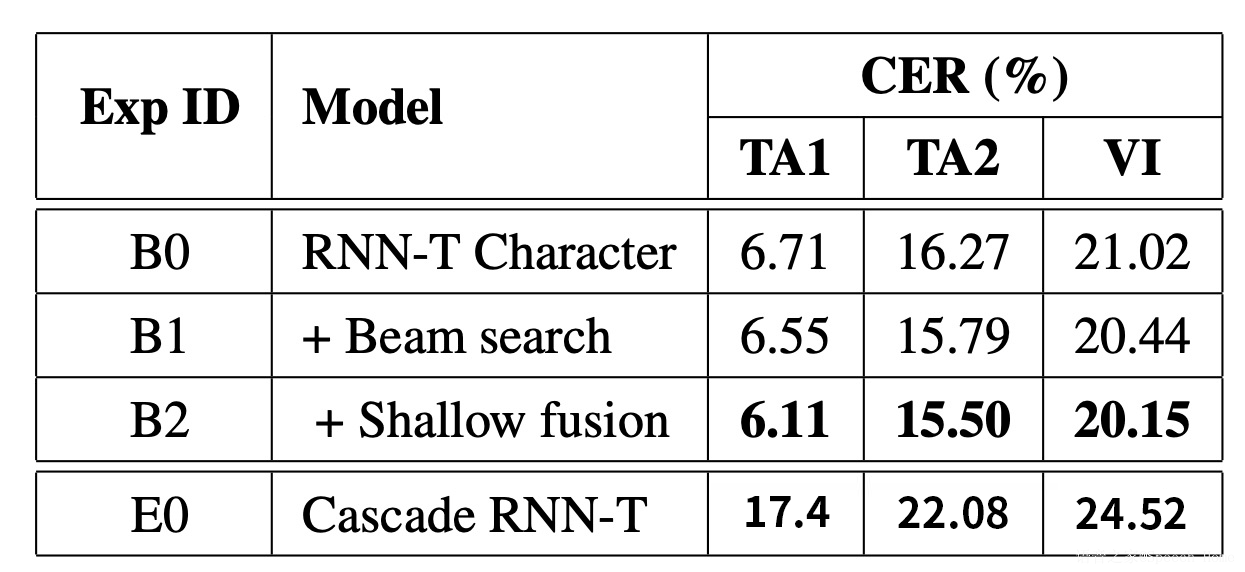
表1 字建模RNN-T与级联式RNN-T在测试集上的CER
表2展示了我们在引入了上文提到的四种优化方式之后的实验结果,可以看出级联式RNN-T在不同集合上的性能均有所提升,特别是在VI集合上提升更为突出,CER从传统字建模RNN-T(B2)的20.15%下降为17.60%。由此也可以得出:使用了额外的文本数据确实可以增强模型的语言建模能力。卷积层的加入(E1)可以让级联式RNN-T扩大对上文的感知能力,获得和传统字建模RNN-T(B2,结合BeamSearch和ShallowFusion)相当的识别效果,此外文本数据增广策略(E2)、Self Shallow Fusion(E3)和音节修正调优(E4)均能进一步提升性能,最终获得明显超越字建模RNN-T模型的效果。表3 对TA2测试集上的插入、删除和替换错误进行了进一步分析,可以看出模型性能的提升主要集中在替换错误的减少。
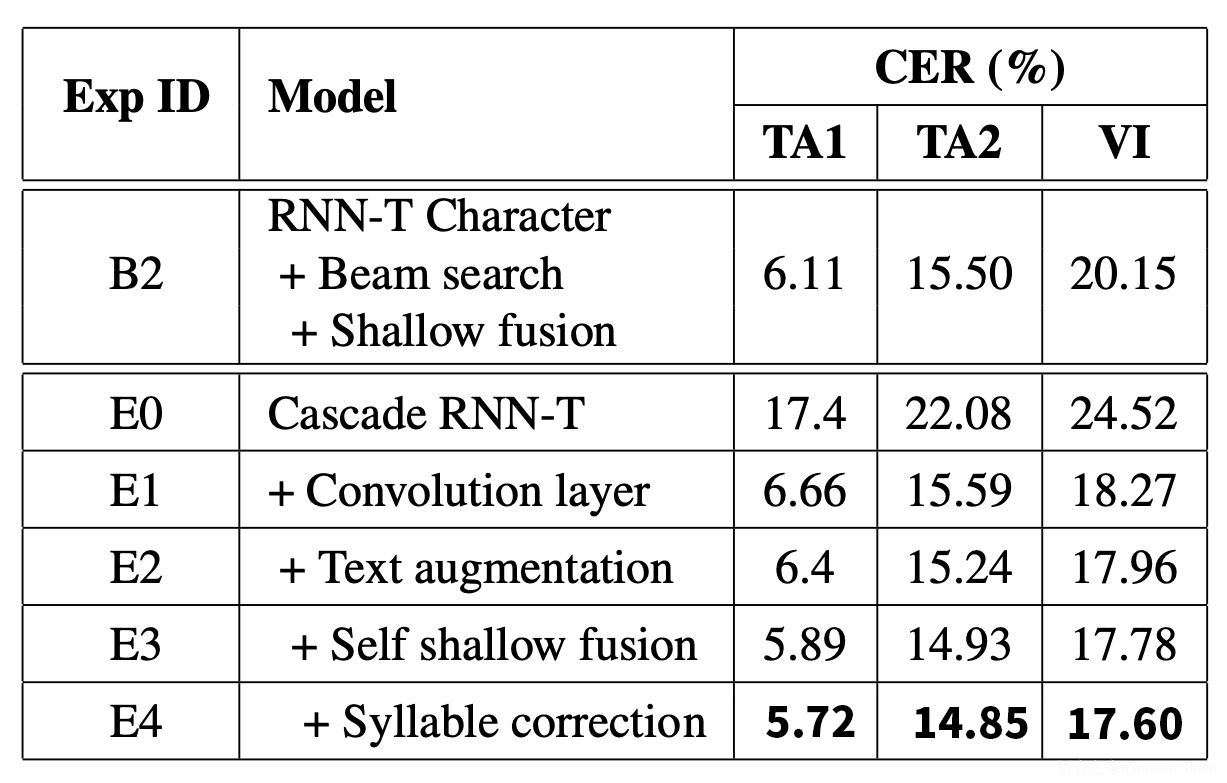
表2 调优后的级联式RNN-T在测试集上的CER
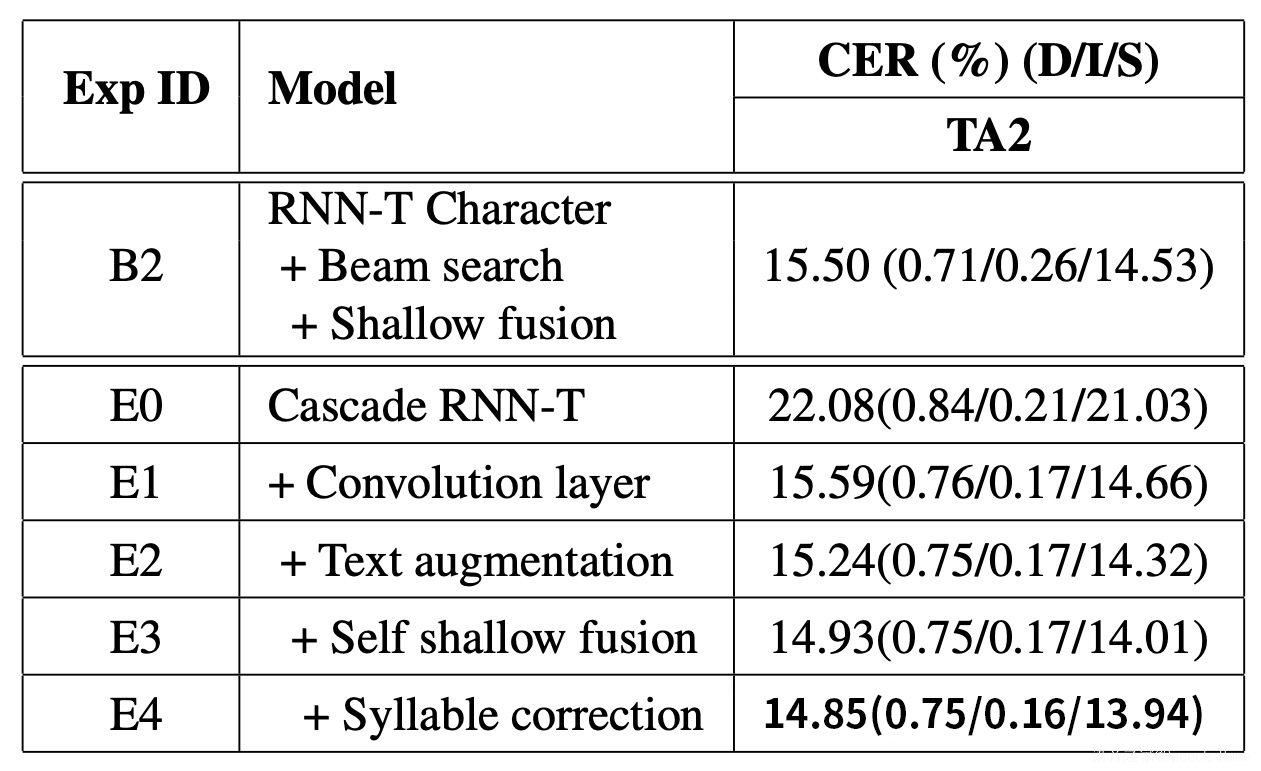
表3 不同模型在TA2测试集上插入、删除与替换错误对比
表4展示了我们在7500小时数据集上的结果,显然级联式RNN-T(E9)相比于基线系统(B5)在各个测试集上均有所提升,我们还在固定第一个RNN-T的基础上,特意对比了不同音节-字符转换器模型的性能。实验表明,使用RNN-T作为音节-字符转换器能够获得比同为流式的LSTM更高的准确率,而且能与使用BLSTM的非流式模型达到相当甚至更高的性能。
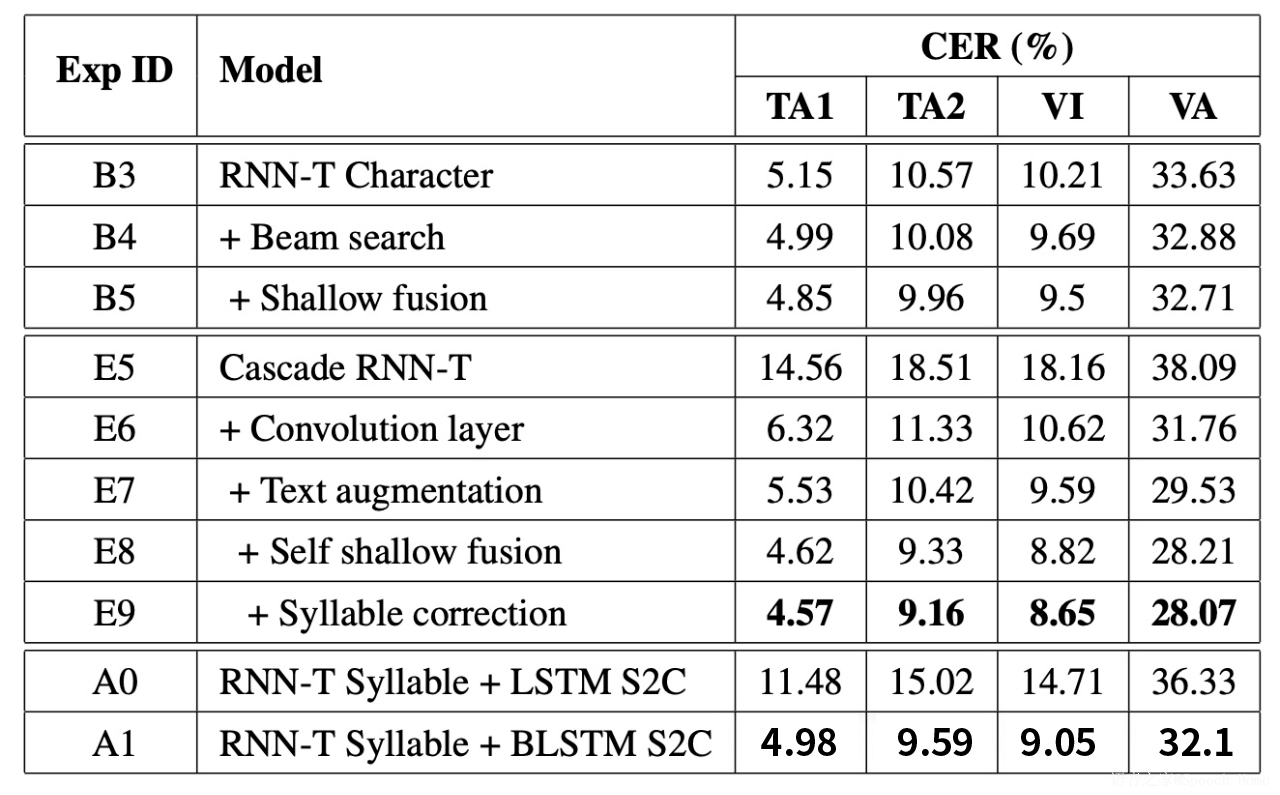
表4 使用7500小时数据的字建模RNN-T与级联式RNN-T在测试集上的CER
表5对我们上文提到的模型从参数量、时延以及准确率上进行了进一步总结,可以看出我们提出的级联式RNN-T(E9)能够在同等参数量与相近时延的情况下,相比基线系统(B5)在各个测试集上得到稳定的提升。
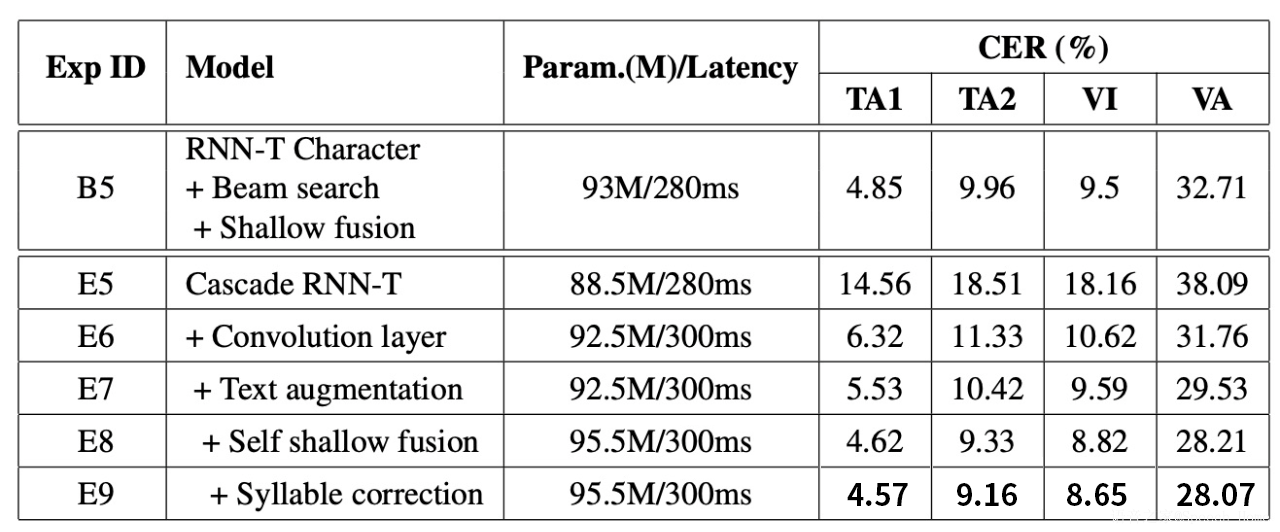
表5 不同模型间参数量、时延与准确率对比
RNN-T效果演示
目前,RNN-T已经在手机端进行优化和部署,获得了良好的识别性能,下面是演示。
