
 语音小管家
Facebook、哥伦比亚大学、佐治亚理工学院和达特茅斯大学的研究人员共同开发了一个框架——Vx2Text。这个框架可以帮助我们,从视频、音频等输入内容中提取信息,再以人类可以理解的文字,生成字幕或者回答问题等。
论文地址:https://arxiv.org/pdf/2101.12059.pdf
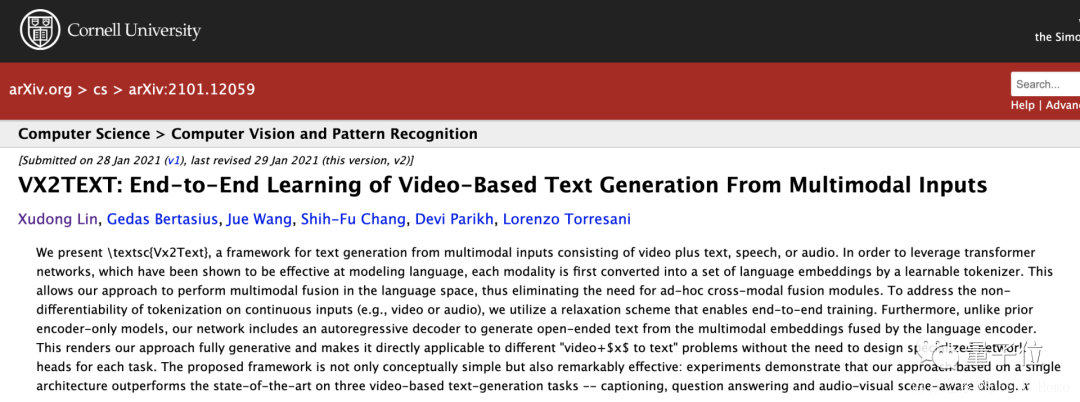
Vx2Text是从多模态输入中提取信息,再以人类可以理解的方式,生成自然语言文本。
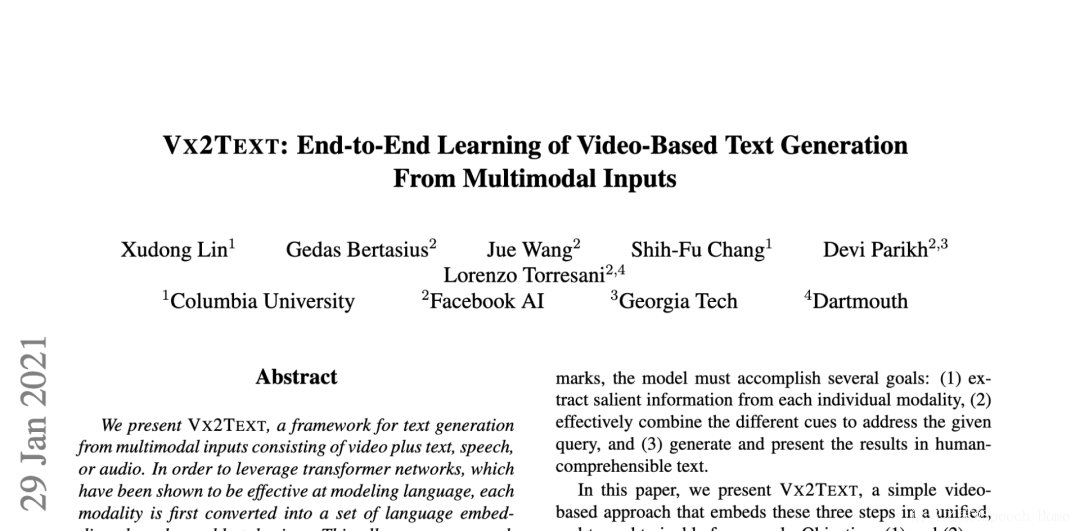
多模态学习可以包含一些潜在互补的信息或者趋势,不过,只有在学习中完全包含相关信息的时候,这些含义才能显现。对于Vx2Text,,“模态独立“的分类器将来自视频、文本或音频的语义信号,转换为公共语义语言空间,这使得语言模型能够直接解释多模态数据,从而为通过谷歌的T5等强大的语言模型进行多模态融合——即结合信号来支持分类——提供了可能。
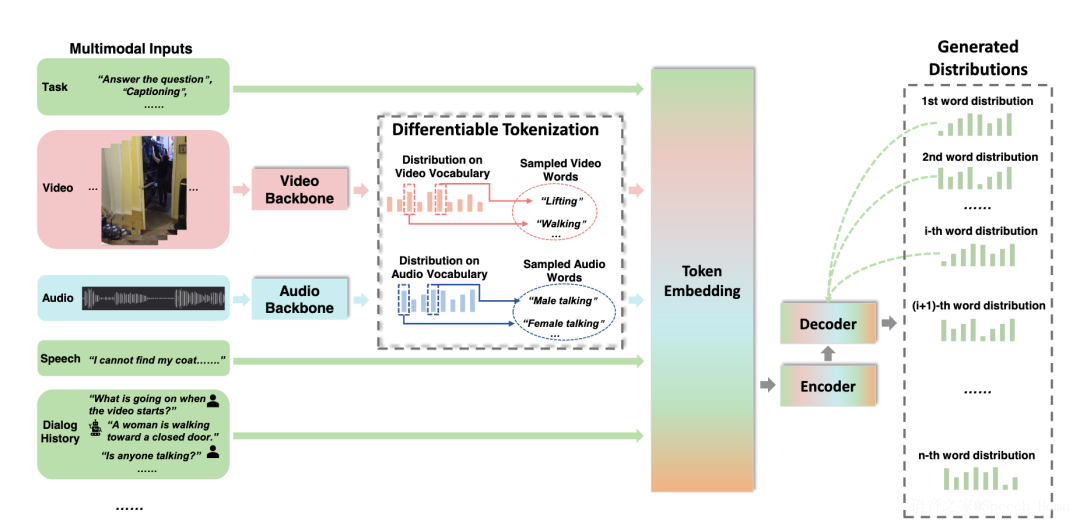
Vx2Text 框架图解
Vx2Text中的生成式文本解码器,将编码器计算的多模态特征转换为文本,使该框架适合于生成自然语言语义概括,如下图:
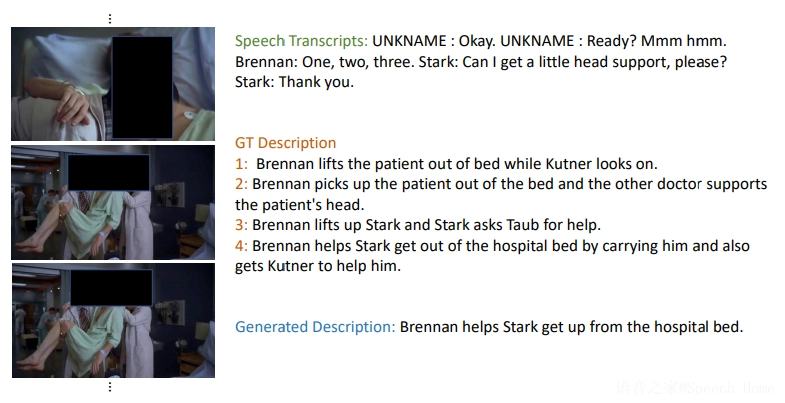
研究人员在论文中写道:“与之前的方法相比,这种设计不仅简单得多,而且具有更好的性能。”“更有用的是,它并不需要设计专门的算法,或者借鉴其他替代方法来实现多模态信息的组合”。
在实验中,研究人员展示了Vx2Text为带有视频和音频的视频场景所生成的「真实的」自然文本。尽管研究人员研究人员以对话历史和语音记录的形式,为模型提供了上下文,但是他们注意到,生成的文本包括了非文本形式的信息,例如帮助某人帮助某人站起来或者接电话等行为。
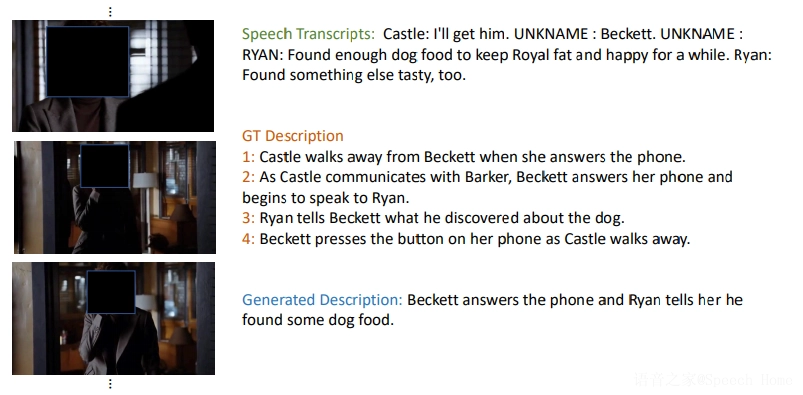
此外,由于Vx2Text可以高度整合、概括和真正理解多模态输入中蕴含的信息,因此,基于生成的语义信息,它也可以回答各种各样的问题:
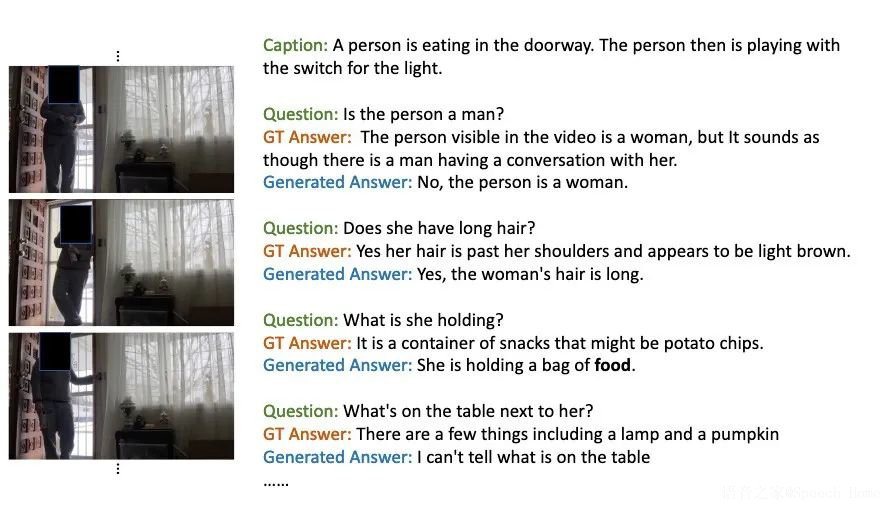
Vx2Text能够在多模态输入中,为视听场景感知对话和视频字幕,生成逼真自然的文本。Vx2Text可以用于为录制的视频或流媒体视频添加字幕,以及服务YouTube和Vimeo等视频共享平台,依靠字幕以及其他信号来改善搜索结果的相关性。
参考链接:https://venturebeat.com/2021/02/02/researchers-vx2text-ai-framework-draws-inferences-from-videos-audio-and-text-to-generate-captions/
