语音合成 (Text-to-speech, TTS) ,又称文语转换技术,是将文本转换为自然语音的一类技术。在深度学习的推动下句级语音合成的自然度和音质得到了极大的提升。而使用当前句级语音合成系统合成语音段落时,很难达到满意的自然度,这是因为在段落级语音合成中需要考虑丰富的上下文信息。为解决这一问题,本文提出面向段落语音合成的跨句语言和韵律信息学习方法,即ParaTTS。在主流端到端语音合成框架基础上,设计了三个子模块,包括语言感知网络,韵律感知网络和句位置编码网络。语言和韵律感知网络学习段落中的信息以及段落中句间的上下文关系。其中,语言和韵律感知网络中的编码器用来捕获段落级语言和韵律信息,多头注意力机制用来学习段落中跨句语言和韵律信息。句子位置编码网络显式利用段落中不同句子的位置信息,增强句在段落中的上下文关系。在一个中文女生录制的讲故事风格的有声书数据集上的实验表明,ParaTTS可以生成自然高质的段落语音,可以更好的捕获到跨句上下文信息,例如更准确的句间停顿和韵律变化等。在域外的长段落和超长段落测试集上的实验表明,ParaTTS在合成长段落语音上具有很好的泛化能力。本文相关工作近期发表在语音研究顶级期刊IEEE Transactions on Audio, Speech and Langauge Proccessing上。

论文题目:ParaTTS: Learning Linguistic and Prosodic Cross-sentence Information in Paragraph-based TTS作者列表:薛浏蒙,宋謌平(Frank K. Soong),张少飞,谢磊发表期刊:IEEE/ACM Transactions on Audio, Speech, and Language Processing, Volume 30, Page(s) 2854 - 2864, August 2022
发表论文截图
背景动机
随着深度学习的发展,基于神经网络的语音合成系统能够在限定领域和条件下生成接近人类的语音。语音合成的应用场景也越来越多,例如语音助手、导航、智能客服、有声书等。其中有声书作为语音合成的一个重要应用,是自动将一本书的文本合成自然并富有表现力的语音。
有声读物的文本是由连续的句子、段落和章节以连贯和层级的形式构成。而文本上连贯和层级的关系会影响它如何被读出来。段落是由一个或多个句子组成,是一个独立的语篇单元,用来表达一个特定的观点。段落语音中包括多个韵律模式,例如基频重置,基频能量衰减,拖音等[1]。
合成段落语音的一种直接方式是合成段落中的每个句子,然后将他们拼接起来。但该方案有以下三方面的缺点:(1)需要一个额外的后处理步骤来将所有单独的句子合并成完整的段落。(2)在合并句子时,相邻句子之间的停顿时长需要精心考虑,停顿时间太长或者太短都会导致合并后的段落语音不自然。(3)合并后的段落语音在韵律上可能不一致,句子间的韵律过渡不自然。所有这些潜在问题使得段落语音合成变得复杂和困难。此外,单独的句子和段落中的句子在韵律和声学特征上也存在差异。另一种方案是直接合成段落级语音,这在主流的端到端语音合成框架上是可行的。但是如果没有考虑段落中大量丰富的上下文信息,会导致聆听长音频时听者的疲劳。
本文旨在构建一个自然并富有表现力的段落级语音合成系统-ParaTTS。由于内存和计算资源的限制,我们在句级模型训练的同时加入段落级信息到模型中。在没有篇章结构标注的情况下,我们从段落文本自身中学习段落语言知识。具体来说,我们采用一个段落文本编码器来提取段落的高层语言表征。在韵律方面,我们从段落语音片段中提取韵律特征,并通过一个段落韵律编码器捕获段落级韵律信息。同时,我们使用多头注意力机制来学习句和段落之间的内在关系,并使用句位置编码网络来进一步增强句在段落中的上下文关系。
方案介绍
图1是ParaTTS的模型框架图。它包括四个部分:(1) 改进版的Tacotron2,用作TTS主模块;(2)语言感知网络 ;(3)韵律感知网络;(4)句子位置编码网络。下边将分别介绍各个模块。
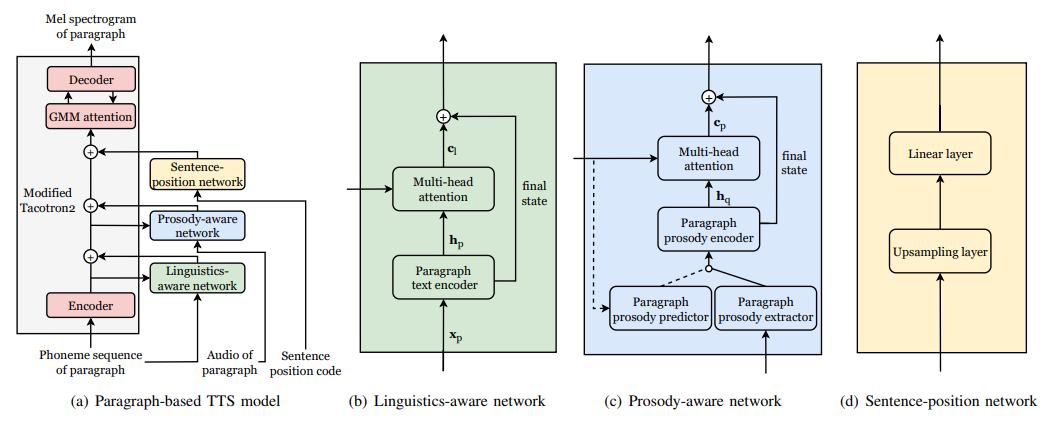
图1 ParaTTS模型框架图
改进版Tacotron2
采用主流的端到端语音合成框架Tacotron2,并在此基础,进行以下两点改进:- 使用GMMv2b注意力机制[2],提升对长序列建模的鲁棒性
语言感知网络
语言感知网络的目的是学习整个段落文本中的语言信息,以及句子在段落中的语言上下文。输入是段落音素序列,输出包括两部分:段落的高层语言表征,句子在段落中的语言上下文信息。如图1(b)所示,语言感知网络包括两个子模块:- 段落文本编码器:使用CBHG编码器结构,用来从段落文本中提取高层语言表征
- 多头注意力机制:用来学习句子在段落中的语言关系上下文
语言感知网络可以从语言特征方面弥补句级训练时缺少的全局段落信息以及句在段落中的上下文信息。韵律感知网络
韵律感知网络的目的是学习整个段落语音中的韵律信息,以及句在段落中的韵律上下文。如图2(c)所示,韵律感知网络包括四个子模块:- 段落韵律提取器:在训练阶段使用,从段落语音中提取三维音素级韵律特征,包括:基频,能量和时长
- 段落韵律编码器:用来对三维段落韵律特征编码并提取段落全局韵律表征
- 多头注意力机制:用于学习句在段落中的韵律上下文信息
- 段落韵律预测器:在推理阶段使用,用于预测段落的三维音素级韵律特征。输入是TTS主模块编码器输出结果和语言感知网络输出结果的加和。
韵律感知网络可以从韵律方面弥补句级训练时缺少的全局段落信息和句在段落中的上下文信息。句位置编码网络
段落通常包含多个句子,而句子的韵律会随着在段落中的不同位置而变化,在下文的数据分析部分有对应的段落韵律模式分析介绍。为了将这一特性加入到模型建模中,我们使用了一个句位置编码网络。如图1(d)所示,它包括一个上采样层和一个线性层。输入是句子在段落中的位置编码,例如:0,1,2分别表示段落中的第一个句子,中间句子和最后一个句子。上采样层将句子编码上采样到音素级句子编码,然后通过一个线性层将其映射到需要的维度。图2展示了一个句位置编码的例子。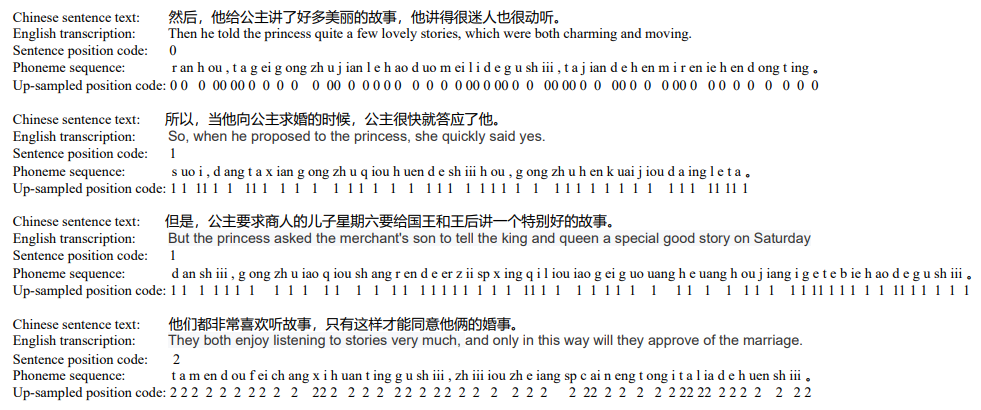
图2 句位置编码示例。该段落包括四个句子,第一个句子和最后一个句子的位置编码分别是0和2,其余中间句子的位置编码是1。
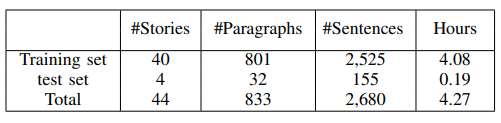
我们使用的数据集是一个女性普通话说话人录制的讲童话故事风格的有声书素材,数据信息如表1所示。该数据一共有44个故事,4.3小时左右。随机选择4个故事作为测试集,包括32个段落。其他40个故事作为训练集,包括801个段落,2,525个句子,4.08小时。
表1 数据集信息
数据统计
我们对数据的文本长度(汉字个数)和语音时长做了统计分析,统计结果如图3所示。每个段落平均有3个句子,55个汉字。每个句子平均有17个汉字。句子和段落的平均时长分别是6.5秒和11.4秒。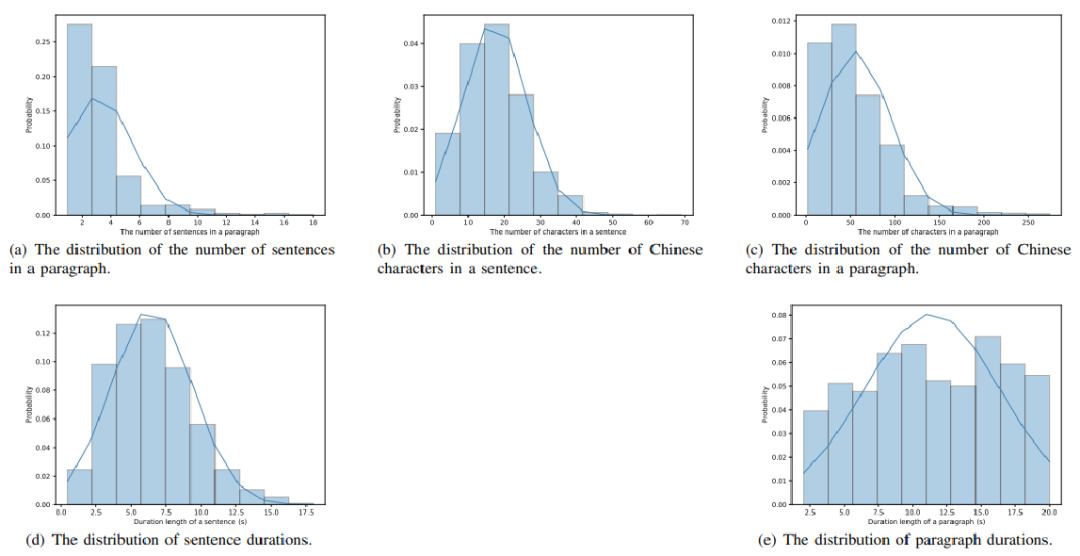
图3 数据的统计信息。(a)段落中句子数量的分布。(b)句子中汉字数量的分布。(c)段落中汉字数量的分布。(d)句子时长的分布。(e)段落时长的分布。
段落内韵律模式分析
图4展示了段落内韵律模式分析结果。我们统计了段落内不同位置的句子在基频、能量和时长上的变化趋势。从图4中可以看到两个韵律模式:- 衰减(Declination):基频和能量在段落内逐渐衰减。
- 拖音(Lengthening):在段落中间位置语速最高,在段落起始和结束位置有拖音现象。
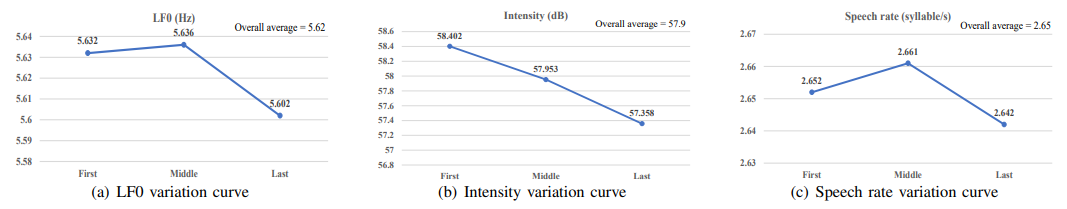
图4 段落内韵律模式分析
段落间韵律模式分析
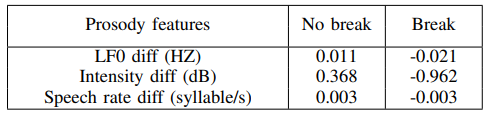
表1展示了段落间韵律模式分析结果。我们统计了段落内相邻句子之间的韵律差异(no break),以及段落最后一个句子与相邻段落第一个句子之间的韵律差异(break)。从表2中可以看到段落内(no break)的韵律差异值是正数,说明段落内的韵律特征有衰减趋势。而跨段落(break)时韵律差异值是负数,说明在段落边界处有韵律重置现象(prosody reset),即在一个新段落的起始位置基频、能量和语速是增高的。表2 段落间韵律模式分析
本文从客观评估、主观评估和域外测试三个方面对ParaTTS进行了实验验证。对比系统包括:- LingTTS: Baseline基础上加上语言感知网络
- ProsTTS: Baseline基础上加上韵律感知网络
- ComTTS: Baseline基础上加上语言感知网络和韵律感知网络
- ParaTTS: ComTTS基础上加上位置编码网络,即本文的最终方案
客观评估
表3展示了 MCD、音节级韵律相关性和停顿RMSE三方面的客观评估结果。
表3 客观测试结果,包括 MCD、音节级韵律相关性和停顿RMSE
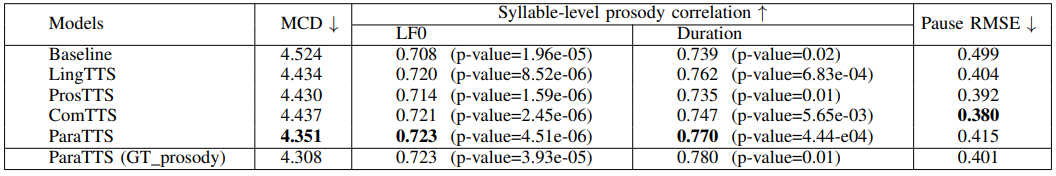
自然度:我们计算MCD作为自然度的客观评估指标。表3中的MCD结果表明,LingTTS、ProsTTS和ComTTS获得了相近的MCD结果,并且都优于Baseline。使用句子位置编码网络后,ParaTTS的MCD进一步降低得到最好的结果,说明ParaTTS可以生成自然度更好的段落语音。韵律:表3中的韵律相关性结果表明,所有模型在基频和时长相关性上都获得了较好的结果,ParaTTS的韵律相关性结果最好。ProsTTS和韵律更相关,但是韵律相关性结果没有比LingTTS的结果好,这可能是因为ProsTTS中的韵律预测主要依赖于语言信息。因此结合了语言感知网络和韵律感知网络的ComTTS也没有获得比LingTTS更好的结果。使用句子编码网络后,ParaTTS的韵律相关性得到了提升,这说明句子位置信息直接提供了简单有效的句子特征,这对于多句子段落生成是有帮助的。当给定真实韵律时,ParaTTS(GT_prosody)得到了比ParaTTS更好的MCD结果,但是两者的基频相关性接近。这说明给定真实韵律可以提升自然度,同时ParaTTS预测的韵律是合适的。图5展示了从录音数据和不同模型生成的段落语音中提取的基频曲线图。从图中可以看到ParaTTS的基频曲线相比其他模型更接近录音数据的基频曲线。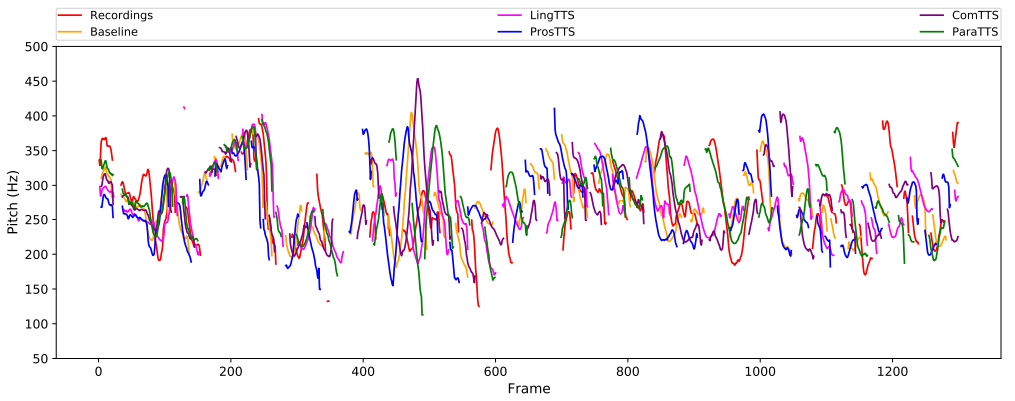
图5 从原始段落录音和各种模型生成的段落语音中提取的基频曲线图对比
停顿:句子间的停顿时长对段落语音合成效果很重要,我们计算了相邻两个句子之间的停顿时长的RMSE,如表3所示。结果表明,Baseline的停顿时长RMSE结果最差,其他四个模型的结果均好于Baseline,其中ComTTS的结果最好。图6展示了从原始段落录音和所有模型生成的段落语音中提取的梅尔谱,白色方框展示了相邻句子之间的停顿时长。可以发现在Baseline中,句间的停顿时长过长,这会导致段落语音听感很不自然。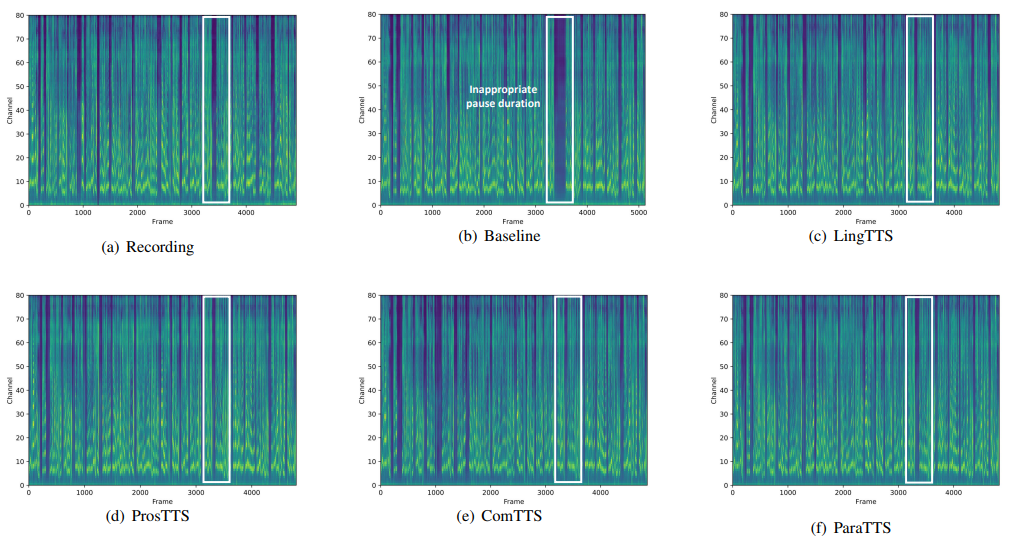
图6 从原始段落录音和各种模型生成的段落语音中提取的梅尔谱对比,白色方框表示相邻句子间的停顿时长。
主观评估
我们对合成的段落语音进行了偏好测试和详细的MOS测试。偏好测试:我们在Baseline、ComTTS和ParaTTS之间进行了偏好测试来验证语言感知网络、韵律感知网络和句编码位置网络的有效性,结果如图7所示。ComTTS获得了比Baseline多30%的偏好,这说明语言和韵律感知网络能够提升段落合成效果。ParaTTS相比ComTTS获得了额外的4%的偏好,这个较小的增益与客观结果中的MCD和韵律相关性结果一致。由于所使用的数据集规模较小,句子在不同位置上所表现的韵律差异不大,因此加入句子位置编码网络获得了相对较小的收益。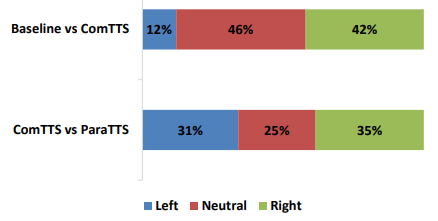
图7 偏好测试结果
MOS测试:我们从4个维度进行了MOS测试,包括:可懂度、愉悦度、停顿和听感舒适度。从图8的测试结果可以看到不同方案的MOS差异不是很大,这与文献[3]中的结果相似,这是因为对于长语音进行测听,听者很难记住所有的差异并给出一个有区分性的分数。尽管如此,ParaTTS在四个维度上都获得了相比Baseline更高的MOS得分。较好的可懂度和愉悦度同样体现在较低的MCD和较高的基频相关性两个客观结果上。ParaTTS的停顿MOS分数接近原始录音的结果,这与较低的停顿RMSE结果一致。较好自然度和愉悦度,也提升了ParaTTS段落语音听感的舒适度。
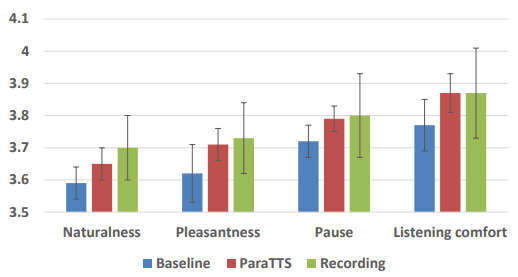
图8 详细的MOS测试结果
域外测试
为了验证ParaTTS的泛化能力,我们进一步将测试扩展到域外测试集上,包括长段落和超长段落。域内测试集和域外测试集的信息如表4所示。域内测试集有32个短段落,每个段落平均有5个句子,半分钟。域外测试集有12个长段落和6个超长段落,每个段落平均有23和51个句子,平均时长是2分钟和5分钟。
表4 域内和域外测试集信息
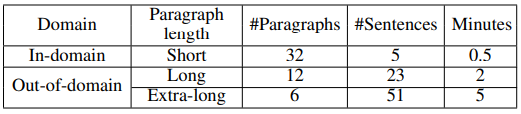
图9展示了域内和域外的MOS测试结果。ParaTTS无论是在域内还是域外测试集上,都获得了比Baseline更高的MOS分数,说明ParaTTS在合成长段落语音上有很好的泛化能力。同时,可以看到MOS分数随着段落长度的增加而降低,即使是原始录音,长段落相比短段落的MOS分数也呈下降趋势[4]。
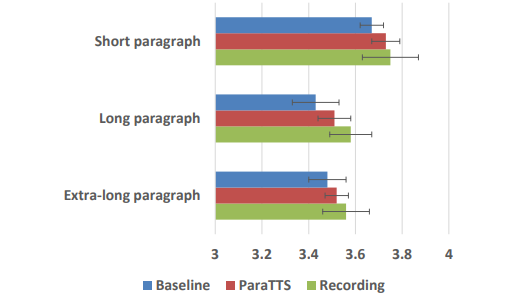
图9 域内和域外测试集上的MOS测试结果
长段落:ParaTTS -- Demo paragraph(点击试听)
相关有声书合成样例:《久别重逢》片段(点击试听)
[1] Cole J. Prosody in context: A review[J]. Language, Cognition and Neuroscience, 2015, 30(1-2): 1-31.[2] Battenberg E, Skerry-Ryan R J, Mariooryad S, et al. Location-relative attention mechanisms for robust long-form speech synthesis[C]//ICASSP 2020-2020 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP). IEEE, 2020: 6194-6198.[3] Hu N, Shao P, Zu Y, et al. Discourse prosody and its application to speech synthesis[C]//2016 10th International Symposium on Chinese Spoken Language Processing (ISCSLP). IEEE, 2016: 1-5.[4] Clark R, Silen H, Kenter T, et al. Evaluating Long-form Text-to-Speech: Comparing the Ratings of Sentences and Paragraphs}}[C]//Proc. 10th ISCA Speech Synthesis Workshop. 99-104.[5] Pan J, Wu L, Yin X, et al. A chapter-wise understanding system for text-to-speech in Chinese novels[C]//ICASSP 2021-2021 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP). IEEE, 2021: 6069-6073.
 西工大音频语音与语言处理研究组
