文章来源于它思科技,作者THU-SPMI
本文介绍清华大学语音处理与机器智能实验室(Speech Processing and Machine Intelligence, SPMI)与中国移动研究院(CMRI)的联合工作——MGA:一种马尔可夫架构的对话系统,大幅提升端到端对话系统的训练与推理效率,简洁高效达到SOTA(State Of The Art,最好结果)。该工作已被语音语言技术领域国际会议SLT 2022录用,论文的作者是刘红、蔡予诚、欧智坚、黄毅、冯俊兰。
https://arxiv.org/abs/2204.06452
扫码看论文
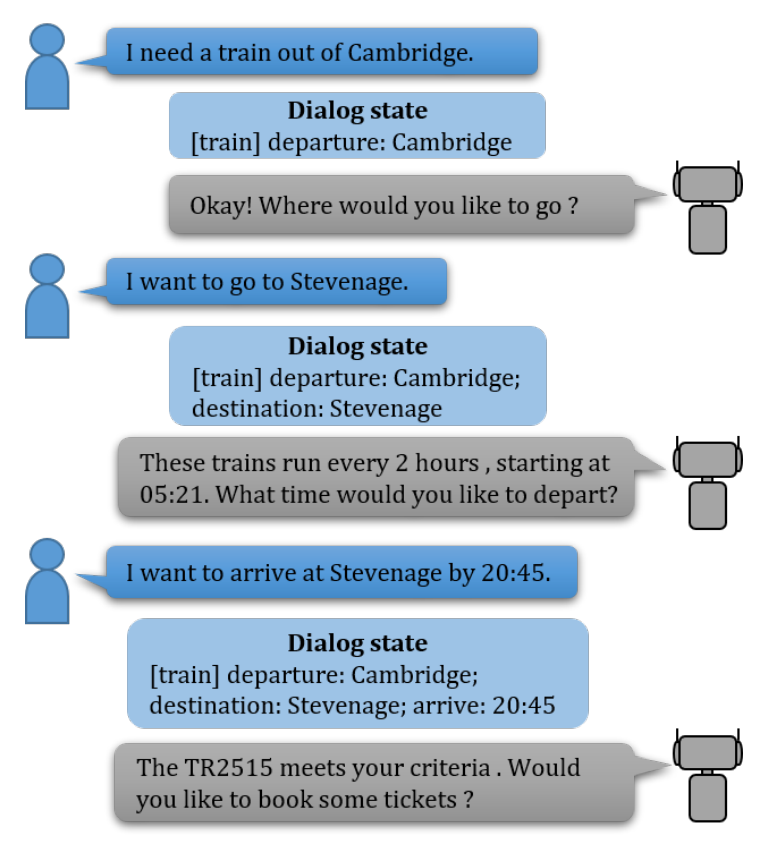
本文主要研究的是任务型对话系统。不同于闲聊型对话系统,任务型对话系统的主要目标是,帮助用户完成特定任务,例如预定旅馆、查询机票等。一个任务型对话系统在收到当前轮用户话语之后,需要结合之前的对话内容,理解用户话语(Natural Language Understanding)、跟踪对话状态 (Dialogue State Tracking)、查询知识库 (Knowledge Base)、决定系统动作 (System Policy) 并生成回复(Natural Language Generation)给用户。近年来随着大型预训练语言模型(如GPT-2、T5)的出现,研究者将对话系统的各个模块建模为一系列的序列生成过程,通过微调(finetuning)预训练语言模型(如GPT-2,T5等),借助其强大的生成能力,超越了传统的模块化对话系统。相比于先前的LSTM网络结构,Transformer结构的预训练语言模型能够更好的捕捉长程关系;因而研究者在构建Transformer骨架的对话系统时,往往向系统中输入尽可能长的历史信息,比如将前面所有轮次的对话历史都输入系统,让系统预测当前轮的内容。然而,输入内容并非越多越好,将全部对话历史作为输入,会造成系统在内存、计算和学习上的效率不足(inefficiencies in memory, computation and learning)。注意到在任务型对话系统研究中,有一个经典概念—对话状态(dialog state)。当前轮的对话状态,定义为是对截止到当前轮的对话历史信息的总结;对话状态包含足够的信息让系统做出恰当的决策来回复用户。在此定义下,对话状态本质上是一种马尔可夫状态(Markov state)。马尔可夫状态,是马尔可夫决策过程(Markov Decision Process,MDP)理论的基本概念。马尔可夫状态,概括了系统进行决策所需要的历史所有相关信息。鉴于此,对话系统自然地被建模为马尔可夫决策过程,即系统在当前轮的回复仅依赖于当前轮的对话状态,而与更早轮的对话状态无关,不必读入所有对话历史。鉴于Transformer的优秀长程建模能力,基于预训练语言模型的对话系统出现后,研究者纷纷采用非马尔可夫模型,系统在当前轮的回复依赖于全部历史,但却又同时在系统中沿用对话状态。值得注意的是,在实践中比较马尔科夫模型和非马尔科夫模型,很难有一般结论哪个会更好。模型并不是越复杂越好,模型选择中向来有”奥卡姆剃刀原则”——如无必要,勿增实体。爱因斯坦也有过类似的格言 :)马尔可夫模型做了马尔可夫假设,假设对话状态是一种马尔可夫状态;非马尔可夫模型假设大模型在一定数据下能被充分训练,这在低资源(low-resource)下更是难以成立。两相比较,带来了有趣的研究问题:
- 在数据充分(rich-resource)情形下,马尔可夫模型能否媲美非马尔可夫模型?
- 在小数据(low-resource)情形下,马尔可夫模型能否胜出非马尔可夫模型?
本文对此做了详细的经验研究。通过严谨的实验对比分析,表明了在构建端到端对话系统的任务中,马尔可夫模型在内存、计算和学习上的效率优越性。基于上面的认识和考虑,本文提出在预训练语言模型上仍使用马尔可夫生成架构(Markovian Generative Architecture,MGA)来构建端到端对话系统。在MultiWOZ2.1数据集上,MGA在两种不同的预训练语言模型骨架(GPT-2,T5)下,取得了媲美SOTA的实验结果,同时时间和内存开销均显著降低,在低资源情形下学习效率高带来的性能优势更明显。
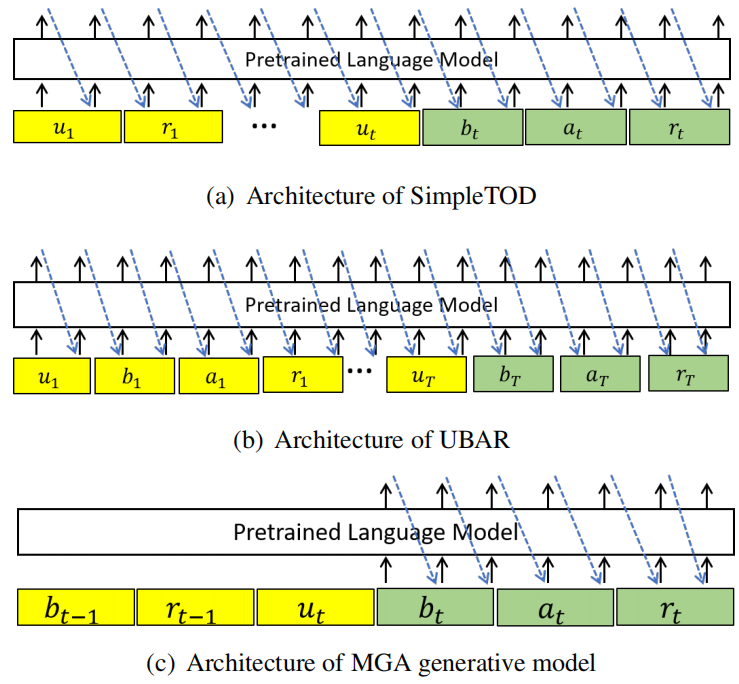
在MGA模型中,系统首先通过上一轮的对话状态和当前轮的用户话语,预测出当前轮的对话状态,进而查询数据库,决定对话动作,并生成回复。在训练时,MGA模型的输入和输出会被序列化并拼接在一起作为一个训练样本,用于微调预训练语言模型。在MGA中,一个训练样本仅拼接当前轮和上一轮的信息作为输入序列,大大缩减了训练样本长度,从而降低了训练和推理时的内存和时间开销。
在MGA之前,以Transformer预训练语言模型为骨架的任务型对话系统,可以分为轮次级别(turn-level)和会话级别(session-level)两类,分别以SimpleTOD和UBAR为代表。MGA同这两类模型的结构对比如下:
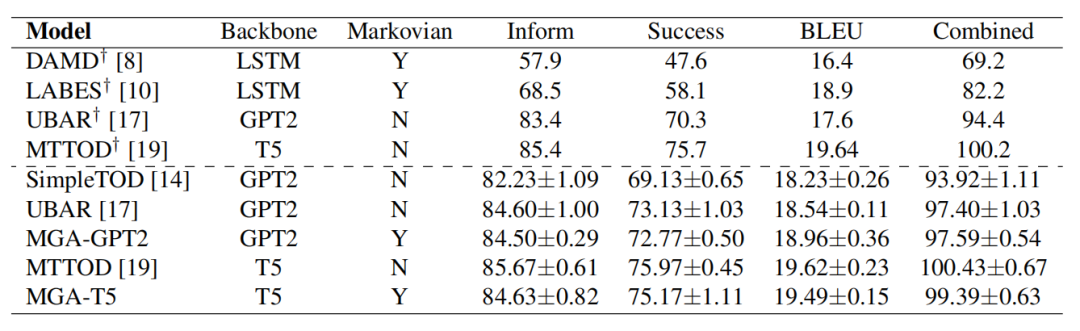
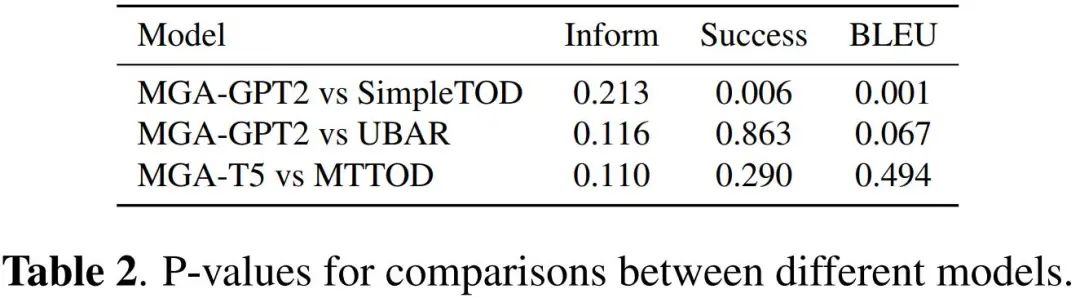
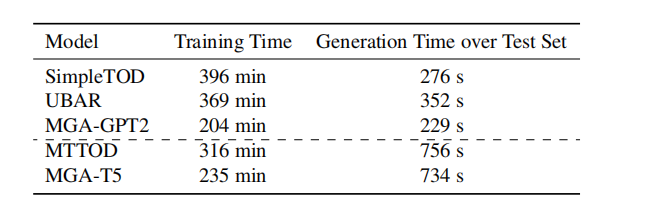
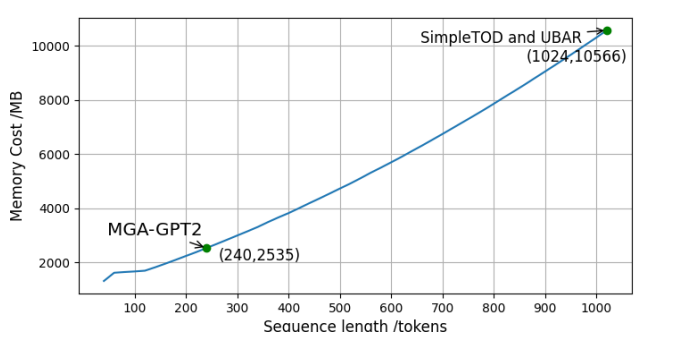
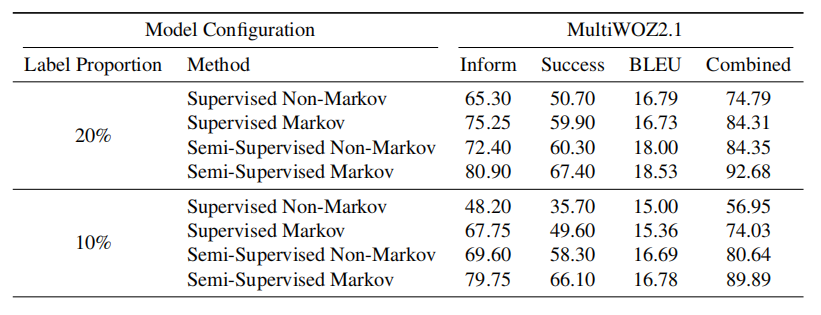
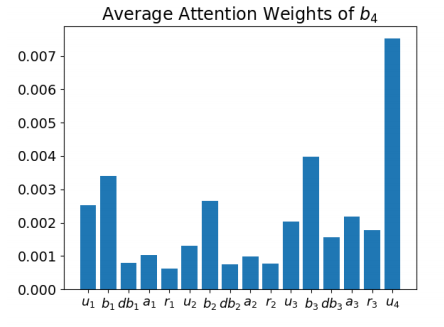
其中字母 u, b, a, r 分别表示用户话语,对话状态,系统动作和系统回复,下标则代表轮次。本文将MGA架构应用于两个主流的预训练语言模型——GPT-2和T5。实验数据集为广泛使用的多领域对话数据集MultiWOZ2.1,并采用其官网提供的评估脚本来验证系统性能。MGA与先前其它类型对话系统的比较结果如下。这是数据充分(rich-resource)情形,即在全部标注数据下训练模型。从表中结果可以看出,在以GPT-2为骨架时,MGA取得了略高于SOTA (UBAR)的结果,而以T5为骨架时,MGA的结果略低于SOTA (MTTOD)。进一步的显著度检验(Significance Test)表明,MGA与这两类非马尔可夫SOTA模型的性能无显著差异(p值均大于0.05)。值得指出的是,MGA-GPT2显著好于SimpleTOD非马尔可夫模型。本文对MGA训练和推理的时间开销,以及训练时的显存开销进行了统计,并同其他模型进行了对比。对比结果表明,MGA的时间和显存开销要显著低于其他模型,这得益于MGA使用马尔可夫架构,大大减小了输入序列的长度。本文进一步考察了低资源情形,即只有少部分数据有对话状态与对话动作的标注,比如只有10%和20%的标注数据,分别进行了有监督和半监督两种实验。无论哪种实验,MGA的结果都要明显好于非马尔可夫模型。这表明MGA在低资源情形下,其训练效率有明显优势。此外,本文还做了若干分析实验来帮助理解MGA架构比先前非马尔可夫架构之所以好的背后道理。本文对非马尔可夫模型UBAR进行了注意力分析,统计了在某一轮生成对话状态时,对于前面轮次信息的平均注意力值。下图分析结果表明,在生成当前轮的对话状态时,模型的注意力主要集中在前面所有轮次的对话状态中。注意对话状态是累积信息,也就是说上一轮的对话状态就已经包含了前面所有轮次对话状态的全部信息。因此在UBAR的一个训练样本中,其输入序列包含许多冗余的或者不必要的信息,影响了模型的训练效率,而MGA则没有这个问题,因而训练会更加高效。本文提出一种在预训练语言模型上的马尔可夫生成架构(MGA)来构建端到端对话系统。MGA建模利用了任务型对话系统中对话状态的累积特性(是一种马尔可夫状态),大幅缩减了模型输入序列的长度,从而提高模型的训练效率,减小时间和显存开销。实验表明,- 在资源丰富情形下,MGA的结果能够与非马尔可夫模型的SOTA齐平;
- 在低资源情形下,MGA的结果显著优于非马尔可夫模型。
MGA架构体现了用奥卡姆剃刀,化繁为简带来的好处。鉴于MGA的基础性,我们期待本文工作能够在对话系统的各项研究中产生积极意义。MGA的代码已在GitHub上开源,欢迎大家使用!代码开源链接:https://github.com/thu-spmi/MGA

 它思科技