
 它思科技
开源代码及模型:https://github.com/thu-spmi/CAT/blob/master/docs/cuside-array.md
摘 要
背 景
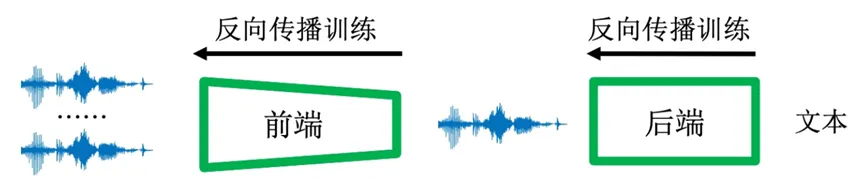
图1 传统的多通道语音识别方法
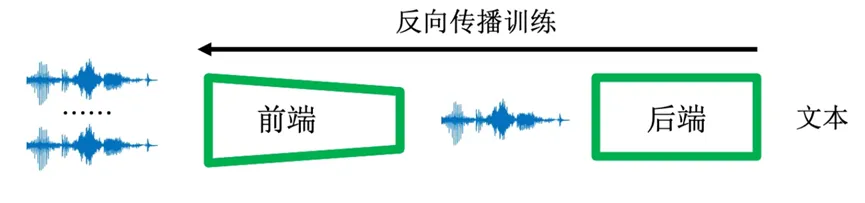
图2 多通道端到端语音识别方法
CUSIDE-Array方法
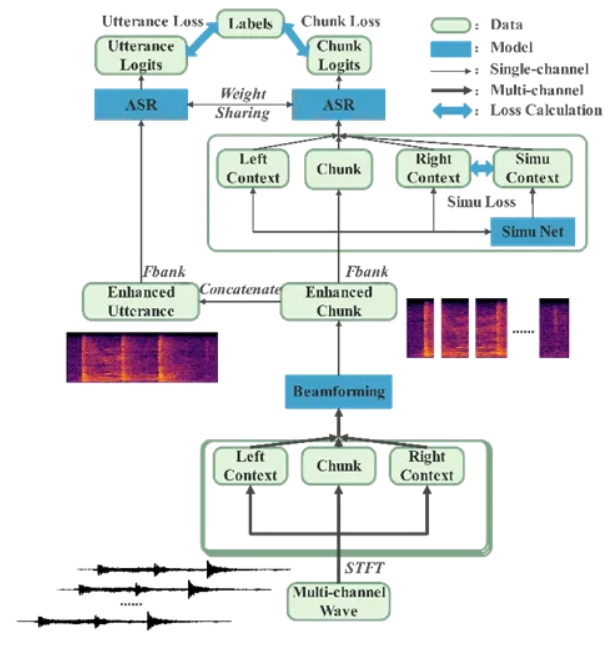
图3 CUSIDE-Array方法架构
上下文感知块:将输入的音频分割为400毫秒的chunks,每个chunk拼接前后帧的上下文信息,以增强识别精度。 基于掩码的神经波束形成:前端使用基于掩码的MVDR神经波束形成器,从多通道输入中增强语音信号,减少噪声,聚焦主要语音信号。 未来上下文模拟:神经网络模拟语音信号的未来帧,减少实际等待未来帧的时间,从而降低延迟。
现实评估:ID & OOD
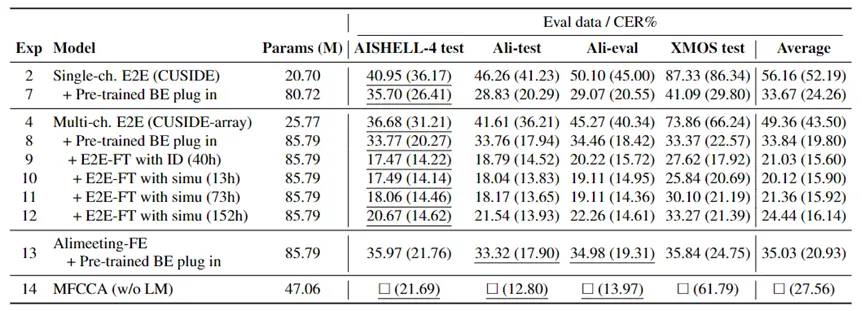
总 结
CUSIDE-Array方法展示了在流式ME2E ASR中的显著优势,不仅在ID测试中表现优异,更在各种OOD测试中展现了卓越的鲁棒性。未来,我们还将进一步探索CUSIDE-Array基础上集成流式去混响和多声源分离等相关技术。
CUSIDE-Array方法更多介绍,请见原文[3]。我们期待与您共同探讨和推进这一创新技术在语音识别领域的应用。
参考文献:
[1] Keyu An, Ji Xiao, Zhijian Ou. “Exploiting Single-Channel Speech for Multi-Channel End-to-End Speech Recognition: A Comparative Study,” ISCSLP, 2022.
[2] K. An, H. Zheng, Z. Ou, H. Xiang, K. Ding, and G. Wan. “CUSIDE: Chunking, Simulating Future Context and Decoding for Streaming ASR,” INTERSPEECH, 2022.
[3] X. Kong, T. Ning, H. Huang, and Z. Ou. “A Streaming Multi-Channel End-to-End Speech Recognition System with Realistic Evaluations,” arXiv:2407.09807.
