
 阿里语音AI
文章来源于阿里语音AI,作者达摩院语音实验室
我们日常可能会碰到一些录音质量不佳的场景。比如,想录制一段干净的语音却发现周围都很吵,录制的语音里往往混杂着噪声。当我们在噪杂的地铁或者巴士上通电话,为了让对方听清楚,不得不提高嗓门和音量。这都是因为环境噪声的影响,使我们在使用语音应用时出现障碍。这是语音通讯中一个普遍存在且又非常棘手的问题。语音质量(quality)和可懂度(intelligibility)容易受到环境噪声、拾音设备、混响及回声的干扰,使通话质量和交流效率大幅降低,如何在嘈杂的环境中保持较高的语音质量和可懂度一直以来是众多企业和学者追求的目标。
语音降噪问题通过多年研发积累,已经取得一定的突破,尤其针对复杂环境中的语音降噪问题,通过融入复数域深度学习算法,在性能上获得大幅度的提升,在保障更小语音失真度的情况下,最大限度地消除背景噪声,还原目标语音的清晰度,因而语音降噪模型也通常被叫做语音增强模型。
▏语音降噪模型能做什么?
语音降噪模型的作用是从污染的语音中提取目标语音,还原目标语音质量和可懂度,同时提升语音识别的效果和性能。我们的语音降噪模型只需要输入单麦克风的录音音频,便能够输出降噪后的干净语音音频,即保持音频的格式不变,仅消除音频中的噪声和混响部分,最大限度地保留原始语音。
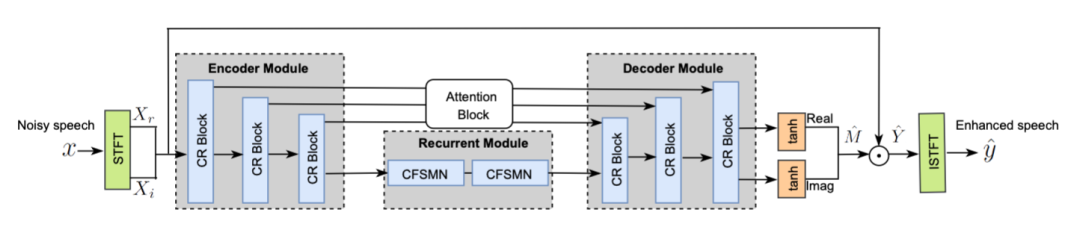
近期,我们在ModelScope上开放的FRCRN语音降噪-16K模型,是基于频率循环 CRN (FRCRN) 新框架开发出来的。该框架是在卷积编-解码(Convolutional Encoder-Decoder)架构的基础上,通过进一步增加循环层获得的卷积循环编-解码(Convolutional Recurrent Encoder-Decoder)新型架构,可以明显改善卷积核的视野局限性,提升降噪模型对频率维度的特征表达,尤其是在频率长距离相关性表达上获得提升,可以在消除噪声的同时,对语音进行更针对性的辨识和保护。 另外,我们引入前馈序列记忆网络(Feedforward Sequential Memory Network: FSMN)来降低循环网络的复杂性,以及结合复数域网络运算,实现全复数深度网络模型算法,不仅更有效地对长序列语音进行建模,同时对语音的幅度和相位进行同时增强。相关模型在IEEE/INTERSpeech DNS Challenge上有较好的表现。该模型神经网络结构如下图所示。
1.在线体验
复制该链接在浏览器中打开:
https://modelscope.cn/models/damo/speech_frcrn_ans_cirm_16k/summary

降噪后语音:
2.在Notebook中开发
from modelscope.pipelines import pipeline
from modelscope.utils.constant import Tasks


ans = pipeline(
Tasks.acoustic_noise_suppression,
model='damo/speech_frcrn_ans_cirm_16k')

wav_dict = {'/data/input/a1.wav': '/data/output/a1.wav',
'/data/input/a2.wav': '/data/output/a2.wav'}
for f1, f2 in wav_dict.items():
result = ans(f1, output_path=f2)
▏如何训练自有的智能降噪模型?
1.进行模型训练
环境准备
from modelscope.pipelines import pipeline
from modelscope.utils.constant import Tasks


ans = pipeline(
Tasks.acoustic_noise_suppression,
model='damo/speech_frcrn_ans_cirm_16k')
result = ans(
'https://modelscope.oss-cn-beijing.aliyuncs.com/test/audios/speech_with_noise.wav',
output_path='output.wav')
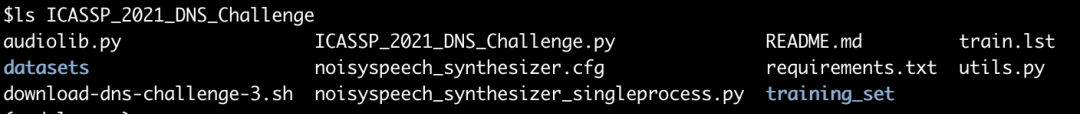
数据准备
模型训练
①复制官方模型
cp -r ~/.cache/modelscope/hub/damo/speech_frcrn_ans_cirm_16k ./
cd ./speech_frcrn_ans_cirm_16k
rm pytorch_model.binimportos
fromdatasets import load_dataset
frommodelscope.metainfo import Trainers
frommodelscope.msdatasets import MsDataset
frommodelscope.trainers import build_trainer
frommodelscope.utils.audio.audio_utils import to_segment
tmp_dir='./checkpoint'
ifnot os.path.exists(tmp_dir):
os.makedirs(tmp_dir)
hf_ds=load_dataset(
'/your_local_path/ICASSP_2021_DNS_Challenge',
'train',
split='train')
mapped_ds=hf_ds.map(
to_segment,
remove_columns=['duration'],
num_proc=8,
batched=True,
batch_size=36)
mapped_ds=mapped_ds.train_test_split(test_size=3000)
mapped_ds=mapped_ds.shuffle()
dataset=MsDataset.from_hf_dataset(mapped_ds)
kwargs=dict(
model='your_local_path/speech_frcrn_ans_cirm_16k',
train_dataset=dataset['train'],
eval_dataset=dataset['test'],
work_dir=tmp_dir)
trainer=build_trainer(
Trainers.speech_frcrn_ans_cirm_16k,default_args=kwargs)
trainer.train()tmp_dir = './checkpoint'
2.使用您的模型
from modelscope.pipelines import pipeline
from modelscope.utils.constant import Tasks


ans = pipeline(
Tasks.acoustic_noise_suppression,
model='/your_local_path/speech_frcrn_ans_cirm_16k')
result = ans(
'https://modelscope.oss-cn-beijing.aliyuncs.com/test/audios/speech_with_noise.wav',
output_path='output.wav')
代码中的http地址也可以换成您的本地音频文件路径,注意模型支持的音频格式是采样率16000,16bit的单通道wav文件。也可参考「在Notebook中开发」章节进行批量的音频文件处理。
▏语音降噪模型的典型应用场景
提取人声:
相关链接
References:
