
 阿里语音AI
说话人日志(Speaker Diarization, SD)任务的目标是检测不同说话人的语音活动时间段,即回答“谁在什么时间说话了”这一问题。
传统的说话人日志系统,往往基于聚类算法实现,一般包括成如下步骤:(1)使用语音端点检测将原始音频切分成语音片段;(2)使用说话人嵌入码提取模型;(3)使用聚类方法,例如K-means等将属于同个说话人的音频片段分组到一起。然而,这些聚类方法往往是无监督的,无法直接最小化说话人日志错误,从而导致次优结果。尽管之后也有一些有监督的聚类方法被提出,但是,不管是无监督还是有监督的聚类方法,它们都假设了每个语音片段只会对应单个说话人,因此无法解决混叠语音问题。
为了处理混叠语音,基于神经网络的端到端说话人日志方法(end-to-end neural diariza- tion ,EEND)将说话人日志重新定义成一个多标签分类问题,从而能直接优化说话人日志错误,并且拥有处理混叠语音的能力。进一步地,基于编解码结构的吸引子模型(encoder-decoder based attractor,EDA)被引入到EEND中,用于适配说话人数量不固定的情况。在此基础之上,也有一些二阶段的方法别提出,用于进一步提升说话人日志性能。
论文题目:TOLD: A NOVEL TWO-STAGE OVERLAP-AWARE FRAMEWORK FOR SPEAKER DIARIZATION
作者:王嘉明,杜志浩,张仕良
论文地址:https://arxiv.org/abs/2303.05397
代码仓库:https://github.com/alibaba-damo-academy/FunASR/tree/main/egs/callhome/TOLD
两阶段重叠敏感的说话人日志模型 TOLD
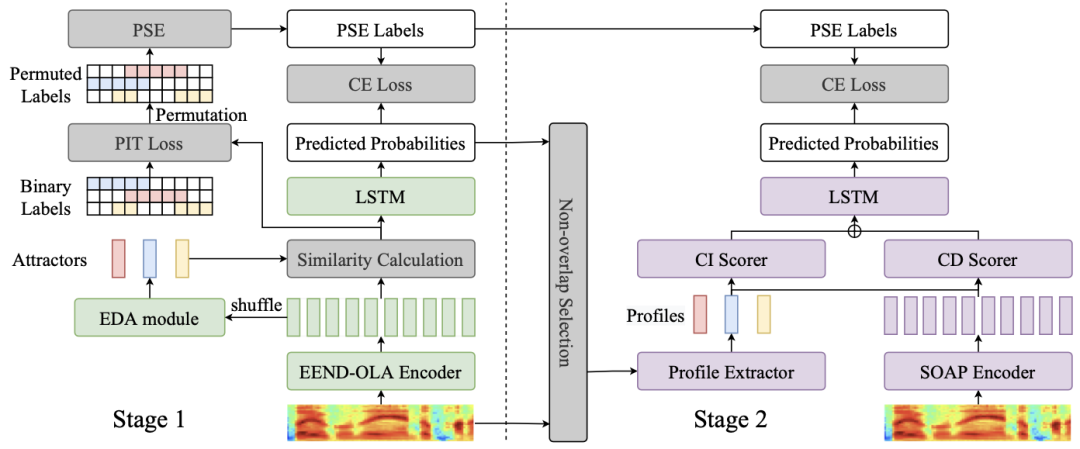
>>>第一阶段:说话人重叠敏感的端到端模型 EEND-OLA
在TOLD的第一阶段(如图 2左半部分所示),输入特征首先通过 Transformer 编码器得到声学特征,再送到由两层 LSTM 组成的 EDA 模块,预测得到该输入音频对应的说话人数量和每个说话人对应的说话人嵌入码(EDA论文中称为吸引子),然后,计算每个说话人嵌入和声学特征之间的相似度,并通过最小化 PIT 损失函数来确定说话人顺序(具体见论文)。在确定说话人的顺序后,我们就可以通过幂集编码 PSE 将原来的多维0/1标签转成单一类别标签:
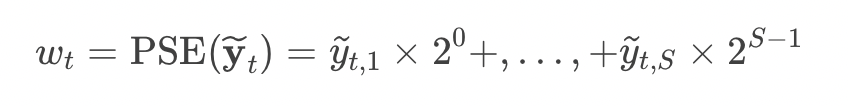
>>>第二阶段:说话人重叠敏感的后处理模型 SOAP
>>>EEND-OLA与其他端到端说话人日志模型的对比
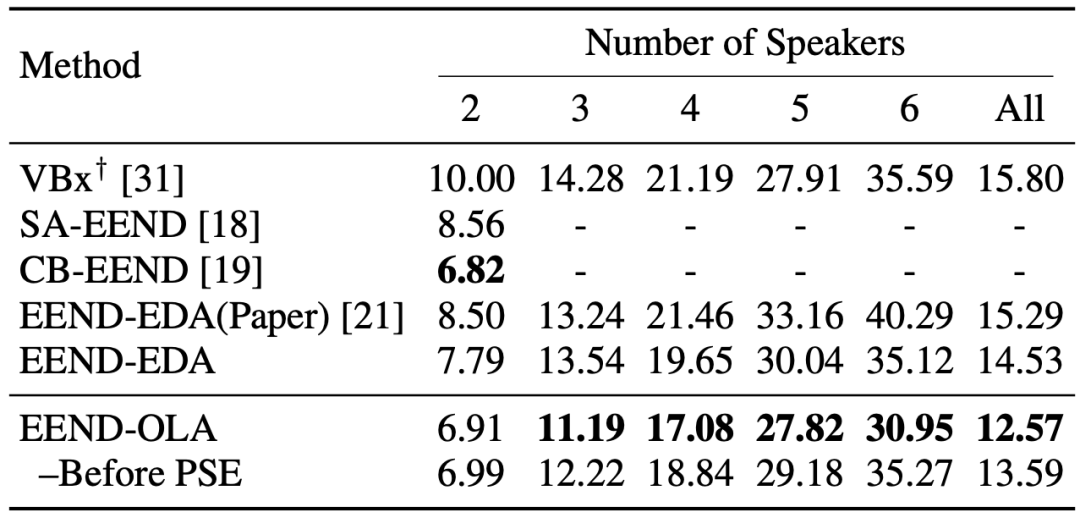
我们在常用的公开数据集 CALLHOME 上验证了TOLD的有效性。首先,为了验证 PSE 的作用,我们将第一阶段对应的 EEND-OLA 模型和其它的端到端模型进行了对比,具体结果如表1。
在2个说话人的情况下,EEND-OLA 和 CB-EEND 这种只能处理固定说话人数的模型的结果相近;而在考虑所有说话人数的情况下,相比于 EEND-EDA ,EEND-OLA 能够在 DER 指标上取得13.49%的相对提升,证明了混叠语音建模的有效性。
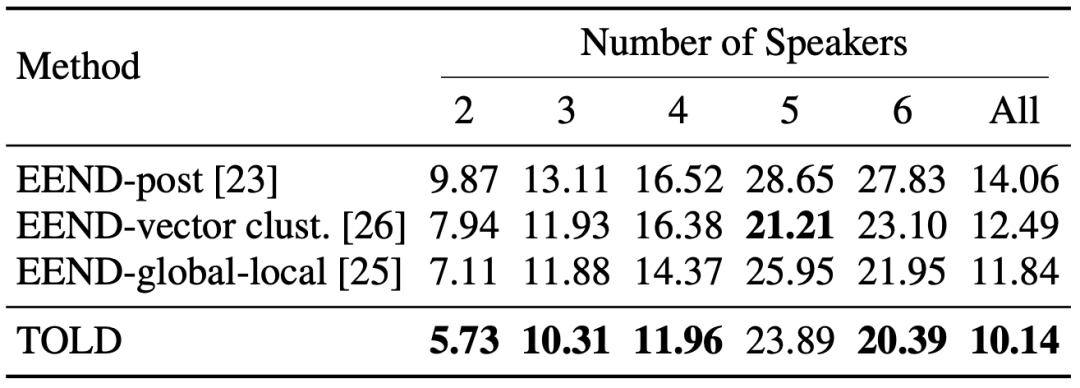
>>>TOLD与其他两阶段说话人日志模型的对比
表 2给出了 TOLD 和其它二阶段模型在 CALLHOME 数据集上的性能比较。其中,除了 TOLD 之外,剩余的几个二阶段模型都是 EEND 模型和聚类方法的结合。不同的是,TOLD 的两个阶段的模型都是基于神经网络的,这为后续统一成端到端系统提供了潜力。总的来讲,TOLD 在 CALLHOME 测试集上取得了10.14%的DER。这是在该测试数据集上的一个新的最优结果。
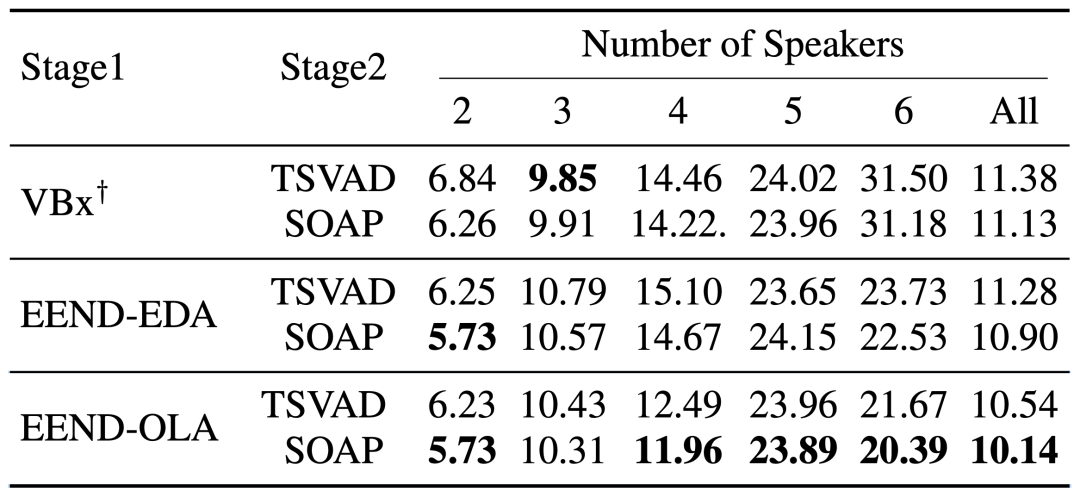
>>>两个阶段不同模型搭配的性能对比
为了进一步探索不同阶段使用不同模型对性能的影响,我们设计了消融实验,具体结果如表3所示。对于第一阶段,我们比较了 VBx、EEND-EDA和EEND-OLA。对于第二阶段,我们则比较了TSVAD 和 SOAP。根据表 1和表 3的结果,我们发现,在使用相同的第二阶段模型情况下,第一阶段模型的DER越低,整个系统的性能就越好。同时,我们发现无论使用哪种第二阶段模型,所提出的EEND-OLA 总是比 VBx 和 EEND-EDA 提供更好的性能。此外,我们还发现无论使用哪种模型作为第一阶段,SOAP 提供的 DER 都比 TSVAD 低,这表明 SOAP 可能更适合用于后处理。
表3 不同阶段使用不同方法在CALLHOME测试集上的性能比较
▎Future Work
在本论文中,我们首先提出了EEND-OLA,利用幂集编码,将说话者日志问题,从原来的多标签预测重新定义为单标签分类问题,实现了对于说话者依赖关系和混叠语音的显式建模。受最近被提出的二阶段混合系统的启发,我们进一步提出了 TOLD 框架,将 EEND-OLA 得到的初始说话人日志结果,通过重叠感知后处理 SOAP 进行迭代提升,并在 CALLHOME 测试集上实现了新的最优结果。同时,通过比较不同阶段使用不同方法的性能差异,我们证明了 EEND-OLA 和 SOAP 相比其它模型的优越性。未来,我们会尝试对 TOLD 进一步改进,增加自适应粒度的建模方式,使其能够处理不同时长的语音。
References:
[1]Zhihao Du, Shiliang Zhang, Siqi Zheng, and Zhijie Yan, “Speaker overlap-aware neural diarization for multi-party meeting analysis,” in EMNLP, 2022.
[2]Yusuke Fujita, Naoyuki Kanda, Shota Horiguchi, Kenji Nagamatsu, and Shinji Watanabe, “End-to-end neural speaker diarization with permutation-free objectives,” INTERSPEECH, pp. 4300– 4304, 2019.
[3]ShotaHoriguchi, YusukeFujita, ShinjiWatanabe, YawenXue, and Kenji Nagamatsu, “End-to-end speaker diarization for an unknown number of speakers with encoder-decoder based at- tractors,” in INTERSPEECH, 2020, pp. 269–273.
[4]Chunlei Zhang, Jiatong Shi, Chao Weng, Meng Yu, and Dong Yu, “Towards end-to-end speaker diarization with generalized neural speaker clustering,” in ICASSP, 2022, pp. 8372–8376.
[5]Shota Horiguchi, Shinji Watanabe, Paola Garc ́ıa, Yawen Xue, Yuki Takashima, and Yohei Kawaguchi, “Towards neural diarization for unlimited numbers of speakers using global and local attractors,” in ASRU, 2021, pp. 98–105.
