
 阿里语音AI
文章来源于阿里语音AI,作者通义语音团队
近日,2023届自然语言处理领域的国际顶级会议EMNLP (自然语言处理中的经验方法会议)在新加坡顺利召开,通义实验室语音团队共有三篇论文被大会收录。这些论文涵盖了主题分割、句子表征、代码翻译三个热门话题,亦是在语音语言技术方面的最新进展和创新成果,本文将对这三篇论文进行技术解析和应用展示。
主题分割
论文题目:Improving Long Document Topic Segmentation Models With Enhanced Coherence Modeling
论文作者:于海,邓憧,张庆林,刘嘉庆,陈谦,王雯
论文单位:阿里巴巴集团
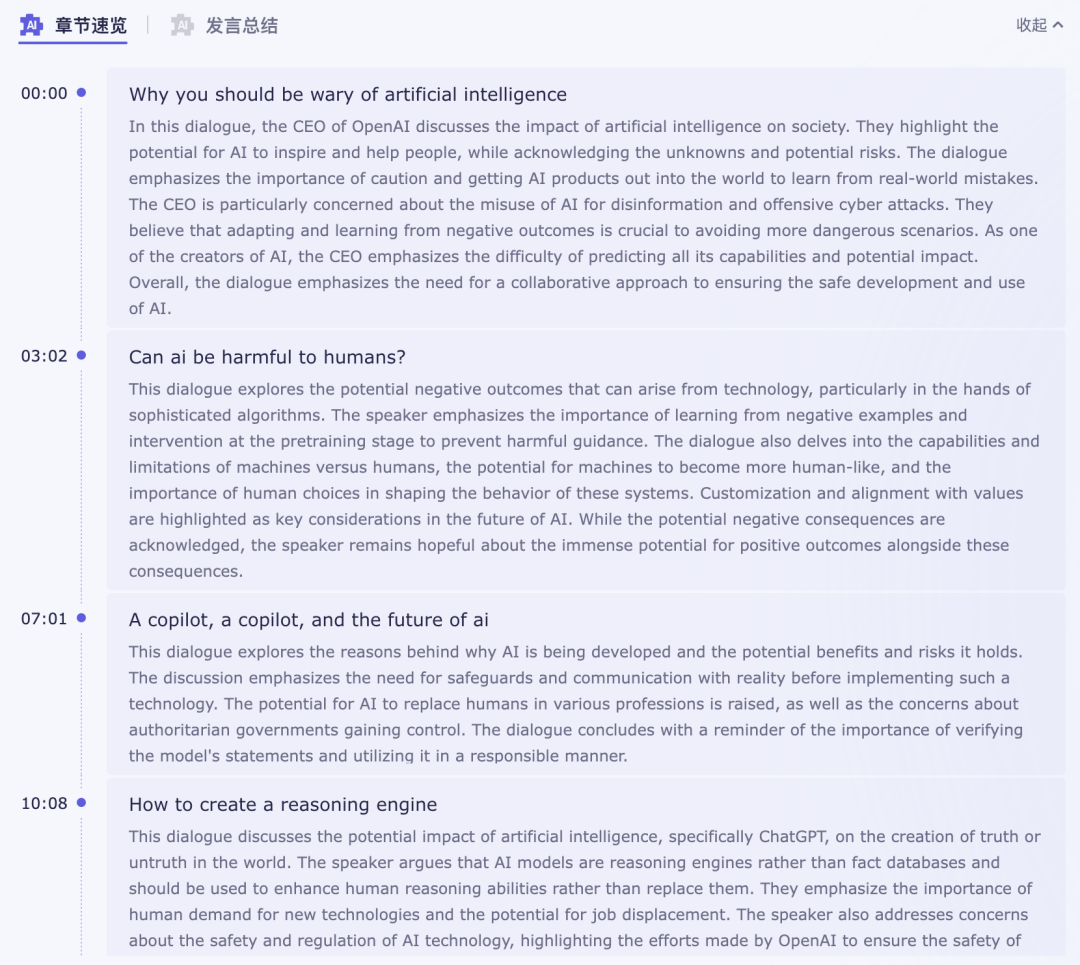
(通义听悟上的主题分割示例截图)
方法介绍
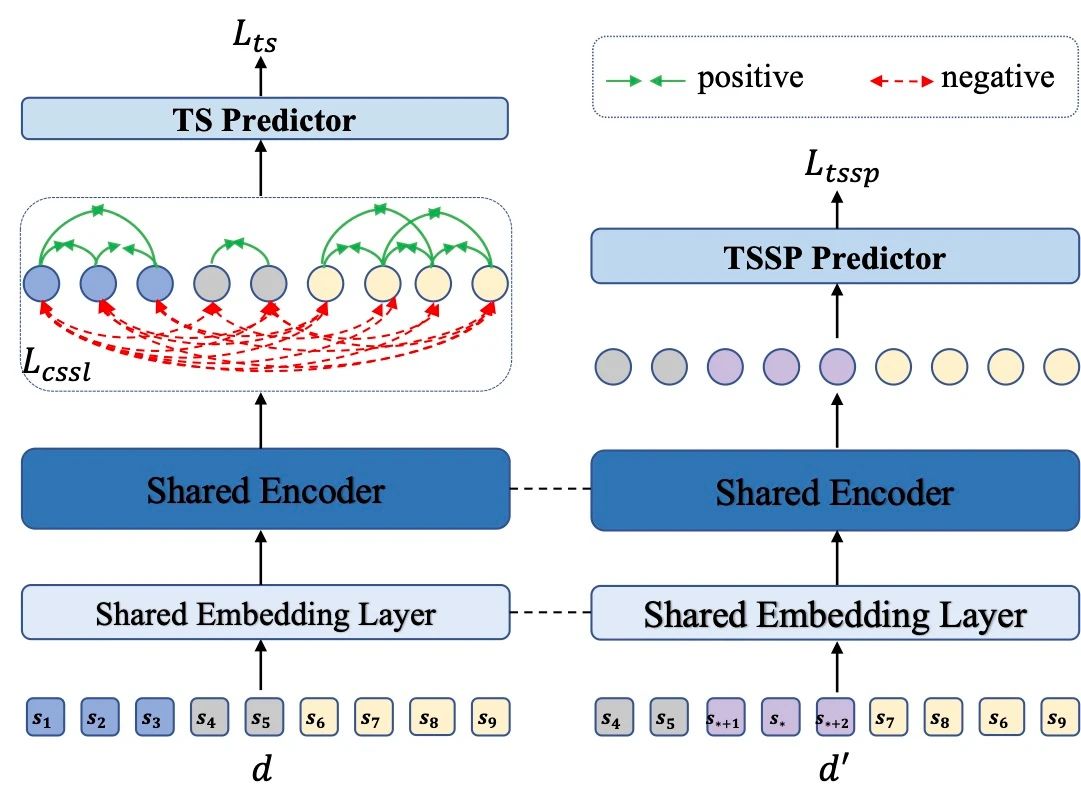
(图示:模型整体结构图)
为了让模型掌握句子对之间的逻辑结构,我们首先构造主题感知的增强数据,并与原始文档共享编码器。与之前工作提出的只是让模型预测增强文本的整体连贯性分数低于原始文档不同,我们在主题和句子两个层面同时扰动原始文档,并设计主题感知句子结构预测(TSSP)任务。TSSP任务用于预测增强文档中相邻两句话在原始文档中的逻辑结构关系,我们设计了三种句对关系,分别是属于不同主题、属于相同主题并且是前后句关系、属于相同主题但不是前后句关系,使用交叉熵损失函数优化模型参数。
实验分析
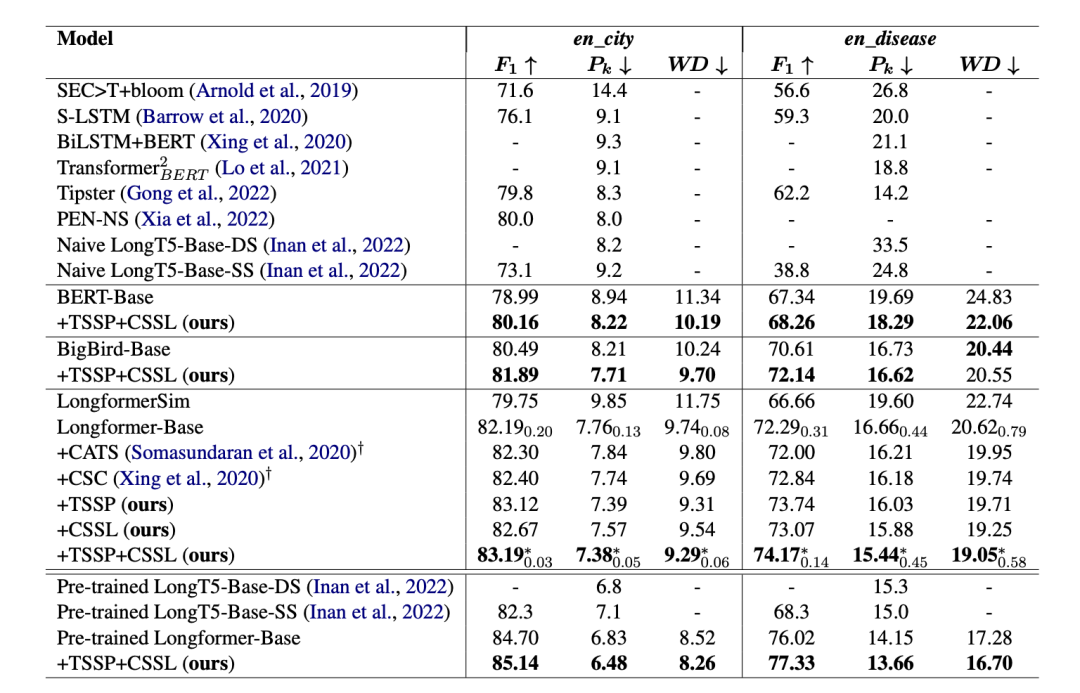
WikiSection的结果
如上表所示,我们尝试了不同的预训练语言模型作为编码器,包括 BERT-Base、BigBird-Base 和 Longformer-Base,实验结果显示我们的方法适用于各种基模型,并且在 Longformer-Base 上+TSSP+CSSL优于其他连贯性辅助任务(CATS,CSC)。除此之外,在微调之前加入预训练数据(WIKI-727K)继续预训练能够有效提升模型在下游任务的效果,并且加入我们的任务能进一步提升模型效果。
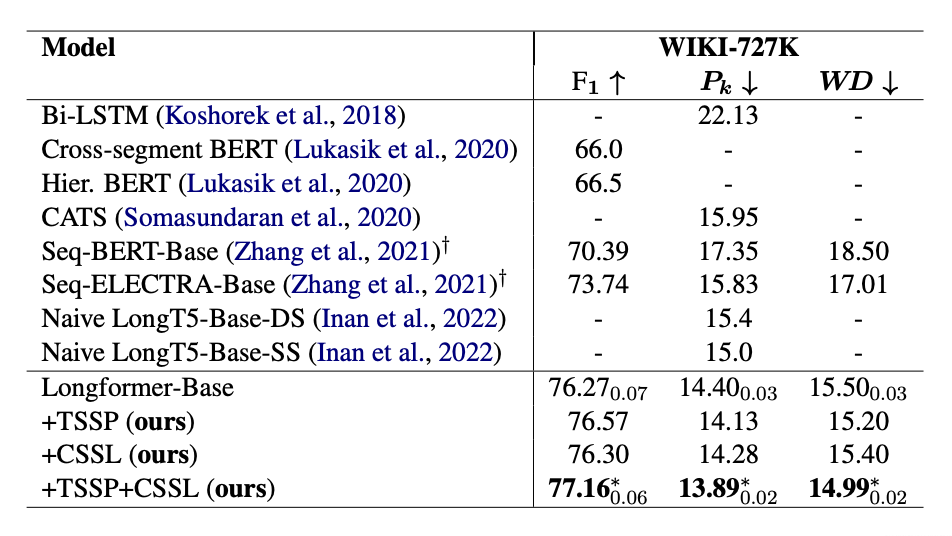
WIKI-727K的结果
如上表所示,我们的方法在WIKI-727K数据集显示了同样的效果,并且TSSP和CSSL的结合表现出互补的效果,证实了对句子逻辑结构和语义相似性进行建模以捕获文本连贯性对于主题分割任务的必要性。
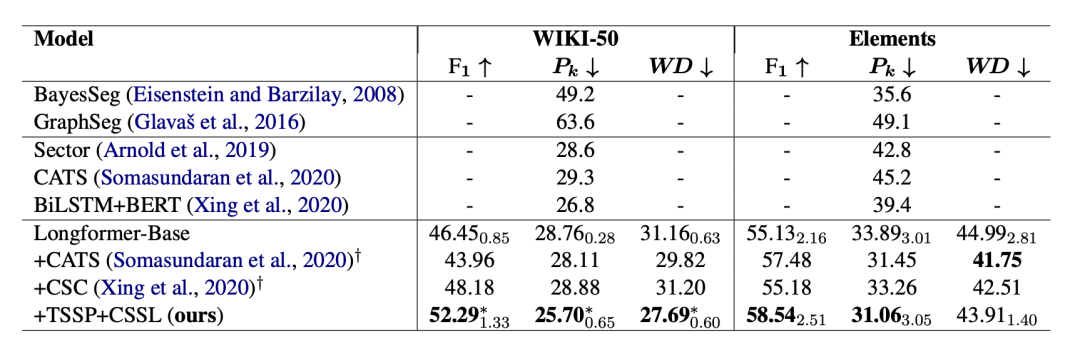
Out-of-domain的结果
上表展示了Out-of-domain配置下Longformer 在 WikiSection 训练,在 WIKI-50 和 Elements 测试的结果,实验结果显示我们的方法能够显著提升Longformer-Base的鲁棒性,并且多数情况下优于其他连贯性辅助任务。
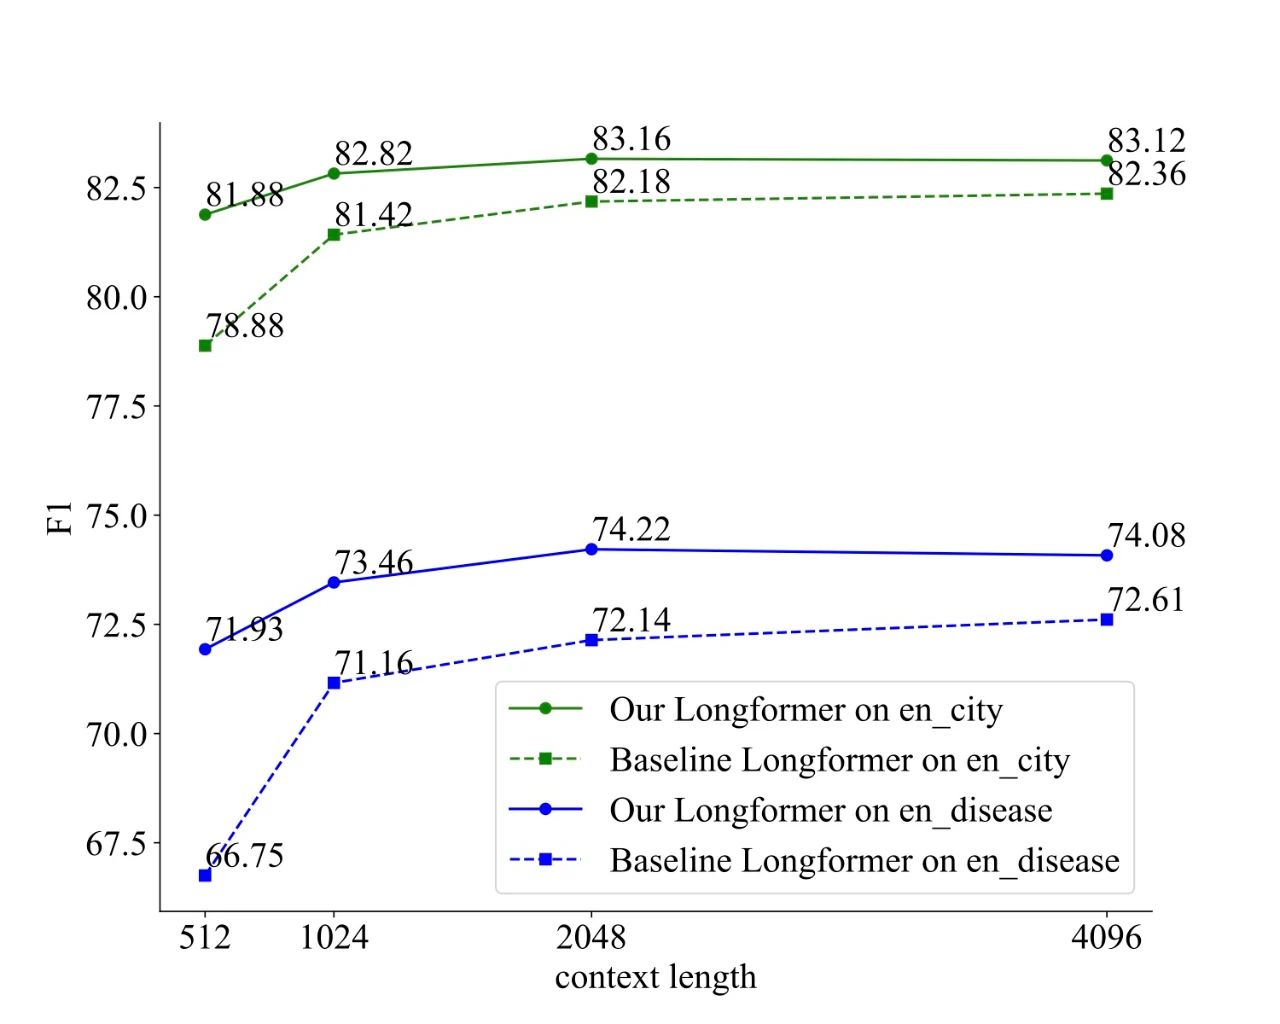
为了验证不同上下文长度的影响,我们在 WikiSection 上评估了最大序列长度分别为 512、1024、2048 和 4096 的 Longformer。从下图可以看出,随着上下文长度的增加,主题分割的 F1 指标逐渐提高。同时,与 Longformer-Base 相比,Longformer+TSSP+CSSL 在测试集上的不同输入长度配置下获得了一致的提升,这些结果表明我们的方法可以有效地增强跨不同上下文大小的主题分割。
句子表征
论文题目:Ditto: A Simple and Efficient Approach to Improve Sentence Embeddings
论文作者:陈谦,王雯,张庆林,郑斯奇,邓憧,于海,刘嘉庆,马煜坤,张冲
论文单位:阿里巴巴集团
论文地址:https://aclanthology.org/2023.emnlp-main.359/
开源地址:https://github.com/alibaba-damo-academy/SpokenNLP/tree/main/ditto
核心内容:
此前的研究诊断了预训练语言模型(例如BERT)在没有进行微调的情况下,其句子表示存在的各向异性问题。我们的分析揭示了BERT生成的句子嵌入对无信息词有偏向,这限制了它们在语义文本相似性(STS)任务中的性能。为了解决这种偏差,我们提出了一种简单而有效的无监督方法,即对角线注意力池化(Ditto),该方法利用基于模型的重要性估计对单词进行加权,并计算预训练模型中单词表示的加权平均值作为句子嵌入。Ditto可以轻松地作为后处理操作应用于任何预训练语言模型。与以往的句子嵌入方法相比,Ditto既不增加参数,也不需要任何学习。实证评估表明,我们提出的Ditto可以缓解各向异性问题,并改善各种预训练模型在STS基准上的表现。
方法介绍
观察1:强调了信息丰富单词的组合对于生成高质量句子嵌入的重要性。
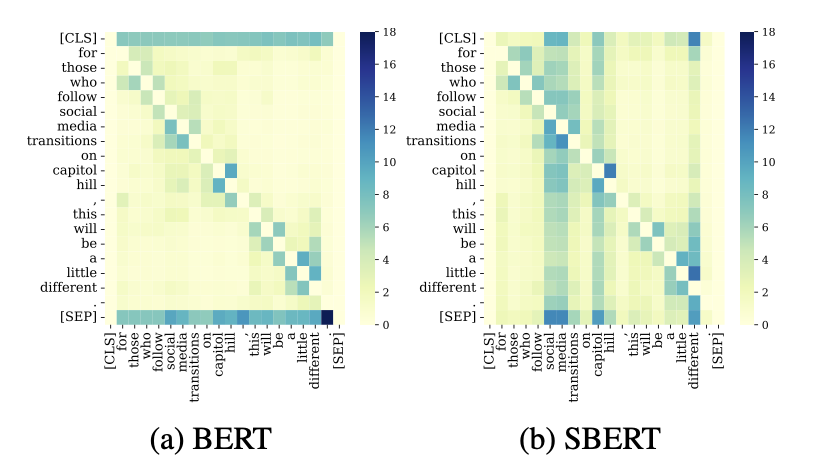
我们使用了一种无需参数的探究技术——扰动掩码,用于分析预训练语言模型(例如BERT)。该技术通过对每对标记(x_i, x_j)施加两阶段的扰动过程,来衡量一个标记x_j对预测另一个标记x_i的影响。与以往研究不同,我们使用扰动掩码技术来分析原始的BERT和强大的句子嵌入模型SBERT。
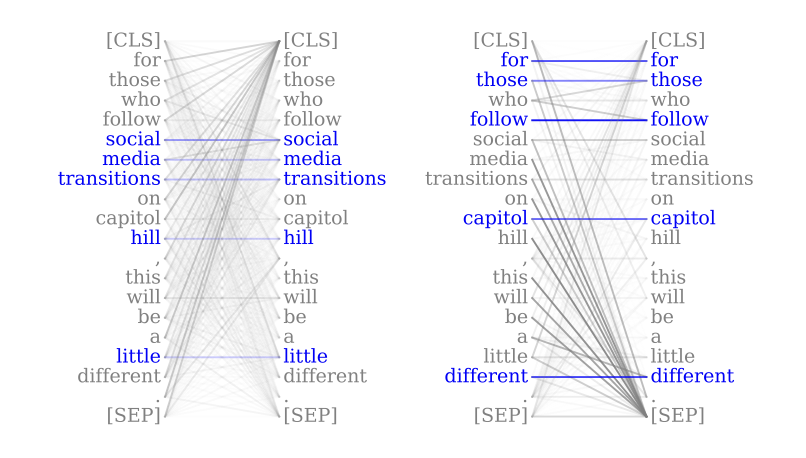
下图展示了代表英语PUD树库中示例句子的影响矩阵F的热图。比较BERT和SBERT的影响矩阵,发现SBERT的影响矩阵在诸如“social media”、“Capitol Hill”和“different”等信息丰富的标记上呈现出明显的垂直线,这表明信息丰富的标记对预测其他标记有很大的影响,因此掩盖这些标记可能严重影响句子中其他标记的预测结果。相比之下,BERT没有呈现这种模式。这一观察表明,信息丰富标记的组合可能是SBERT高质量句子嵌入的强有力指标。
此外,我们计算了影响矩阵与TF-IDF的相关性,发现SBERT的影响矩阵与TF-IDF的相关性要比BERT的影响矩阵高得多,这与上述观察一致。值得注意的是,ELECTRA在STS任务上表现不佳,并且与TF-IDF之间的相关性较弱。因此,我们推测原始的BERT和ELECTRA的句子嵌入可能存在对无信息单词的偏向,从而限制了它们在STS任务上的性能。
观察2:指出了BERT的某些自注意力头对应于单词的重要性。
尽管在观察1中已经验证SBERT与TF-IDF的相关性要高于BERT,但BERT仍然显示出了适度的相关性。因此,我们假设信息丰富单词的语义信息已经被编码在BERT中,但尚未被充分利用。以往的研究通过将BERT的每个自注意头视为一个简单的、无需训练的分类器来分析BERT的注意机制,该分类器可根据输入的单词输出其最关注的其他单词。
研究发现,某些自注意力头与语法和指代的语言概念相对应,例如,那些关注动词的直接宾语、名词的限定词、介词的宾语和指代性提及的自注意力头的准确性非常高。我们认为BERT中的注意力信息需要进一步利用。我们将特定的自注意力头表示为层-头编号(l-h),对于尺寸为BERT-base的模型,层的取值范围为1至12,头编号的取值范围为1至12。我们可视化了BERT每一层中每个头的注意权重,并关注信息丰富的单词。
某些自注意力头的从单词到自身的自注意力(即注意力矩阵的对角线值,称为对角线注意力)可能与单词的重要性相关。正如下图所示,信息丰富的单词“social media transitions”、“hill”和“little”在头1-10的注意力矩阵的对角线值较高。BERT头部1-10的注意力权重示意图(左侧)和头部11-11的注意力权重示意图(右侧)。线条的深浅代表着注意力权重的数值。注意力矩阵的前五个对角线数值用蓝色标示。
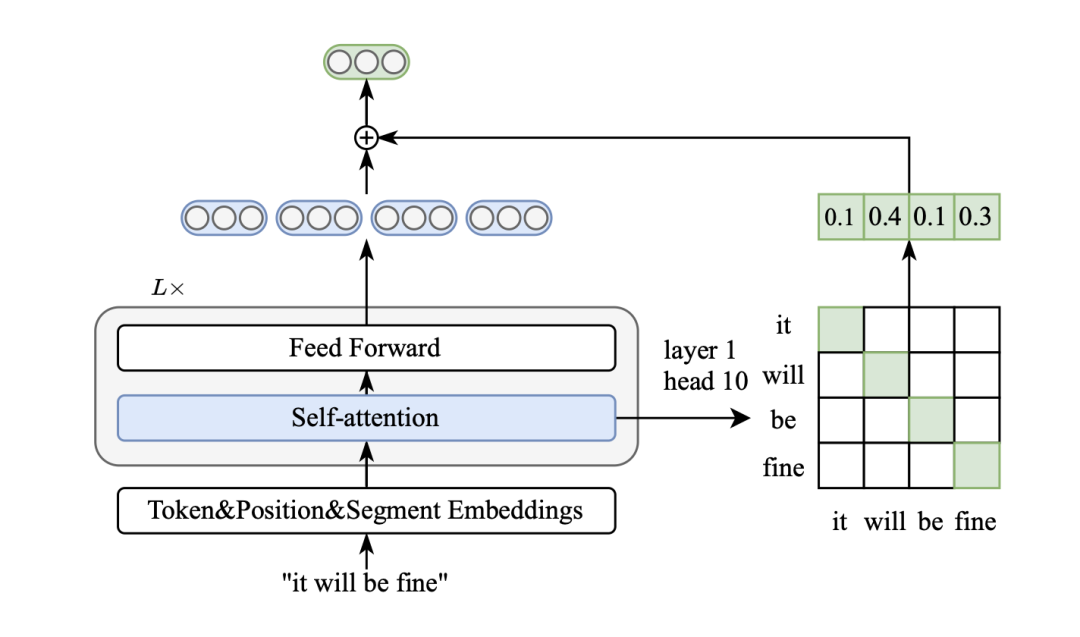
根据在观察部分的两个发现,我们提出了一种新的无需训练的方法,称为"Diagonal Attention Pooling"(Ditto),旨在改善PLM的句子嵌入。该方法通过权衡某个头部的对角线注意力来加权隐藏状态,从而获得更好的句子嵌入。Ditto通过计算BERT特定头部的注意力矩阵的对角线值,然后利用这些值加权计算句子嵌入。与基于计算影响矩阵的方法相比,Ditto更加高效,因为影响矩阵的计算代价较高。该方法的有效性得到了实验证实,同时也具有更高的计算效率。示意图如下图所示。
实验分析
在之前的研究基础上,我们对7个常见的STS数据集进行了实验,这是一个用于评估句子嵌入的广泛使用的基准。
主要结果
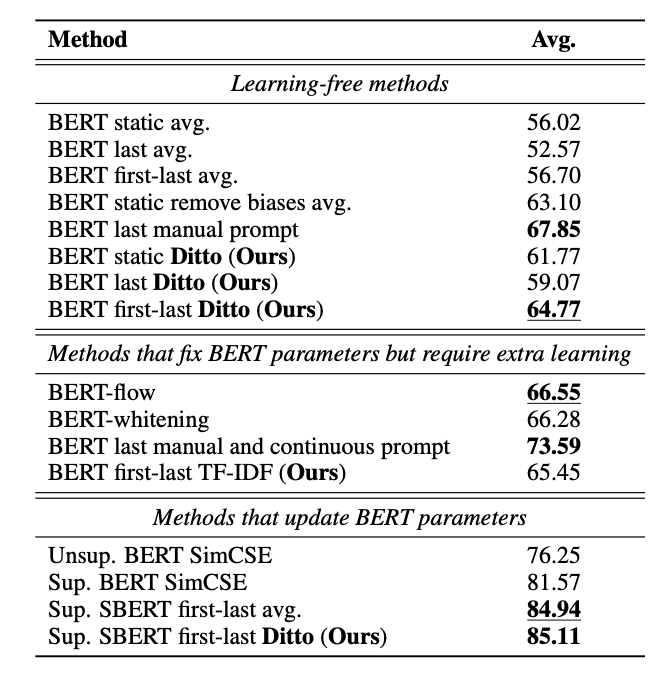
下表的第一组呈现了三种常见的learning-free方法(静态平均、最后平均和首尾平均),以及两种最近learning-free方法的结果。尽管"last manual prompt"取得了67.85的成绩,但不同的模板对其性能有显著影响,在STS-B dev集上的得分范围从39.34到73.44。将Ditto应用于"静态平均"、"最后平均"和"首尾平均"分别实现了+5.75、+6.50和+8.07的绝对增益。下表的第二组呈现了固定BERT参数但需要额外学习的方法的结果。
需要注意的是,我们的learning-free方法"BERT首尾Ditto"在这一组中的性能与BERT-flow和BERT-whitening相当。为了进一步分析Ditto,我们对从英文维基百科中随机抽取的100万个句子计算TF-IDF权重作为标记重要性权重,并将首尾隐藏状态的加权平均作为句子嵌入,标记为"首尾TF-IDF"。"首尾TF-IDF"相对于"首尾平均"基线实现了+8.75的绝对增益,仅比我们的learning-free Ditto(仅在1500个样本上进行了l和h的搜索)的+8.07略有改善。
下表的第三组呈现了通过无监督或监督学习更新BERT参数的强基线方法的结果,包括无监督SimCSE、监督SimCSE和监督SBERT。我们发现,即使在高竞争的监督学习方法"Sup. SBERT首尾平均"上应用Ditto也实现了0.17(84.94→85.11)的绝对增益,表明Ditto也可以改善强监督句子嵌入方法的性能。需要注意的是,由于SimCSE使用[CLS]表示作为句子嵌入而非平均池化,因此SimCSE不适合应用Ditto。
(图示:不同预训练模型影响)
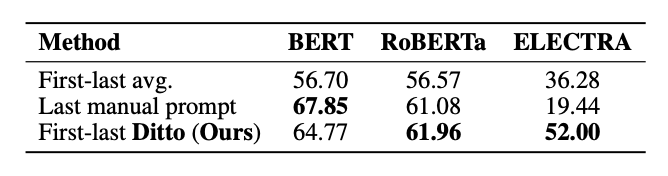
在不同的预训练语言模型(PLMs)上,下表对比了基线方法“首尾平均”和“last manual prompt”以及我们的“首尾Ditto”的效果。需要注意的是,“last manual prompt”对ELECTRA不适用,因为该方法依赖于使用[MASK]标记作为句子嵌入,而ELECTRA判别器在训练时没有使用[MASK]标记。在不同的PLMs上,“Ditto”在ELECTRA上始终表现良好,并且大大优于RoBERTa和ELECTRA上的两个基线方法,但在BERT上的表现却不如“last manual prompt”。
代码翻译
论文作者:Weixiang Yan,Yuchen Tian,Yunzhe Li,陈谦,王雯
论文单位:加利福尼亚大学圣芭芭拉分校、香港大学、伊利诺伊大学厄巴纳-香槟分校、阿里巴巴集团
论文地址:https://aclanthology.org/2023.findings-emnlp.337/
开源地址:https://github.com/WeixiangYAN/CodeTransOcean
核心内容
最近的代码翻译技术利用神经机器翻译模型将源代码从一种编程语言翻译成另一种,以满足生产兼容性或提高代码库维护的效率。大多数现有的代码翻译数据集只关注单一对流行的编程语言。为了推动代码翻译的研究并满足现实应用的多样化需求,我们构建了CodeTransOcean,这是一个支持最多种编程语言的大规模综合基准测试。
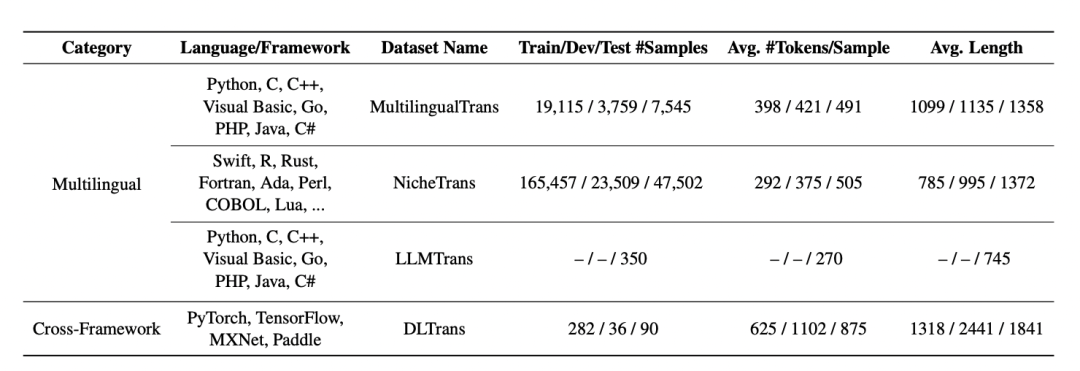
CodeTransOcean包括三个新颖的多语言数据集,分别是支持多种流行编程语言之间翻译的MultilingualTrans,用于在小众编程语言和流行编程语言之间进行翻译的NicheTrans,以及用于评估大语言模型(LLMs)翻译代码的可执行性的LLMTrans。CodeTransOcean还包括一个新颖的跨框架数据集DLTrans,用于在不同框架之间进行深度学习代码的翻译。
我们开发了多语言建模方法用于代码翻译,并展示了它们在提高低资源和高资源语言对的翻译质量以及提高训练效率方面的巨大潜力。我们还提出了一个用于程序级代码翻译的新颖评估指标“Debugging Success Rate@K”。最后,我们在我们的数据集上评估了LLM ChatGPT,并调查了它在模糊执行预测方面的潜力。我们为CodeTransOcean建立了基线,并分析了代码翻译的挑战,以指导未来的研究。
方法介绍
本部分详细描述和分析了我们的CodeTransOcean基准测试,包括代码翻译任务、相关数据集和数据集统计。需要注意的是,CodeTransOcean中绝大多数样本都提供了明确的输入和输出,相当于单元测试。
总体来说,CodeTransOcean包含了270,507个样本(超过20万个单元测试),涵盖了45种编程语言用于多语言代码翻译以及4种深度学习框架用于跨框架代码翻译。需要注意的是,所有CodeTransOcean数据集中的样本都是在程序级别构建的。我们在构建数据集时确保了每种语言/框架的平衡分布。CodeTransOcean数据集与现有的代码翻译数据集没有重叠。
如下表,我们的CodeTransOcean总结。我们报告了每个数据集的训练/开发/测试集的#样本、平均#标记/样本和平均长度。请注意,LLMTrans仅用于测试。#样本是基于程序级别的。#标记是基于RoBERTa分词器。长度指的是字符的数量。
多语言代码翻译
随着在多语言编程环境中实施系统集成或扩展需统一语言的需求日益增加,我们构建了MultilingualTrans数据集,用于多种流行编程语言的翻译。我们从TIOBE编程语言排名中选择排名前十的语言作为流行语言,并将其作为MultilingualTrans数据集的基础,构建了涵盖八种编程语言的数据集。我们将排名中其他语言视为小众语言,并构建了NicheTrans数据集,用于在小众语言和流行语言之间进行翻译。此外,为了定量评估由LLMs生成的代码的执行能力,我们构建了LLMTrans数据集,其中包括了MultilingualTrans的子集的执行结果,有助于评估LLMs在多语言代码翻译中的性能。
跨框架代码翻译
我们提出了“跨深度学习框架翻译”任务,旨在通过代码翻译实现不同深度学习框架之间的代码迁移。我们构建了DLTrans数据集,包括四种深度学习框架和十二个方向。据我们所知,这是首个定义跨深度学习框架翻译任务并构建相应数据集的工作。我们创建了两种不同粒度的子集,即程序级别的“粗粒度”和函数或类级别的“细粒度”。每个代码对包括了在不同流行深度学习框架中具有相同功能的代码。在本工作中,我们仅在“粗粒度”子集上进行了实验。
实验分析
本部分内容主要涉及两个方面的实验:多语言代码翻译训练(Multilingual Modeling)、ChatGPT在代码翻译中的应用。
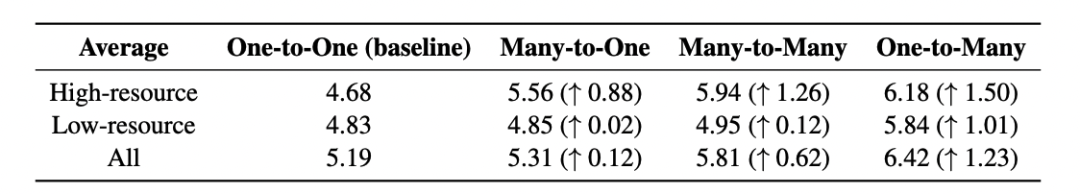
首先,在多语言代码翻译训练方面,我们使用CodeTransOcean的数据集,探索了四种基于数据共享的多语言建模策略,包括One-to-One、One-to-Many、Many-to-One和Many-to-Many。
实验结果表明,不同策略对各种资源丰富度的语言的性能影响不同。我们发现,高资源语言能更有效地利用跨多个源语言的共享信息,而低资源语言相对不太适合处理共享参数引入的额外不确定性和噪音,因此往往需要依赖更多的源语言数据来优化它们的效果。具体结果如下表所示:
在ChatGPT在代码翻译中的应用方面,我们研究了ChatGPT在代码翻译中的效果,并探讨了不同提示和超参数设置的影响。
我们还提出了一种新的评估指标Debugging Success Rate@K,用于程序级代码翻译的评估,这是第一个准确反映实际软件开发情景的指标。
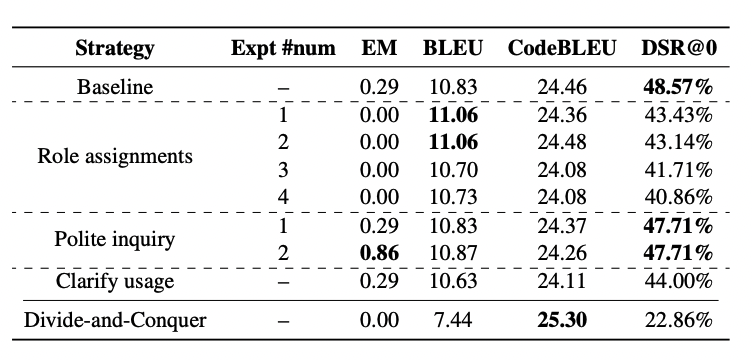
我们发现,相对于复杂的提示策略,最直接的提示策略能够产生最佳性能,而温度和top_p参数的独立变化并不明显改变ChatGPT的性能。此外,我们探索了自我调试对ChatGPT性能的影响,发现多轮自我调试明显提高了ChatGPT的性能。
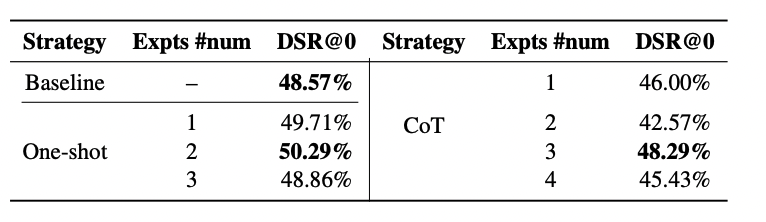
此外,我们还研究了one-shot和Chain-of-Thought策略对ChatGPT性能的影响,发现one-shot可以显著提高ChatGPT的性能,而Chain-of-Thought策略可能会降低翻译的可执行性。
如下表所示,ChatGPT在zero-shot情况下使用不同提示变体和上下文策略的性能。
如下表所示,与zero-shot基准线相比,ChatGPT使用one-shot和CoT策略的性能。
总体而言,我们的研究结果为代码翻译的实践应用提供了一些有益的启示,但也指出了一些潜在的限制和改进方向。这些发现为未来在代码翻译领域的研究和实践提供了重要参考和指导。
