
 阿里语音AI
如何体验语音合成模型效果
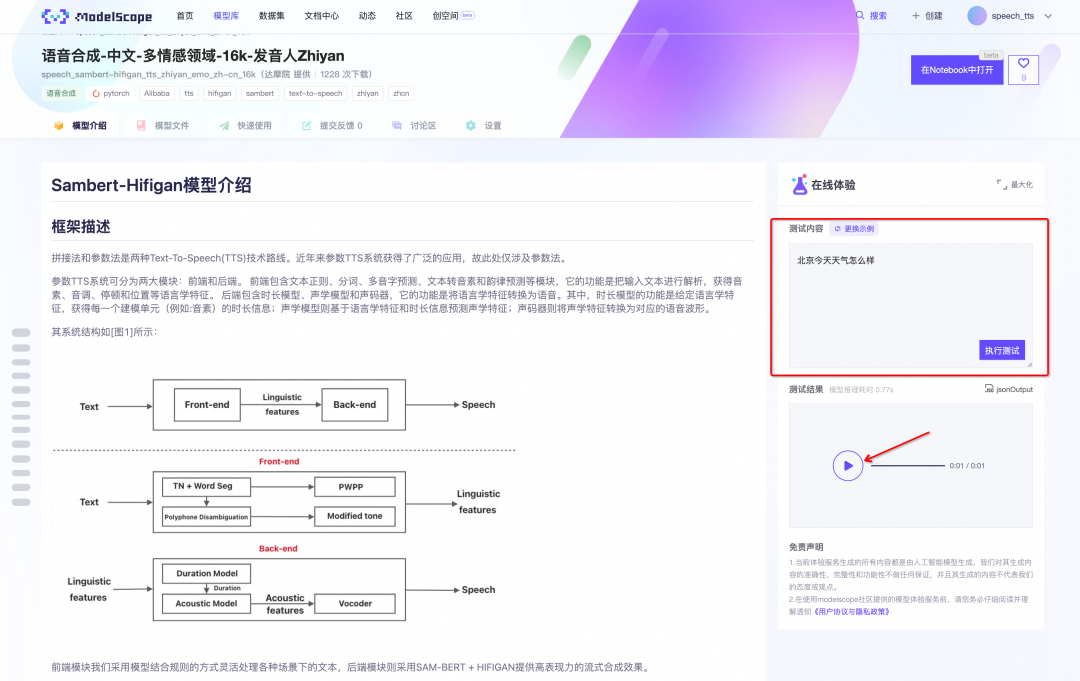
1. 在线体验
2. Notebook开发体验
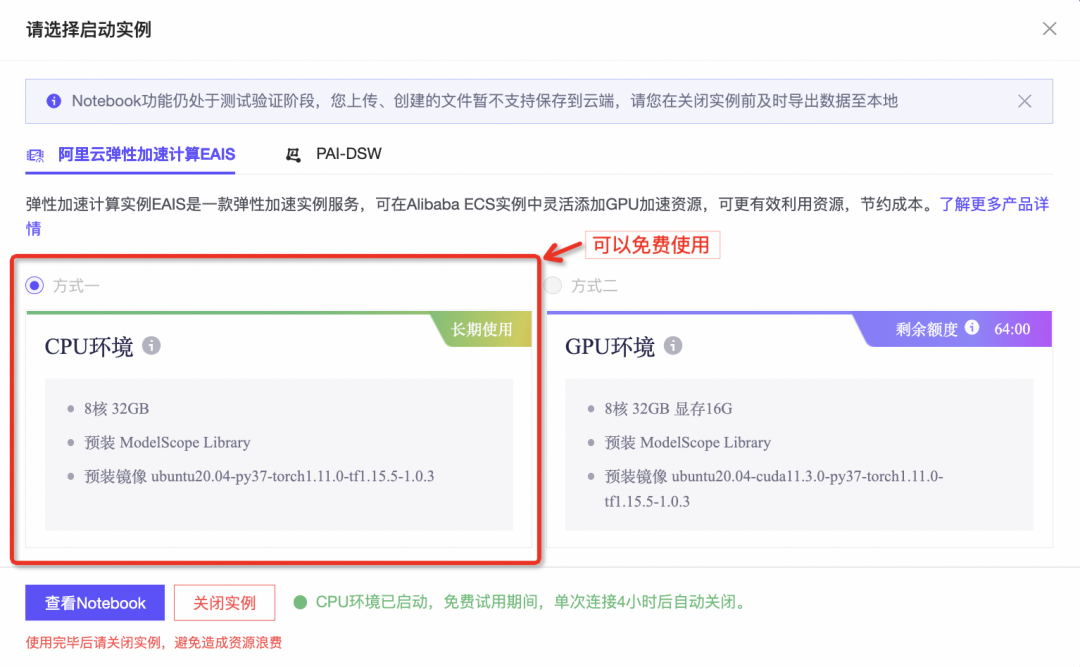
随后会出现选择开发环境的页面,此处我们推荐使用CPU环境,当前可以免费使用。
请注意以上操作需要的前提条件:
①注册一个阿里云账号
②注册一个ModelScope网站账号
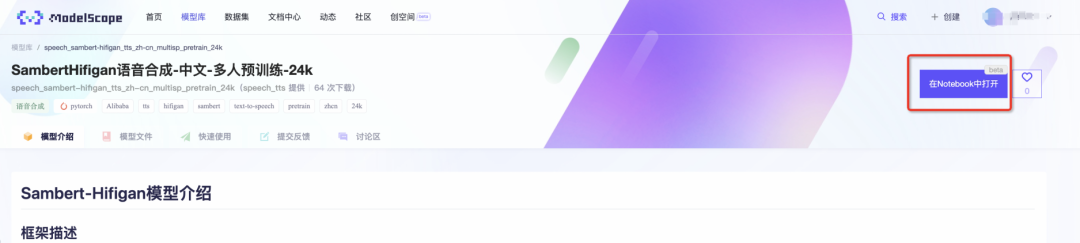
先登录ModelScope账号,点击模型页面右上角的“在Notebook中打开”按钮出现对话框。首次使用会提示您关联阿里云账号,按提示操作即可。
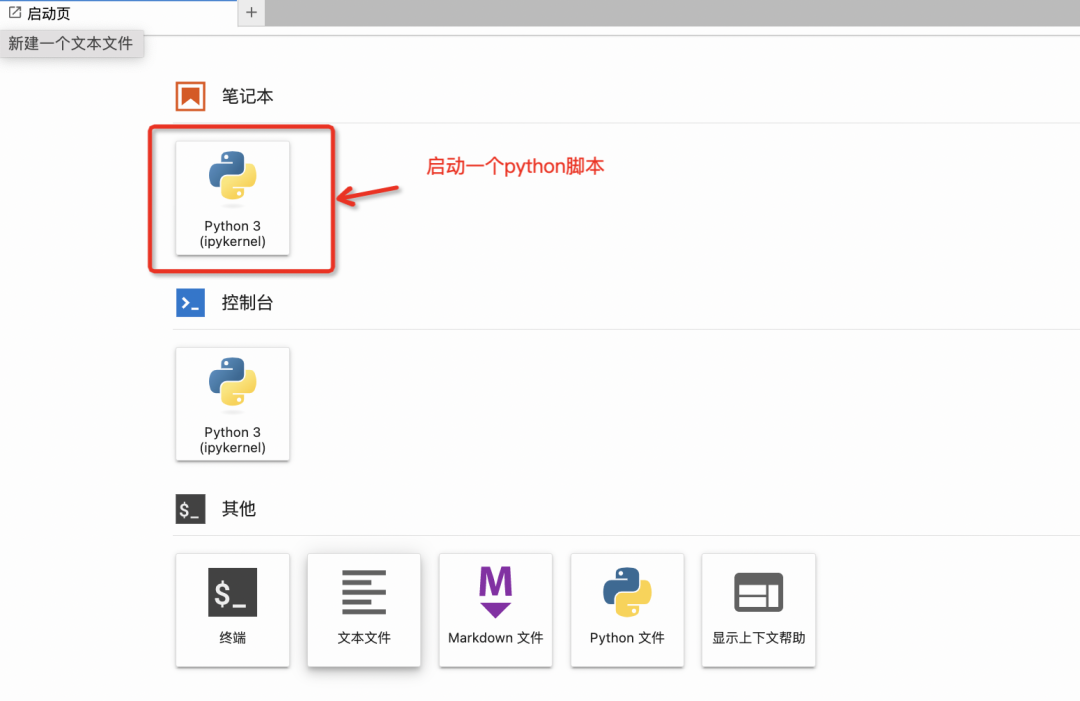
待进入Notebook开发环境后我们选择新建Notebook脚本
将模型主页的示例代码粘贴到Notebook代码块中,并将text替换成想要合成的文本,运行代码块,随后即可在左侧文件栏中获得合成的语音文件,可下载到本地进行试听。

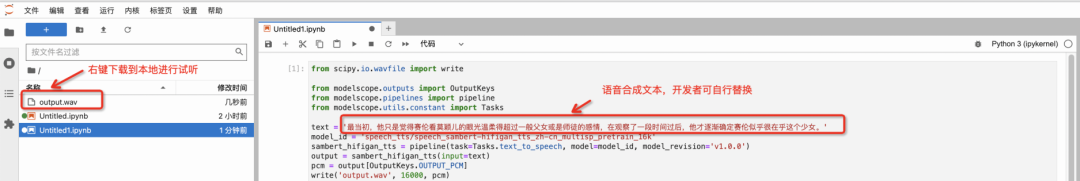
执行Notebook代码块
如何训练一个定制语音合成模型
环境搭建
git clone https://github.com/AlibabaResearch/KAN-TTS.git
cd KAN-TTS
我们推荐使用Anaconda来搭建Python虚拟环境,使用以下命令创建(目前只兼容Linux x86系统):
# 防止使用pip安装时出现网络问题,建议切换国内pip源
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

# 创建虚拟环境
conda env create -f environment.yaml

# 激活虚拟环境
conda activate maas.
├── interval
│ ├── 500001.interval
│ ├── 500002.interval
│ ├── 500003.interval
│ ├── ...
│ └── 600010.interval
├── prosody
│ └── prosody.txt
└── wav
├── 500001.wav
├── 500002.wav
├── ...
└── 600010.wav通用格式数据如下:
.
├── prosody
│   └── prosody.txt
└── wav
├── 1.wav
├── 2.wav
├── ...
└── 9000.wavwav文件夹下存放了音频文件,prosody文件夹下的.txt文件对应的是音频文件的文本标注,interval文件夹下存放的是音素级别的时间戳标注,通常情况下通用格式数据不会携带时间戳标注,这是两种格式的区别。
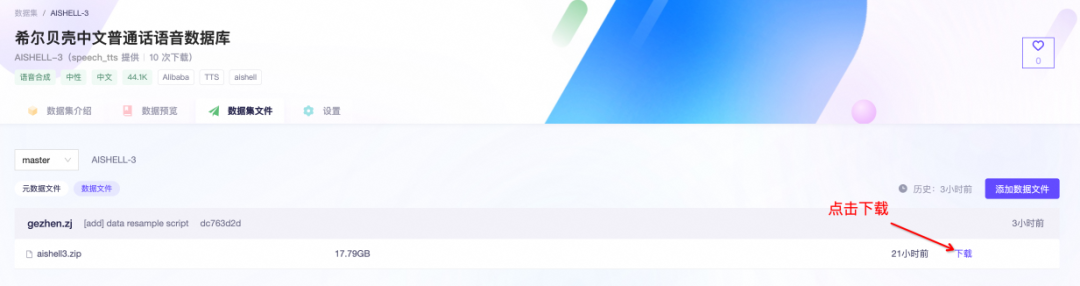
unzip aishell3.zipAISHELL-3包含两百多个发音人录音,每个发音人数据量在20~30分钟不等,这里我们选择其中的一个发音人进行数据处理,以SSB0009为例(开发者也可自行选择其他发音人),训练一个16k采样率的语音合成模型。
由于原始音频采样率为44k,我们先对音频做重采样,这里需要用到该数据集的元数据仓库脚本
# 拉取元数据仓库,并做重采样处理
git clone https://www.modelscope.cn/datasets/speech_tts/AISHELL-3.git
./AISHELL-3/aishell_resample.sh aishell3 aishell3_16k 16000kantts/configs/audio_config_16k.yaml--speaker代表该数据集对应发音人的名称,用户可以随意命名。python kantts/preprocess/data_process.py --voice_input_dir aishell3_16k/SSB0009 --voice_output_dir training_stage/SSB0009_feats --audio_config kantts/configs/audio_config_16k.yaml --speaker SSB0009training_stage/SSB0009_feats目录下得到如下结构的文件:# 基于阿里标准格式数据所提取出的特征目录
├── am_train.lst
├── am_valid.lst
├── audio_config.yaml
├── badlist.txt
├── data_process_stdout.log
├── duration
├── energy
├── f0
├── frame_energy
├── frame_f0
├── frame_uv
├── mel
├── raw_duration
├── raw_metafile.txt
├── Script.xml
├── train.lst
├── valid.lst
└── wav至此数据准备工作就算完成了。
获取预训练模型
# 克隆预训练模型
git clone -b pretrain http://www.modelscope.cn/speech_tts/speech_sambert-hifigan_tts_zh-cn_multisp_pretrain_16k.git
微调声学模型
sambert/config.yaml作为训练配置文件。speaker_list配置项:# 将speaker_list其中一个发音人替换为aishell3发音人
linguistic_unit:
cleaners: english_cleaners
lfeat_type_list: sy,tone,syllable_flag,word_segment,emo_category,speaker_category
speaker_list: SSB0009,F74,FBYN,FRXL,M7,xiaoyu
以及train_max_steps配置项,我们希望在basemodel 980k的基础上,继续微调120k
# 将train_max_steps改为1100100
...
train_max_steps: 1100100
...
完成上述必要的配置项修改后,我们就可以使用以下命令训练声学模型了:
CUDA_VISIBLE_DEVICES=0 python kantts/bin/train_sambert.py --model_config speech_sambert-hifigan_tts_zh-cn_multisp_pretrain_16k/basemodel_16k/sambert/config.yaml --root_dir training_stage/SSB0009_feats --stage_dir training_stage/SSB0009_sambert_ckpt./SSB0009_sambert_ckpt
├── ckpt/
├── checkpoint_1100000.pth <----- this is the latest checkpoint
├── checkpoint_1020000.pth
├── checkpoint_1040000.pth
|....
├── config.yaml
├── log/
└── stdout.log与声学模型类似,声码器的训练脚本也是配置驱动的,你可以使用预训练模型目录下的hifigan/config.yaml作为训练配置文件,另外声学模型和声码器的微调并没有依赖关系,两者可以同时进行。
我们希望在basemodel 2000k steps的基础上再微调100k steps, 但不保留state,修改hifigan/config.yaml配置项train_max_steps
# 将train_max_steps改为100100
...
train_max_steps: 100100
...
运行以下命令进行训练:
CUDA_VISIBLE_DEVICES=0 python kantts/bin/train_hifigan.py --model_config speech_sambert-hifigan_tts_zh-cn_multisp_pretrain_16k/basemodel_16k/hifigan/config.yaml --root_dir training_stage/SSB0009_feats --stage_dir training_stage/SSB0009_hifigan_ckpt声码器需要的微调时间较长,根据GPU型号不同在12~20小时不等。
训练完成后,声码器模型输出目录如下:
.
├── ckpt/
│   ├── checkpoint_2020000.pth
│   ├── checkpoint_2040000.pth
│   ├── ...
│   └── checkpoint_2100000.pth      <---- this is the latest checkpoint
├── config.yaml
├── log/
└── stdout.log▏体验模型效果
在声学模型和声码器微调完毕后,我们就可以使用产出的模型文件来合成语音了,在此之前需要做一些准备工作。
将我们想要合成的文本写入一个文件test.txt,每句话按行分隔,如下所示:
徐玠诡谲多智,善揣摩,知道徐知询不可辅佐,掌握着他的短处以归附徐知诰。
许乐夫生于山东省临朐县杨善镇大辛庄,毕业于抗大一分校。
宣统元年(1909年),顺德绅士冯国材在香山大黄圃成立安洲农务分会,管辖东海十六沙,冯国材任总理。
学生们大多住在校区宿舍,通过参加不同的体育文化俱乐部及社交活动,形成一个友谊长存的社会圈。
学校的“三节一会”(艺术节、社团节、科技节、运动会)是显示青春才华的盛大活动。
雪是先天自闭症患者,不懂与人沟通,却拥有灵敏听觉,而且对复杂动作过目不忘。
勋章通过一柱状螺孔和螺钉附着在衣物上。
运行以下命令进行合成:
CUDA_VISIBLE_DEVICES=0 python kantts/bin/text_to_wav.py --txt test.txt --output_dir res/SSB0009_syn --res_zip speech_sambert-hifigan_tts_zh-cn_multisp_pretrain_16k/resource.zip --am_ckpt training_stage/SSB0009_sambert_ckpt/ckpt/checkpoint_1100000.pth --voc_ckpt training_stage/SSB0009_hifigan_ckpt/ckpt/checkpoint_2100000.pth --speaker SSB0009res/SSB0009_syn/res_wavs文件夹下就可以获得合成结果│ ├── 8_0_dur.txt
│ ├── 8_0_energy.txt
│ ├── 8_0_f0.txt
│ ├── 8_0_mel.npy
│ ├── 8_1_dur.txt
│ ├── 8_1_energy.txt
│ ├── 8_1_f0.txt
│ └── 8_1_mel.npy
├── res_wavs
│ ├── 0.wav
│ ├── 1.wav
│ ├── 2.wav
│ ├── 3.wav
│ ├── 4.wav
│ ├── 5.wav
│ ├── 6.wav
├── stdout.log
└── symbols.lst
以下分别为原始录音及合成样音
原始录音
合成样音
ModelScope语音合成模型原理
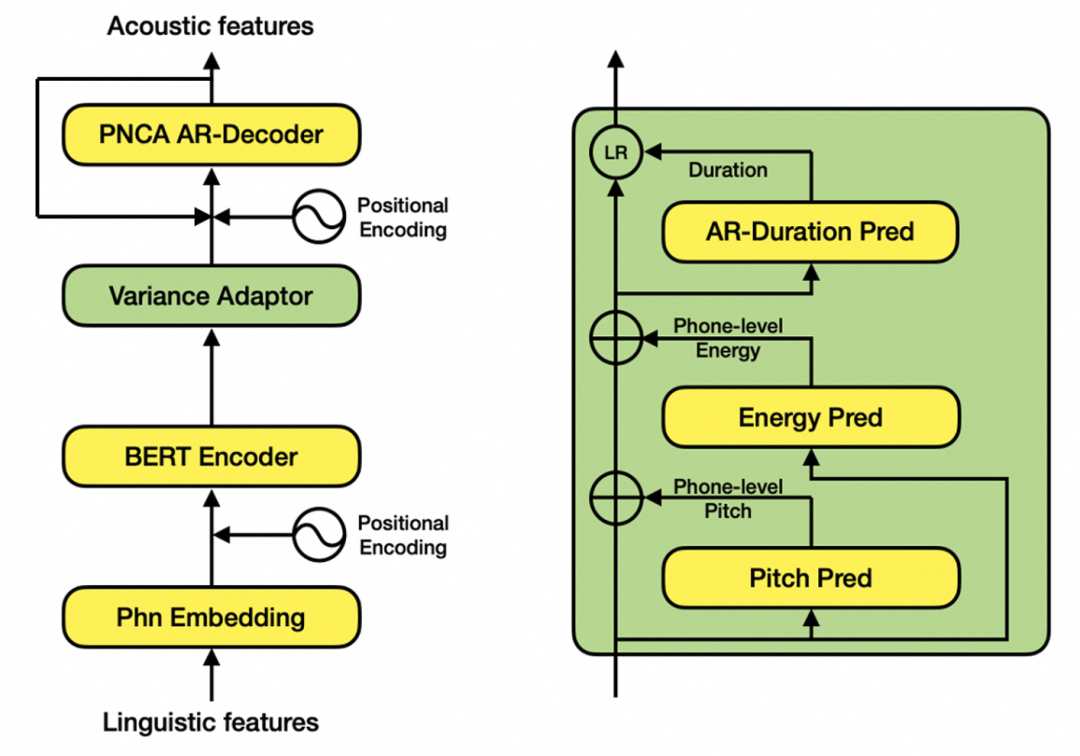
在ModelScope魔搭社区上大家体验到的语音合成技术是达摩院语音实验室显式韵律声学模型SAMBERT以及HiFi-GAN声码器的结合。
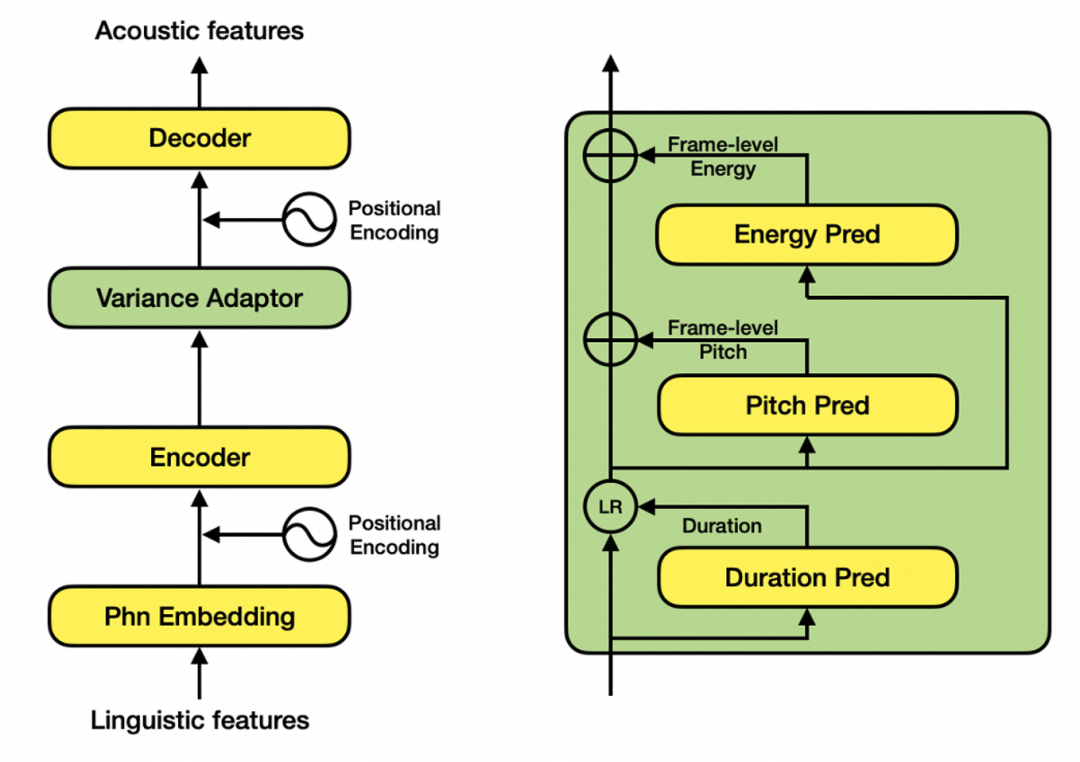
在语音合成领域,类似FastSpeech2的Parallel模型是目前的主流,它针对基频(pitch)、能量(energy)和时长(duration)三种韵律表征分别建模。但是,该类模型普遍存在一些效果和性能上的问题,例如,独立建模时长、基频、能量,忽视了其内在联系;完全非自回归的网络结构,无法满足工业级实时合成需求;帧级别基频和能量预测不稳定。
因此达摩院语音实验室设计了SAMBERT,一种基于Parallel结构的改良版TTS模型,它具有以下优点:
建立时长与基频、能量的依赖关系,并使用自回归结构的时长预测模块,提升预测韵律的自然度和多样性;
Decoder使用PNCA自回归结构,降低带宽要求,支持CPU实时合成;
音素级别建模基频、能量,提高容错率;
以预训练BERT语言模型为编码器,在小规模数据上效果更好。
联系我们
使用中如遇到任何问题,欢迎通过ModelScope社区与我们互动。
https://developer.aliyun.com/community/modelscope
(扫描上方二维码或输入网址即可联系我们)
